
HDFS概述
HDFS概述
作者:尹正杰
版权声明:原创作品,谢绝转载!否则将追究法律责任。
一.HDFS产出背景及定义
1>.HDFS产生背景
随着数据量越来越大,在一个操作系统存不下所有的数据,那么就分配到更多的操作系统管理磁盘中,但是不方便维护和管理,迫切需求一种系统来管理多台机器上的文件,这就是分布式文件管理系统。HDFS只是分布式文件管理系统中的一种。
2>.HDFS定义
HDFS全称为:Hadoop Distributed File System,它是一个文件系统,用于存储文件,通过目录树来定位;其次,他是分布式的,由很多服务联合起来实现其功能,集群中的服务器有各自的角色。
3>.HDFS的使用场景
适合一次写入,多次读出的场景,且不支持文件的修改。适合用来做数据分析,并不适合用来做网盘应用。
二.HDFS优缺点
1>.优点
一.高容错性

>.数据自动保存多个副本,它通过增加副本的形式,提高容错性;

>.某一个副本丢失以后,它可以自动恢复;

二.适合处理大数据

>.数据规模:能够处理数据规模达到GB,TB,甚至PB级别的数据;

>.文件规模:能够处理百万规模以上的文件数量,数量相当之大;

三.可构建在廉价机器上,通过多副本机智,提高可靠性。
2>.缺点
一.不适合低延迟数据访问,比如毫秒级的存储数据,是做不到的;

二.无法高效的对大量小文件进行存储

>.存储大量小文件的话,他会占用NameNode大量的内存来存储文件目录块信息。这样是不可取的,因为NameNode的内存总是有限的;

>.小文件存储的寻址时间会超过读取时间,它违反了HDFS的设计目标;

三.不支持并发写入,文件随机修改

>.一个文件只能有一个写,不允许多个线程同时写;

>.仅支持数据append(追加),不支持文件的随机修改。
三.HDFS组成架构
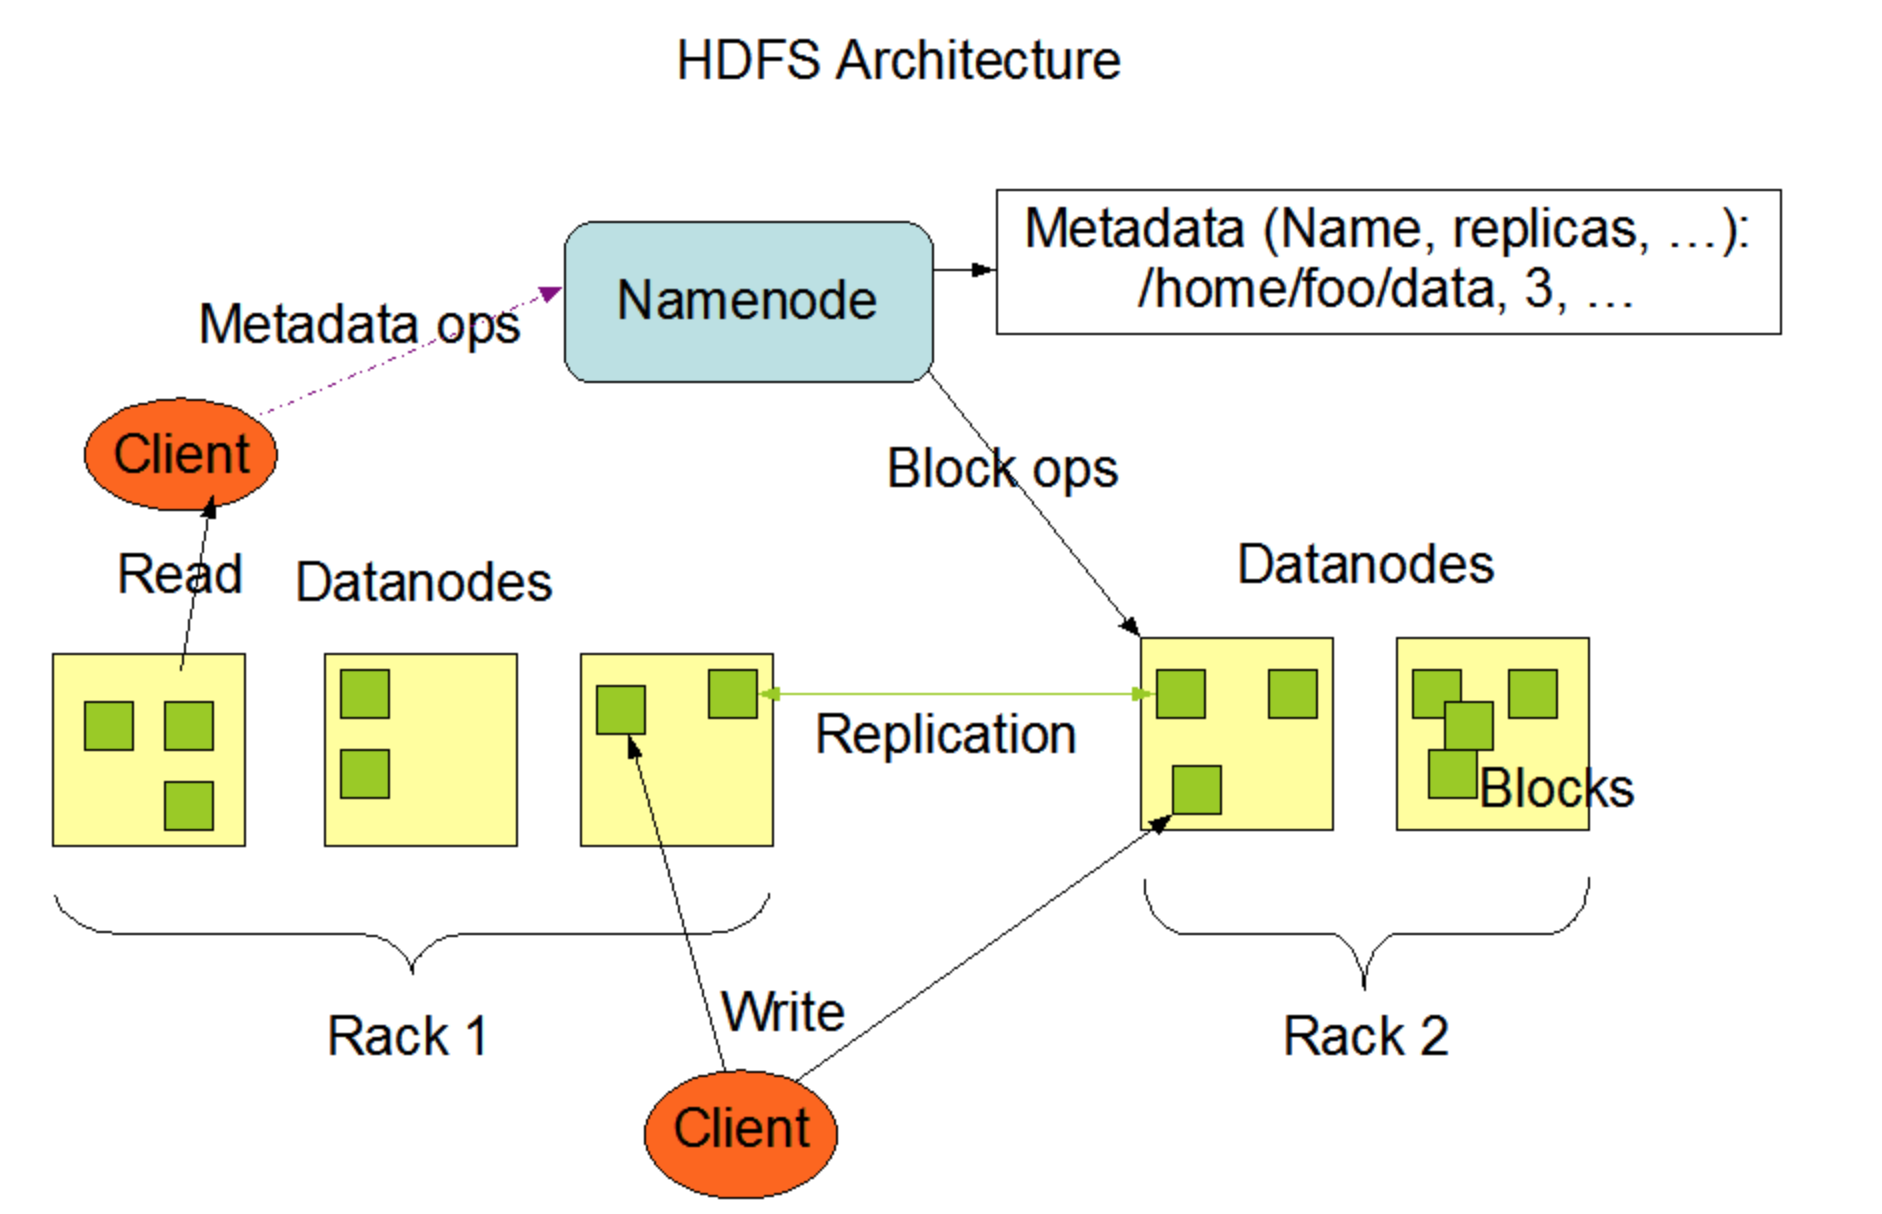
一.NameNode

    就是Master,他是一个主管,管理者。

>.管理HDFS的名称空间;

>.配置副本策略;

>.管理数据块(Block)映射信息;

>.处理客户端读写请求;

二.DataNode

    就是Slave。NameNode下达命令,DataNode执行实际的操作。

>.存储实际的数据块;

>.执行数据块的读/写操作;

三.Client

    就是客户端。

>.文件切分,文件上传HDFS的时候,Client将文件切分成一个一个的Block,然后进行上传;

>.与NameNode交互,获取文件的位置信息;

>.与Datanode交互,读取或者写入数据;

>.Client提供一些命令来管理HDFS,比如NameNode格式化;

>.Client可以通过一些命令来访问HDFS,比如对HDFS增删改查操作;

四.Secondary NameNode

    并非NameNode的热备,当NameNode刮掉的时候,它并不能马上替换NameNode并提供服务。

>.辅助NameNode,分担其工作量,比如定期合并Fsimage和Edits,并推送给NameNode;

>.在紧急情况下,可辅助恢复NameNode;
四.HDFS文件块大小
HDFS中文件在物理上是分块存储(Block),块的大小可以通过配置参数(dfs.blocksize)来规定,默认大小在Hadoop2.x版本是128M,在Hadoop1.x版本中是64M。
一.为什么Hadoop2.x版本中是128M

    >.如果寻址时间为10ms,即查找到目标的bolck的时间为10ms;

    >.寻址时间为传输时间的1%时,则为最佳状态。因此,传输时间=寻址时间/0.01=10ms/0.01=1000ms=1s

    >.而目前磁盘的传输速度普遍为100MB/s

    >.因此block的大小为=1s*100MB/s=100M

    >.这个100M在外国的程序员无法用二进制表示,于是开发人员为了方便好记就找了一个二进制和改制相似的数字设置为默认值,因此Hadoop默认的大小为128MB。当然,这是为脑补出来的答案,哈哈哈~

二.为什么块的大小不能设置太小,也不能设置太大?

>.HDFS的块设置太小,会增加寻址时间,呈现一直在找块的开始位置;

>.如果块设置的太大,从磁盘传输数据的时间会明显大雨定位这个块开始位置所需的时间。导致程序在处理这块数据时,会非常慢。

总结:HDFS块的大小设置,主要取决于磁盘传输速度。随着科技的发展,磁盘的速度在不久的将来也会有所提高的,而Hadoop的版本默认值也会在不断的变大,这是很合理的。
关于如何测试磁盘的读写速度,可参考我之前的笔记:https://www.cnblogs.com/yinzhengjie/p/9935478.html。
HDFS概述的更多相关文章
- HDFS概述(一)
HDFS概述(一) 1. HDFS产出的背景及定义 1.1 HDFS产生的背景 随着数据量越来越大,在一个操作系统存不下所有的数据,那么就分配到更多的操作系统管理的磁盘中,但是不方便管理和维护,迫切需 ...
- HDFS概述和Shell操作
大数据技术之Hadoop(HDFS) 第一章 HDFS概述 HDFS组成架构 HDFS文件块大小 第二章 HDFS的Shell操作(开发重点) 1.基本语法 bin/hadoop fs 具体命令 ...
- HDFS概述(6)————用户手册
目的 本文档是使用Hadoop分布式文件系统(HDFS)作为Hadoop集群或独立通用分布式文件系统的一部分的用户的起点.虽然HDFS旨在在许多环境中"正常工作",但HDFS的工作 ...
- HDFS概述(5)————HDFS HA
HA With QJM 目标 本指南概述了HDFS高可用性(HA)功能以及如何使用Quorum Journal Manager(QJM)功能配置和管理HA HDFS集群. 本文档假设读者对HDFS集群 ...
- HDFS概述(4)————HDFS权限
概述 Hadoop分布式文件系统(HDFS)的权限模型与POSIX模型的文件和目录权限模型一致.每个文件和目录与所有者和组相关联.该文件或目录将权限划分为所有者的权限,作为该组成员的其他用户的权限.以 ...
- HDFS概述(3)————HDFS Federation
本指南概述了HDFS Federation功能以及如何配置和管理联合集群. 当前HDFS背景 HDFS主要有两层: 1.Namespace (1)包含目录,文件和块. (2)它支持所有命名空间相关的文 ...
- HDFS概述(1)————HDFS架构
概述 Hadoop分布式文件系统(HDFS)是一种分布式文件系统,用于在普通商用硬件上运行.它与现有的分布式文件系统有许多相似之处.然而,与其他分布式文件系统的区别很大.HDFS具有高度的容错能力,旨 ...
- HDFS概述(2)————Block块大小设置
以下内容转自:http://blog.csdn.net/samhacker/article/details/23089157?utm_source=tuicool&utm_medium=ref ...
- Hadoop之HDFS概述
一.HDFS产生背景及定义 1.HDFS产生背景 随着数据量越来越大,在一个操作系统存不下所有的数据,那么就分配到更多的操作系统管理的磁盘中,但是不方便管理和维护,迫切需要一种系统来管理多台机器上的文 ...
随机推荐
- android添加阴影
android底部增加背景 <?xml version="1.0" encoding="utf-8"?> <layer-list xmlns: ...
- 使用 prismjs 在网页中高亮显示代码
最近在总结这一年来制作的网页模块,网站风格统一的情况下,网站页面结构不会改变,因此想记录一部分网站中统一的结构,方便日后维护. 用到的相关技术: vue, element-ui, prismjs, v ...
- Jmeter Beanshell 用法
Beanshell 的用法 什么是beanshell Beanshell是一种完全符合java语法的脚本语言,并且拥有自己的内置对象和语法 Beanshell是用java写的,一个小型嵌入式java源 ...
- windows本地远程虚拟机docker中的数据的问题
关闭各种防火墙 打开宿主机(windows)的cmd,在其中添加通往192.168.1.0/24网络的路由. 通往192.168.1.0/24网络的数据包由172.20.1.12来转发 route a ...
- Linux 下查看字体
1.查看所有字体 命令:fc-list 2.查看中文字体 命令:fc-list :lang=zh 3.查看更多字体 命令:fc-match -v "AR PL UKai CN"
- 记录学习antd design pro dva的过程,主要记错, 多图预警,如有理解偏差,忘指出,多谢!
首要问题: 如何增加菜单项 答案: 在router.config中添加路由,在locales语言国际化增加选项 问题1: 答案1: 问题2: 这个要修改state,正确写法 存在的疑惑:为什么不能直接 ...
- mysql中将多行数据合并成一行数据
.1GROUP_CONCAT()中的值为你要合并的数据的字段名; SEPARATOR 函数是用来分隔这些要合并的数据的: ' '中是你要用哪个符号来分隔: 2.必须要用GROUP BY 语句来进行分组 ...
- 最大k乘积问题
68.最大k乘积问题 (15分)C时间限制:3000 毫秒 | C内存限制:3000 Kb题目内容:设I是一个n位十进制整数.如果将I划分为k段,则可得到k个整数.这k个整数的乘积称为I的一个k乘积. ...
- MapReduce实例——求平均值,所得结果无法写出到文件的错误原因及解决方案
1.错误原因 mapreduce按行读取文本,map需要在原有基础上增加一个控制语句,使得读到空行时不执行write操作,否则reduce不接受,也无法输出到新路径. 2.解决方案 原错误代码 pub ...
- WMI Explorer操作 和 powershell命令
powershell查看wmi root 空间 PS C:\Users\yyy> Get-WmiObject -Class __namespace -Namespace root | selec ...