
大数据ssh疑点跟踪
相信运维的对ssh免密登陆应该是对这个再清楚不过的吧,由于我们大数据对于安全这方便管控的很严格,单独找一台物理机作为跳板机,其他的机器都必须要从这个跳板机免密登陆,由于机器比较的多,其中dn30这个域名ssh无法登陆,但是对应的IP地址是可以正常ssh免密登陆的,如图1所示:

【图1】
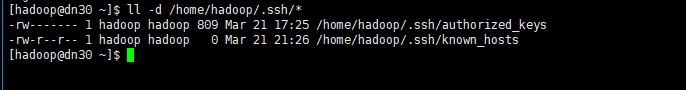
我检查了一下目标端dn30的authorized_keys内容,cm跳板的hadoop的公钥已经给了dn30,这一点没毛病呀,再检查ssh目录以及下面的文件权限也没问题呀(如图2所示),究竟什么情况能导致这个问题呢?
【图2】
最后查看了dn30的known_hosts的内容,发现里面记录的竟然是search03的ssh连接秘钥对,而search03的known_hosts记录的却是dn30的ssh连接秘钥对;两台机器与本地的域名不一致,为什么会这样呢?这才记起来,原来这两台机器装完之后,已经做了ssh域名免密登陆,现在的这个dn30机器应该是search03,而search03应该是dn30,因为dn30硬盘故障,是后面恢复的,所以域名解析互换了,但是秘钥对还保存在know_hosts里面,知道了原因,这就好办了,我们直接登陆到两台机器上直接rm -rf /home/hadoop/.ssh/known_hosts或者>/home/hadoop/.ssh/known_hosts清空。
随后我们在尝试ssh dn30,还是不行,难道这不是根本原因吗?目标端的不是已经清空了knows_hosts对应的ssh连接信息吗?
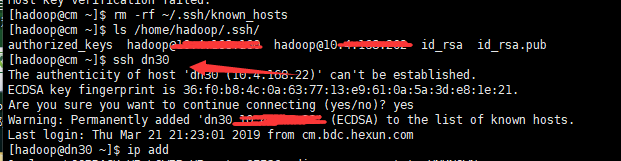
其实细心的同学们会发现,源端还是有个knows_hosts,这里面才是真正记录ssh免密远端主机的秘钥认证信息(如图3所示),我们只有清理源端的knows_hosts的信息才能真正的解决问题
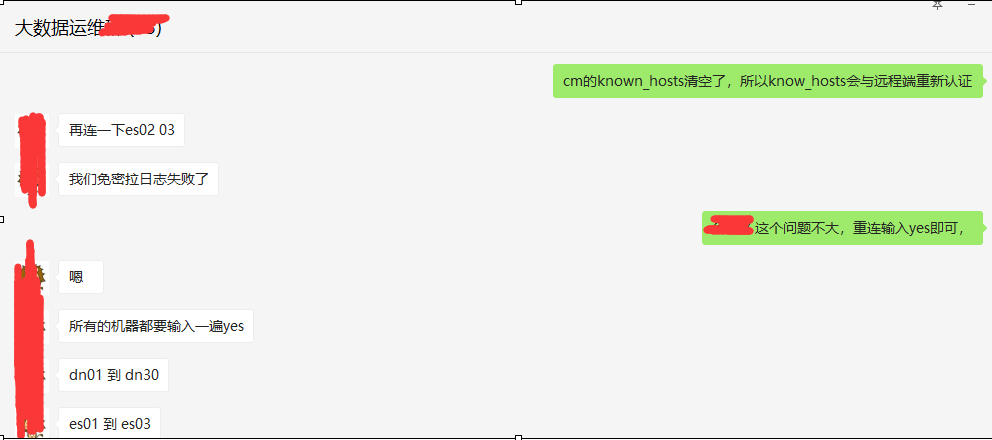
注意,这里千万别不要rm -rf knows_host或者>knows_hosts,这样的话里面记录所有的机器都需要重新认证,虽然问题不是很大,但是这样线上某些严格依赖ssh域名免密的程序就会收到影响(我就这样背一次锅,血的教训,不但要重新认证,还要被训一下,哎!如图4所示)

【图3】
【图4】
最后我们在尝试ssh dn30免密成功~
【小结】
一台主机上有多个Linux系统,会经常切换,那么这些系统使用同一ip,登录过一次后就会把ssh信息记录在本地的~/.ssh/known_hsots文件中,切换该系统后再用ssh访问这台主机就会出现冲突警告,需要手动删除修改known_hsots里面的内容
ssh会把你每个你访问过计算机的公钥(public key)都记录在~/.ssh/known_hosts。当下次访问相同计算机时,OpenSSH会核对公钥。如果公钥不同,OpenSSH会发出警告, 避免你受到DNS Hijack之类的攻击。
虽然是小技术点,但以小见大,很多细节性的问题还是得多注意,稍微不注意,线上操作需谨慎,切勿冲动!
大数据ssh疑点跟踪的更多相关文章
- 大数据【一】集群配置及ssh免密认证
八月迷情,这个月会对大数据进行一个快速的了解学习. 一.所需工具简介 首先我是在大数据实验一体机上进行集群管理学习,管理五台实验机,分别为master,slave1,slave2,slave3,cli ...
- 使用tar+pigz+ssh实现大数据的高效传输
以前我们跨主机拷贝大数据的时候,比如要拷贝超过100GB的mysql原始数据,我们通常的做法如下: 在源端打包压缩为tar.gz文件 采用scp或者rsync等方式拷贝到目标主机 在目标主机解压文件 ...
- Spark大数据针对性问题。
1.海量日志数据,提取出某日访问百度次数最多的那个IP. 解决方案:首先是将这一天,并且是访问百度的日志中的IP取出来,逐个写入到一个大文件中.注意到IP是32位的,最多有个2^32个IP.同样可以采 ...
- java 与大数据学习较好的网站
C# C#中 Thread,Task,Async/Await,IAsyncResult 的那些事儿!https://www.cnblogs.com/doforfuture/p/6293926.html ...
- 【学习笔记】大数据技术原理与应用(MOOC视频、厦门大学林子雨)
1 大数据概述 大数据特性:4v volume velocity variety value 即大量化.快速化.多样化.价值密度低 数据量大:大数据摩尔定律 快速化:从数据的生成到消耗,时间窗口小,可 ...
- 大数据(hadoop)
大数据 一.概述 二.大数据特点 三.大数据部门组织结构 hadoop框架 一.hadoop是什么 Hadoop是一个由Apache基金会所开发的分布式系统基础架构. 主要解决,海量数据的存储和海量数 ...
- ElasticSearch大数据分布式弹性搜索引擎使用
阅读目录: 背景 安装 查找.下载rpm包 .执行rpm包安装 配置elasticsearch专属账户和组 设置elasticsearch文件所有者 切换到elasticsearch专属账户测试能否成 ...
- 大数据系列(4)——Hadoop集群VSFTP和SecureCRT安装配置
前言 经过前三篇文章的介绍,已经通过VMware安装了Hadoop的集群环境,当然,我相信安装的过程肯定遇到或多或少的问题,这些都需要自己解决,解决的过程就是学习的过程,本篇的来介绍几个Hadoop环 ...
- 大数据系列(3)——Hadoop集群完全分布式坏境搭建
前言 上一篇我们讲解了Hadoop单节点的安装,并且已经通过VMware安装了一台CentOS 6.8的Linux系统,咱们本篇的目标就是要配置一个真正的完全分布式的Hadoop集群,闲言少叙,进入本 ...
随机推荐
- Django 中使用ImgFiled 和FileFiled
1.使用ImgFiled class ImageField(upload_to=None, height_field=None, width_field=None, max_length=100, * ...
- 第一周java学习总结
学号 20175206 <Java程序设计>第一周学习总结 教材学习内容总结 第一章是关于JAVA入门的注意事项: 第一章主要按照顺序讲了JAVA的地位,诞生,特点,JDK的安装,一些ja ...
- CMakeList.txt(3): 一个cmake实例
介绍一个比较实用的例子,即包含生成静态库又包含引入外部头文件和链接库的cmake demo. 先按照工程规范建立工程目录,并编写代码,以下面的工程目录为例进行解释这个例子,工程的目录结构为: 1. 编 ...
- SpringBoot注册Windows服务和启动报错的原因
SpringBoot注册Windows服务和启动报错的原因 Windows系统启动Java程序会弹出黑窗口.黑窗口有几点不好.首先它不美观:其次容易误点导致程序关闭:但最让我匪夷所思的是:将鼠标光标选 ...
- 【Unity游戏开发】你真的了解UGUI中的IPointerClickHandler吗?
一.引子 马三在最近的开发工作中遇到了一个比较有意思的bug:“TableViewCell上面的某些自定义UI组件不能响应点击事件,并且它的父容器TableView也不能响应点击事件,但是TableV ...
- 编译VisualVM源码解决乱码问题
编译VisualVM源码解决乱码问题 起因 今天在使用VisualVM对测试服务器进行JVM监控的时候,发现所有统计图的横纵坐标都是显示乱码(小方块),即使我的Ubuntu系统使用的是英文语言环境.奇 ...
- 使用百度云 BOS 和 C# SDK 开发数据存储
Ø 简介 本文主要介绍如何使用百度云的 C# SDK 操作 BOS(Baidu Object Storage/百度对象存储),以及常见问题和解决办法.本文将以以下几点展开学习: 1. 基本介绍 ...
- Unknown system variable 'query_cache_size'] with root cause
Unknown system variable 'query_cache_size'] with root cause 出现这个错误是因为mysql连接数据库的版本不对, mysql-connecto ...
- JavaScript之iframe页面间通信
[1] iframe父子页面间通信 1.相互调用对方的方法 |> 子级页面调用父级页面 window.parent.父级页面方法(args) |> 父级页面调用子级页面 document. ...
- Redis的集群搭建
一.集群的搭建 1.准备工作 (1)安装ruby环境 redis集群管理工具redis-trib.rb依赖ruby环境,首先需要安装ruby环境: yum -y install ruby yum -y ...