
Guava 源码分析(Cache 原理)
前言
Google 出的 Guava 是 Java 核心增强的库,应用非常广泛。
我平时用的也挺频繁,这次就借助日常使用的 Cache 组件来看看 Google 大牛们是如何设计的。
缓存
本次主要讨论缓存。
缓存在日常开发中举足轻重,如果你的应用对某类数据有着较高的读取频次,并且改动较小时那就非常适合利用缓存来提高性能。
缓存之所以可以提高性能是因为它的读取效率很高,就像是 CPU 的 L1、L2、L3 缓存一样,级别越高相应的读取速度也会越快。
但也不是什么好处都占,读取速度快了但是它的内存更小资源更宝贵,所以我们应当缓存真正需要的数据。
其实也就是典型的空间换时间。
下面谈谈 Java 中所用到的缓存。
JVM 缓存
首先是 JVM 缓存,也可以认为是堆缓存。
其实就是创建一些全局变量,如 Map、List 之类的容器用于存放数据。
这样的优势是使用简单但是也有以下问题:
- 只能显式的写入,清除数据。
- 不能按照一定的规则淘汰数据,如
LRU,LFU,FIFO等。 - 清除数据时的回调通知。
- 其他一些定制功能等。
Ehcache、Guava Cache
所以出现了一些专门用作 JVM 缓存的开源工具出现了,如本文提到的 Guava Cache。
它具有上文 JVM 缓存不具有的功能,如自动清除数据、多种清除算法、清除回调等。
但也正因为有了这些功能,这样的缓存必然会多出许多东西需要额外维护,自然也就增加了系统的消耗。
分布式缓存
刚才提到的两种缓存其实都是堆内缓存,只能在单个节点中使用,这样在分布式场景下就招架不住了。
于是也有了一些缓存中间件,如 Redis、Memcached,在分布式环境下可以共享内存。
具体不在本次的讨论范围。
Guava Cache 示例
之所以想到 Guava 的 Cache,也是最近在做一个需求,大体如下:
从 Kafka 实时读取出应用系统的日志信息,该日志信息包含了应用的健康状况。
如果在时间窗口 N 内发生了 X 次异常信息,相应的我就需要作出反馈(报警、记录日志等)。
对此 Guava 的 Cache 就非常适合,我利用了它的 N 个时间内不写入数据时缓存就清空的特点,在每次读取数据时判断异常信息是否大于 X 即可。
伪代码如下:
    @Value("${alert.in.time:2}")

    private int time ;

    @Bean

    public LoadingCache buildCache(){

        return CacheBuilder.newBuilder()

                .expireAfterWrite(time, TimeUnit.MINUTES)

                .build(new CacheLoader<Long, AtomicLong>() {

                    @Override

                    public AtomicLong load(Long key) throws Exception {

                        return new AtomicLong(0);

                    }

                });

    }

    /**

     * 判断是否需要报警

     */

    public void checkAlert() {

        try {

            if (counter.get(KEY).incrementAndGet() >= limit) {

                LOGGER.info("***********报警***********");

                //将缓存清空

                counter.get(KEY).getAndSet(0L);

            }

        } catch (ExecutionException e) {

            LOGGER.error("Exception", e);

        }

    }
首先是构建了 LoadingCache 对象,在 N 分钟内不写入数据时就回收缓存(当通过 Key 获取不到缓存时,默认返回 0)。
然后在每次消费时候调用 checkAlert() 方法进行校验,这样就可以达到上文的需求。
我们来设想下 Guava 它是如何实现过期自动清除数据,并且是可以按照 LRU 这样的方式清除的。
大胆假设下:
内部通过一个队列来维护缓存的顺序,每次访问过的数据移动到队列头部,并且额外开启一个线程来判断数据是否过期,过期就删掉。有点类似于我之前写过的 动手实现一个 LRU cache
胡适说过:大胆假设小心论证
下面来看看 Guava 到底是怎么实现。
原理分析
看原理最好不过是跟代码一步步走了:
示例代码在这里:
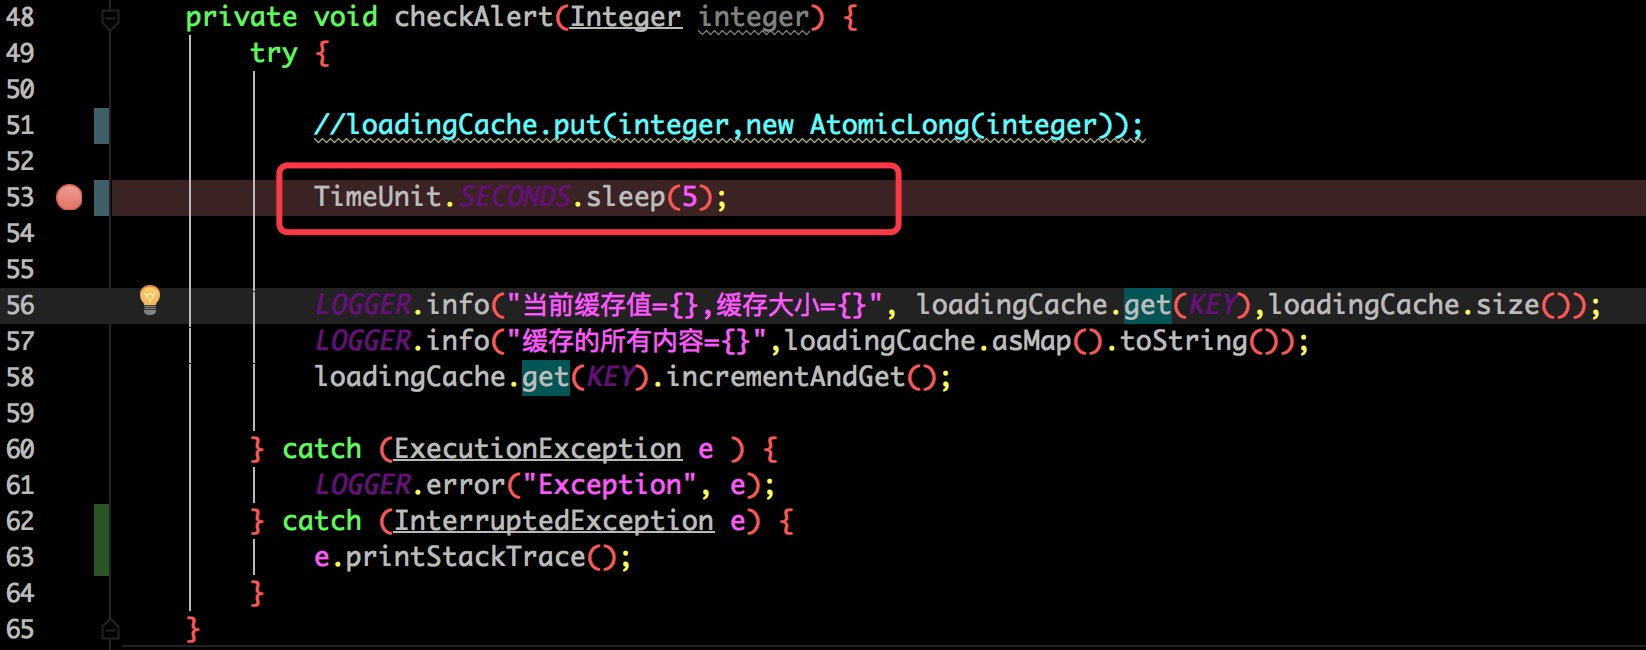
为了能看出 Guava 是怎么删除过期数据的在获取缓存之前休眠了 5 秒钟,达到了超时条件。
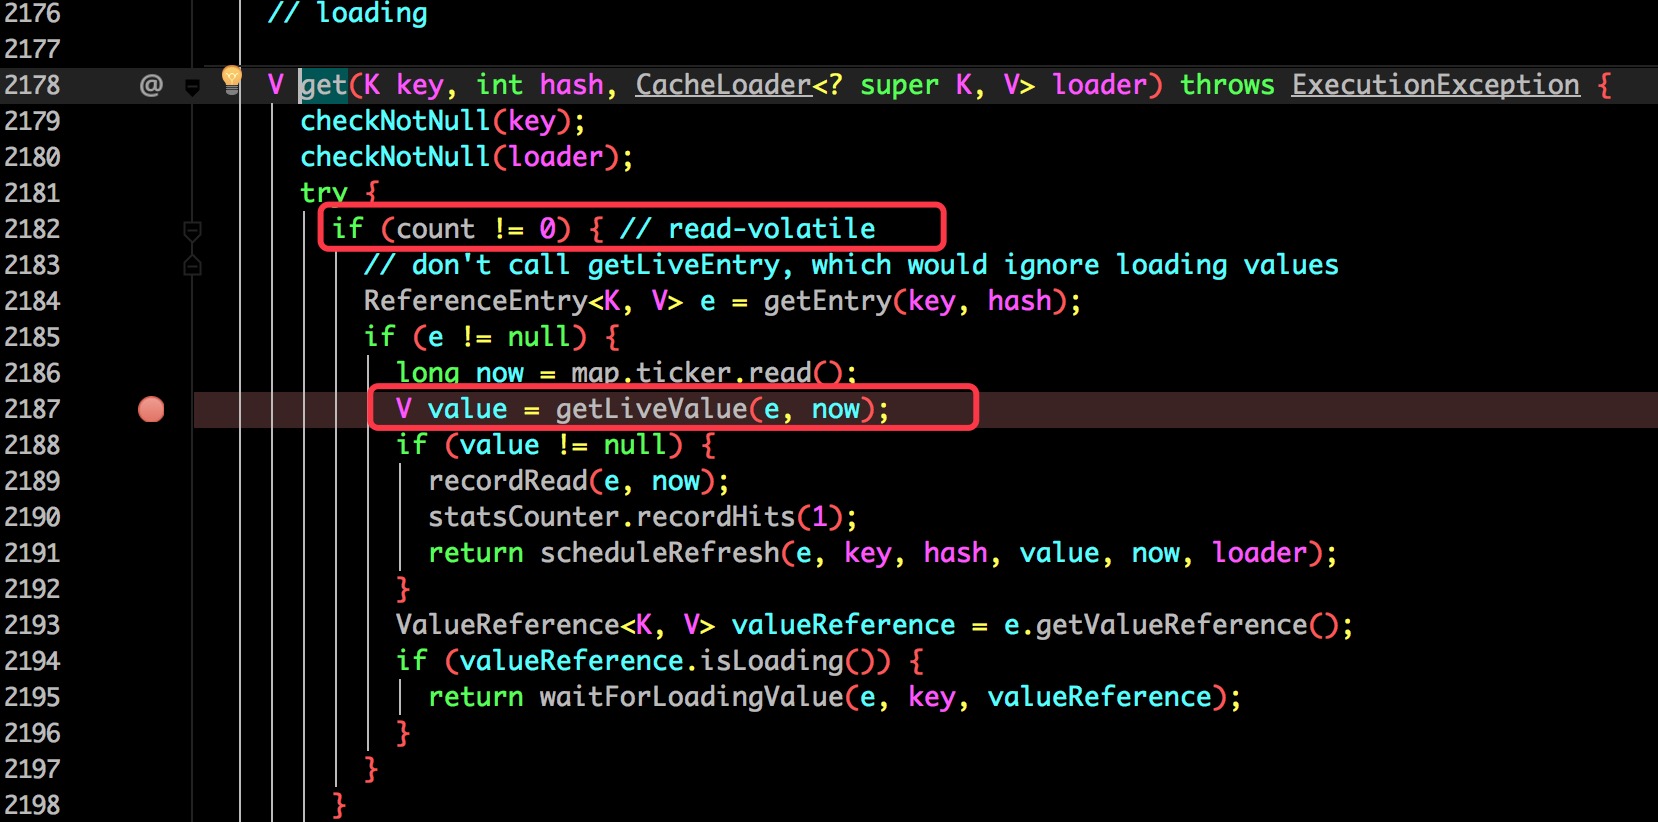
最终会发现在 com.google.common.cache.LocalCache 类的 2187 行比较关键。
再跟进去之前第 2182 行会发现先要判断 count 是否大于 0,这个 count 保存的是当前缓存的数量,并用 volatile 修饰保证了可见性。
更多关于 volatile 的相关信息可以查看 你应该知道的 volatile 关键字
接着往下跟到:
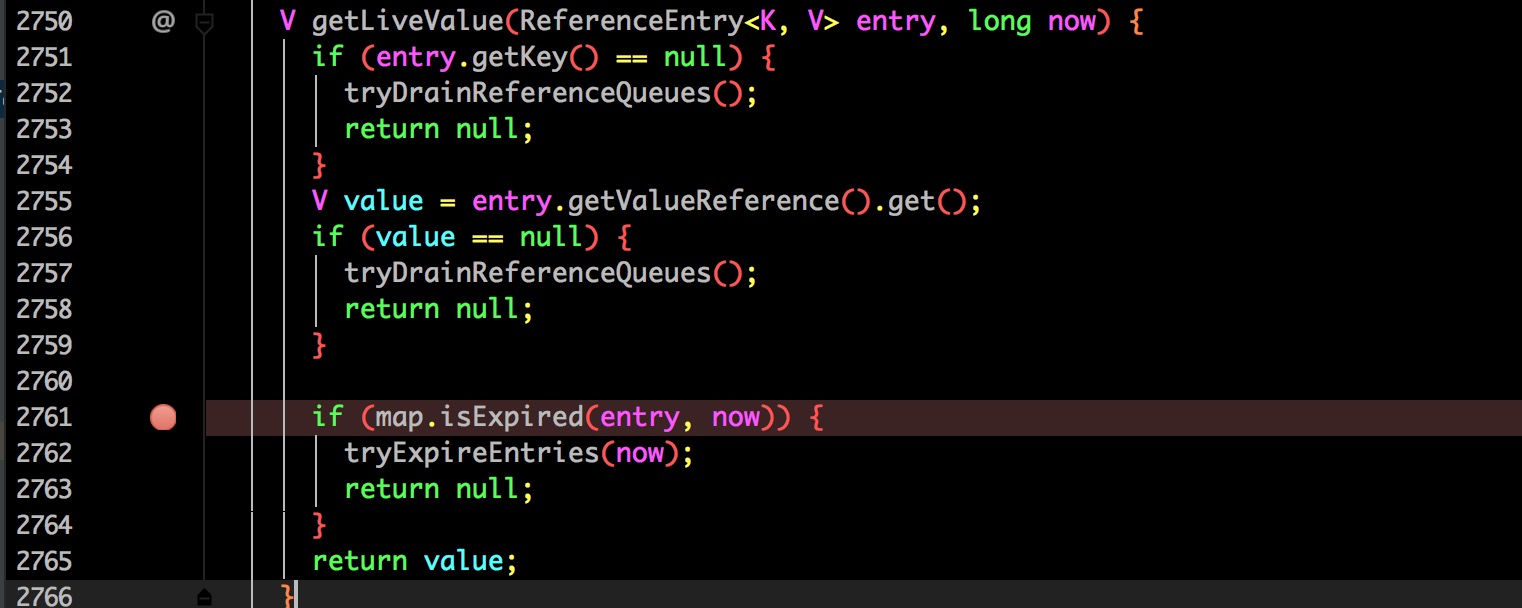
2761 行,根据方法名称可以看出是判断当前的 Entry 是否过期,该 entry 就是通过 key 查询到的。

这里就很明显的看出是根据根据构建时指定的过期方式来判断当前 key 是否过期了。
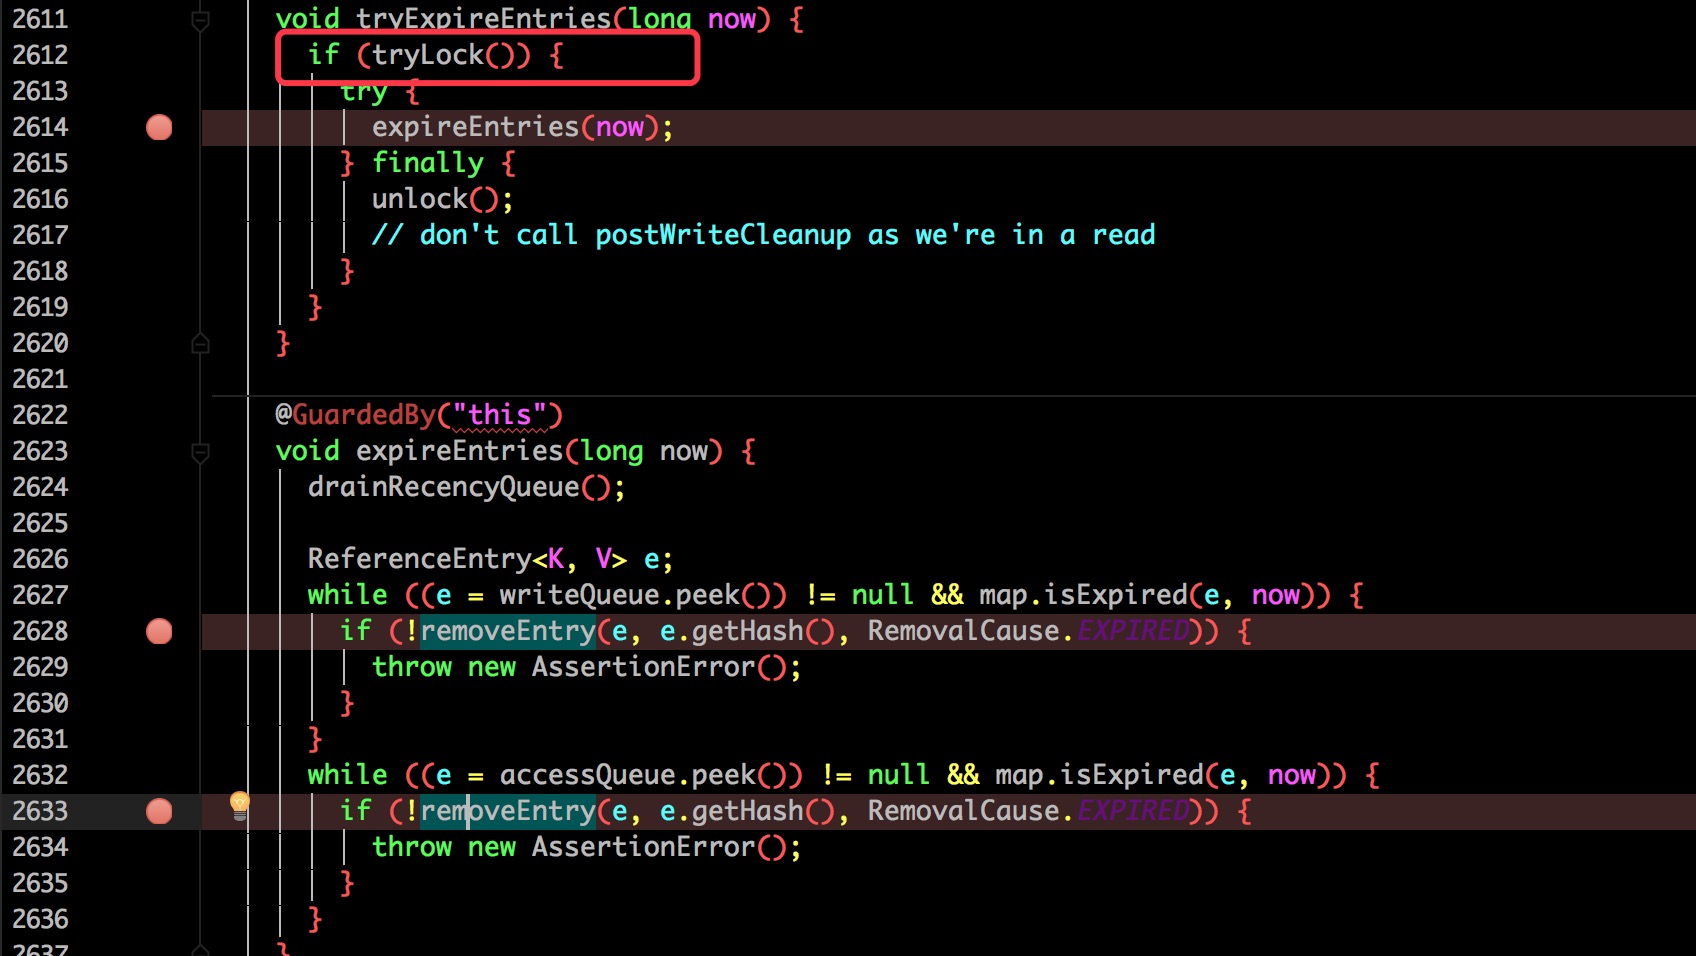
如果过期就往下走,尝试进行过期删除(需要加锁,后面会具体讨论)。
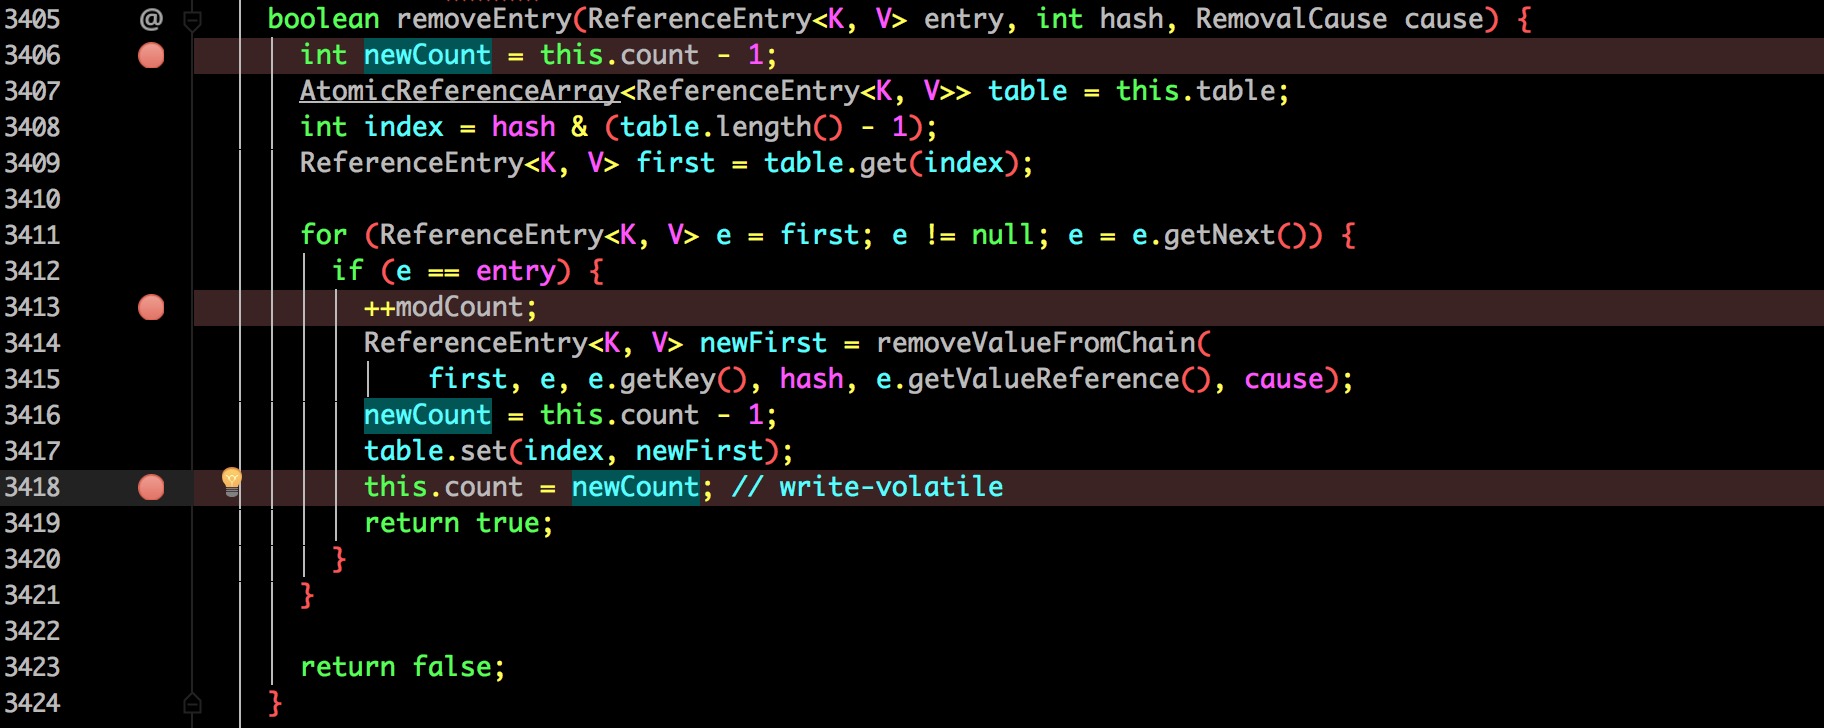
到了这里也很清晰了:
- 获取当前缓存的总数量
- 自减一(前面获取了锁,所以线程安全)
- 删除并将更新的总数赋值到 count。
其实大体上就是这个流程,Guava 并没有按照之前猜想的另起一个线程来维护过期数据。
应该是以下原因:
- 新起线程需要资源消耗。
- 维护过期数据还要获取额外的锁,增加了消耗。
而在查询时候顺带做了这些事情,但是如果该缓存迟迟没有访问也会存在数据不能被回收的情况,不过这对于一个高吞吐的应用来说也不是问题。
总结
最后再来总结下 Guava 的 Cache。
其实在上文跟代码时会发现通过一个 key 定位数据时有以下代码:
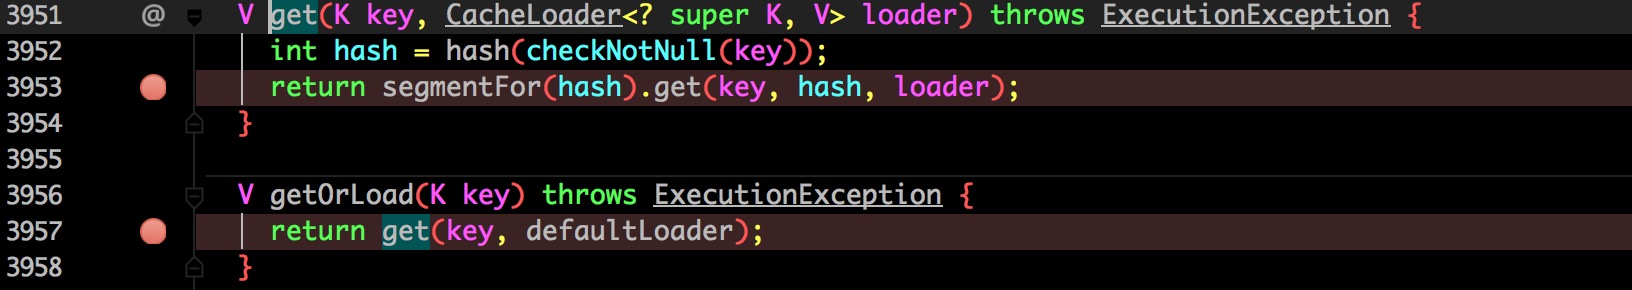
如果有看过 ConcurrentHashMap 的原理 应该会想到这其实非常类似。
其实 Guava Cache 为了满足并发场景的使用,核心的数据结构就是按照 ConcurrentHashMap 来的,这里也是一个 key 定位到一个具体位置的过程。
先找到 Segment,再找具体的位置,等于是做了两次 Hash 定位。
上文有一个假设是对的,它内部会维护两个队列 accessQueue,writeQueue 用于记录缓存顺序,这样才可以按照顺序淘汰数据(类似于利用 LinkedHashMap 来做 LRU 缓存)。
同时从上文的构建方式来看,它也是构建者模式来创建对象的。
因为作为一个给开发者使用的工具,需要有很多的自定义属性,利用构建则模式再合适不过了。
Guava 其实还有很多东西没谈到,比如它利用 GC 来回收内存,移除数据时的回调通知等。之后再接着讨论。
最后插播个小广告:
Java-Interview 截止目前将近 8K star。

这次定个小目标:争取冲击 1W star。
感谢各位老铁的支持与点赞。
欢迎关注公众号一起交流:
Guava 源码分析(Cache 原理)的更多相关文章
- Guava 源码分析(Cache 原理 对象引用、事件回调)
前言 在上文「Guava 源码分析(Cache 原理)」中分析了 Guava Cache 的相关原理. 文末提到了回收机制.移除时间通知等内容,许多朋友也挺感兴趣,这次就这两个内容再来分析分析. 在开 ...
- Guava 源码分析之Cache的实现原理
Guava 源码分析之Cache的实现原理 前言 Google 出的 Guava 是 Java 核心增强的库,应用非常广泛. 我平时用的也挺频繁,这次就借助日常使用的 Cache 组件来看看 Goog ...
- MyBatis 源码分析 - 缓存原理
1.简介 在 Web 应用中,缓存是必不可少的组件.通常我们都会用 Redis 或 memcached 等缓存中间件,拦截大量奔向数据库的请求,减轻数据库压力.作为一个重要的组件,MyBatis 自然 ...
- Spring Boot 揭秘与实战 源码分析 - 工作原理剖析
文章目录 1. EnableAutoConfiguration 帮助我们做了什么 2. 配置参数类 – FreeMarkerProperties 3. 自动配置类 – FreeMarkerAutoCo ...
- Tomcat源码分析——请求原理分析(下)
前言 本文继续讲解TOMCAT的请求原理分析,建议朋友们阅读本文时首先阅读过<TOMCAT源码分析——请求原理分析(上)>和<TOMCAT源码分析——请求原理分析(中)>.在& ...
- Tomcat源码分析——请求原理分析(中)
前言 在<TOMCAT源码分析——请求原理分析(上)>一文中已经介绍了关于Tomcat7.0处理请求前作的初始化和准备工作,请读者在阅读本文前确保掌握<TOMCAT源码分析——请求原 ...
- Tomcat源码分析——请求原理分析(上)
前言 谈起Tomcat的诞生,最早可以追溯到1995年.近20年来,Tomcat始终是使用最广泛的Web服务器,由于其使用Java语言开发,所以广为Java程序员所熟悉.很多人早期的J2EE项目,由程 ...
- wifidog源码分析 - wifidog原理 tiger
转:http://www.cnblogs.com/tolimit/p/4223644.html wifidog源码分析 - wifidog原理 wifidog是一个用于配合认证服务器实现无线网页认证功 ...
- [Guava源码分析]ImmutableCollection:不可变集合
摘要: 我的技术博客经常被流氓网站恶意爬取转载.请移步原文:http://www.cnblogs.com/hamhog/p/3888557.html,享受整齐的排版.有效的链接.正确的代码缩进.更好的 ...
- [Guava源码分析]Ordering:排序
我的技术博客经常被流氓网站恶意爬取转载.请移步原文:http://www.cnblogs.com/hamhog/p/3876466.html,享受整齐的排版.有效的链接.正确的代码缩进.更好的阅读体验 ...
随机推荐
- Extjs4.2 GridPanel中显示单选按钮
效果:如上图. 代码:其中需要显示单选按钮的列 { dataIndex: 'FeeModel', text: '收費模式', flex: 1, align: 'left', radioValues: ...
- Sublime插件:Terminal
这几天在window环境下用gulp构建前端工程,切来切去浪费了不少时间(右键sublime菜单打开文件所在目录,然后去项目根目录,右键打开cmder).这点webstorm自带的Terminal真的 ...
- python书籍推荐:Head First Python(中文版)
所属网站分类: 资源下载 > python电子书 作者:熊猫烧香 链接:http://www.pythonheidong.com/blog/article/64/ 来源:python黑洞网,专注 ...
- input autocomplete属性设计输入框自动联想(php实现)
因为客户临时要求加一个输入框自动联想,就开始了解这块.结合网上总结最难的一点就是找好对应的js版本以及相应的jQuery-ui: 以下是我用的版本,以及连接地址: jQuery的js文件: <s ...
- MyBatis3系列__04CRUD以及参数处理
本文将会简单介绍一下MyBatis的CRUD以及结合源码讲解一下MyBatis对参数的处理. 作为一个ORM框架,最基本的使用也就是CRUD了,MyBatis提供了两种方法:xml配置文件和动态注解. ...
- Flume+Kafka+Storm整合
Flume+Kafka+Storm整合 1. 需求: 有一个客户端Client可以产生日志信息,我们需要通过Flume获取日志信息,再把该日志信息放入到Kafka的一个Topic:flume-to-k ...
- Tips_钉钉免登前端实现
1.需求:开发钉钉微应用,需要实现钉钉的免登陆功能. #.其实钉钉的文档中心还是很详细的,只是刚开始接触会一头雾水,所以花费了挺多时间....... ?什么是钉钉免登功能. ?企业应用免登开发授权流程 ...
- Redis_MISCONF Redis is configured to save RDB snapshots, but is currently not able to persist on disk问题解决
原因:可参考https://www.linuxidc.com/Linux/2012-07/66079.htm 解决方案一: 修改redis.conf中 stop-writes-on-bgsave-er ...
- Charles抓包软件简介
Charles简介: Charles是一款抓包神器,因为他是基于 java 开发的,所以跨平台,Mac.Linux.Window下都是可以使用的,确保安装之前已经安装了JDK.Charles官网地址: ...
- 详谈kafka的深入浅出
第一:kafka的介绍,kafka官网:http://kafka.apache.org/ http://www.jasongj.com/2015/03/10/KafkaColumn1/ kafka的简 ...