
Flink sql 之AsyncIO与LookupJoin的几个疑问 (源码分析)
本文源码基于flink 1.14
被同事问到几个关于AsyncIO和lookUp维表的问题所以翻了下源码,从源码的角度解惑这几个问题
对于AsyncIO不了解的可以看看之前写的这篇 《Flink中异步AsyncIO的实现 (源码分析)》
问题一:AsyncIO 有(排序 / 非排序) 模式,非排序模式数据会乱序,那水印waterMarker会乱序吗 ???
不想看源码的先直接给出答案
:不会乱序,接收到水印数据后非排序模式会,直接往下游发送waterMarker
问题二:LookUp维表join分为同步和Async, 上面异步非排序,数据会乱序水印不会,那sql的维表异步join数据会乱序吗 ???
:不会乱序,源码中默认都是AsyncIO的排序(Ordered)模式
ok上源码
问题一:AsyncIO水印会乱序吗?
来看一下异步io对应的StreamOperator的源码 org.apache.flink.streaming.api.operators.async.AsyncWaitOperator
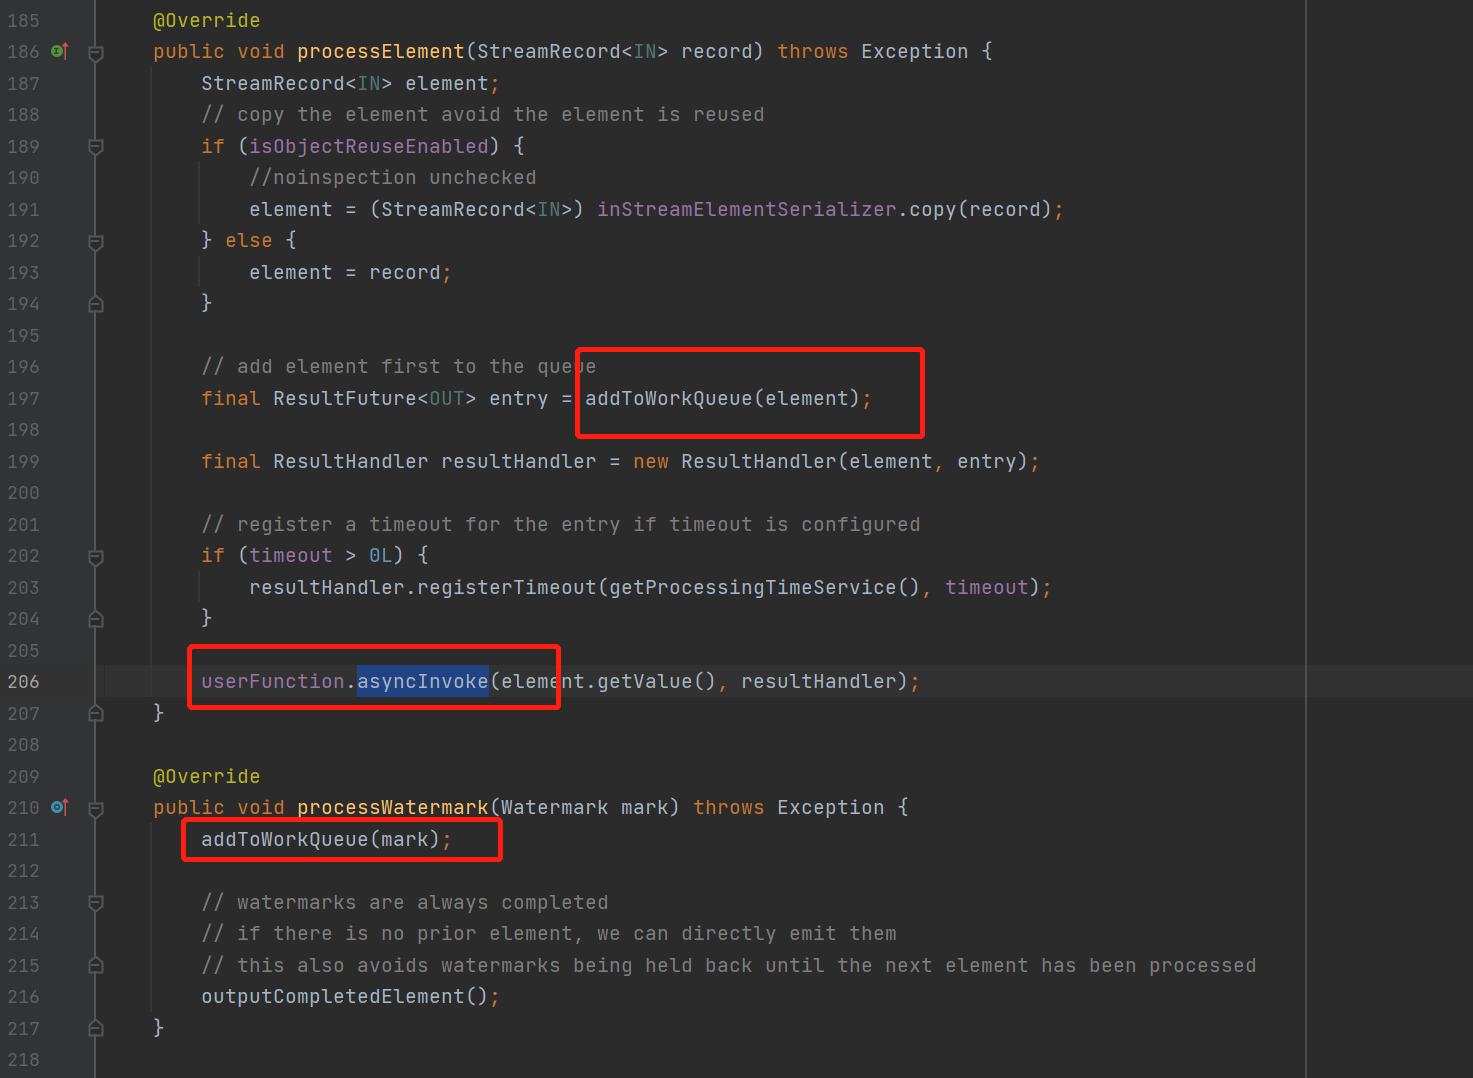
异步io接收到数据以后,加入到queue里面,然后调用用户写的UserFunction
异步io接收到水印以后,同样加入到queue里面
那继续看addToWorkQueue方法接收到水印以后

加入具体的queue
继续,这里只看非排序的unordered

也是一样直接加addWtaermark()
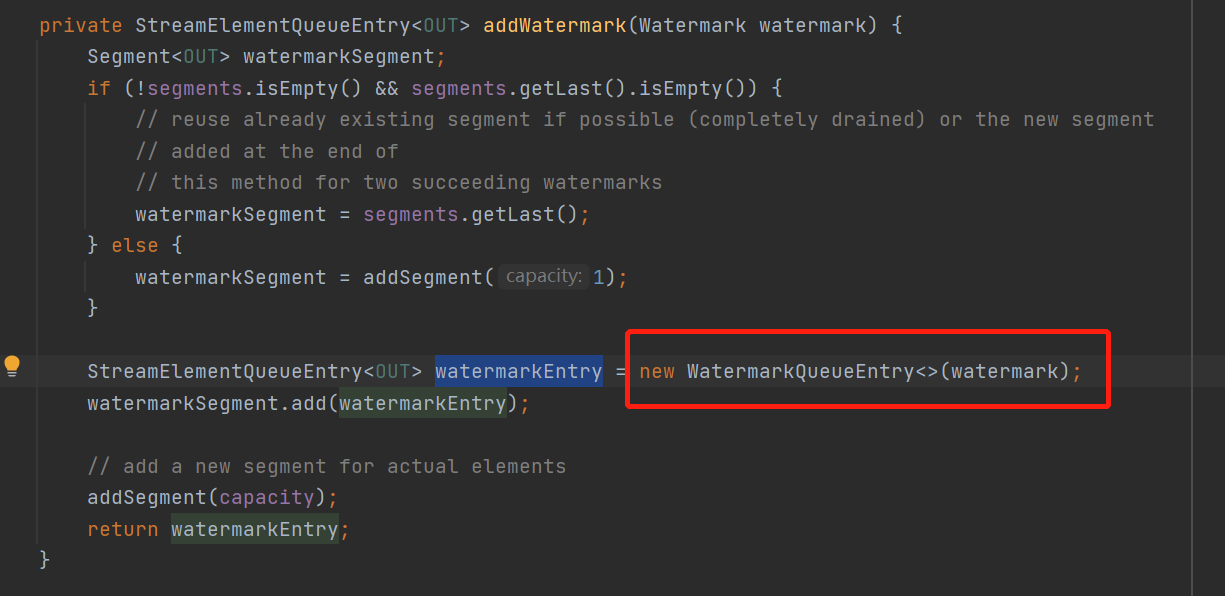
将水印包装成一个WatermarkQueueEntry对象直接放queue
ok那来看下这个watermarkQueueEntry类

可以看到当水印进入queue以后直接就是已完成的了,就可以直接往下游发送,管你其他异步处理的数据完成没完成,水印已经往下发了
问题二:LookUp维表异步join会导致数据乱序吗?
看下关于lookup的calcite的对应规则

调用链不看了,有点长来看最后生成的,execNode物理的relNode执行节点StreamExecLookupJoin
来看下它抽象类 CommonExecLookupJoin的translateToPlanInternal方法
最后走到 createAsyncLookupJoin 来看下如何生成AsyncIO的function的
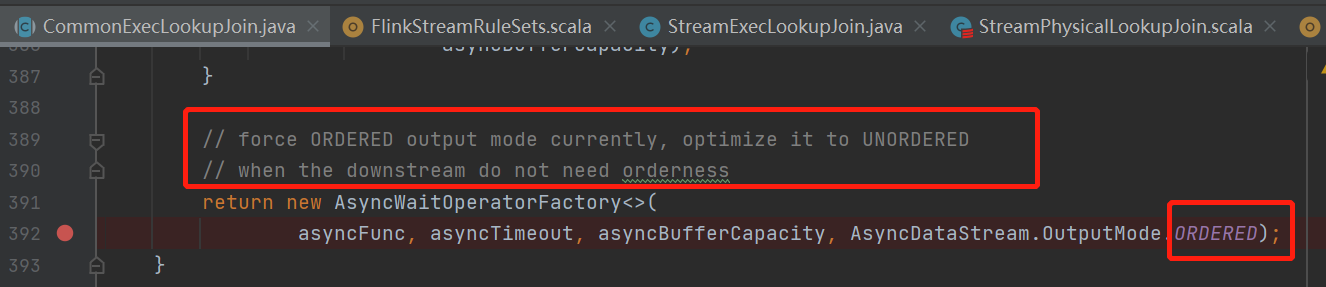
ok 用的ordered模式的异步io,维表关联的数据尽管是异步去join的,但是往下游发的时候还是按顺序的
不会乱序
Flink sql 之AsyncIO与LookupJoin的几个疑问 (源码分析)的更多相关文章
- [源码分析] 带你梳理 Flink SQL / Table API内部执行流程
[源码分析] 带你梳理 Flink SQL / Table API内部执行流程 目录 [源码分析] 带你梳理 Flink SQL / Table API内部执行流程 0x00 摘要 0x01 Apac ...
- [源码分析]从"UDF不应有状态" 切入来剖析Flink SQL代码生成 (修订版)
[源码分析]从"UDF不应有状态" 切入来剖析Flink SQL代码生成 (修订版) 目录 [源码分析]从"UDF不应有状态" 切入来剖析Flink SQL代码 ...
- MyCat源码分析系列之——SQL下发
更多MyCat源码分析,请戳MyCat源码分析系列 SQL下发 SQL下发指的是MyCat将解析并改造完成的SQL语句依次发送至相应的MySQL节点(datanode)的过程,该执行过程由NonBlo ...
- MyBatis源码分析-SQL语句执行的完整流程
MyBatis 是支持定制化 SQL.存储过程以及高级映射的优秀的持久层框架.MyBatis 避免了几乎所有的 JDBC 代码和手动设置参数以及获取结果集.MyBatis 可以对配置和原生Map使用简 ...
- Flink源码分析 - 源码构建
原文地址:https://mp.weixin.qq.com/s?__biz=MzU2Njg5Nzk0NQ==&mid=2247483692&idx=1&sn=18cddc1ee ...
- MyBatis 源码分析 - SQL 的执行过程
* 本文速览 本篇文章较为详细的介绍了 MyBatis 执行 SQL 的过程.该过程本身比较复杂,牵涉到的技术点比较多.包括但不限于 Mapper 接口代理类的生成.接口方法的解析.SQL 语句的解析 ...
- 第十一篇:Spark SQL 源码分析之 External DataSource外部数据源
上周Spark1.2刚发布,周末在家没事,把这个特性给了解一下,顺便分析下源码,看一看这个特性是如何设计及实现的. /** Spark SQL源码分析系列文章*/ (Ps: External Data ...
- 第十篇:Spark SQL 源码分析之 In-Memory Columnar Storage源码分析之 query
/** Spark SQL源码分析系列文章*/ 前面讲到了Spark SQL In-Memory Columnar Storage的存储结构是基于列存储的. 那么基于以上存储结构,我们查询cache在 ...
- 第九篇:Spark SQL 源码分析之 In-Memory Columnar Storage源码分析之 cache table
/** Spark SQL源码分析系列文章*/ Spark SQL 可以将数据缓存到内存中,我们可以见到的通过调用cache table tableName即可将一张表缓存到内存中,来极大的提高查询效 ...
随机推荐
- 使用jemeter构造各种变量数据
使用手动创建测试数据太麻烦,因此考虑用jmeter写了一些创建测试数据的脚本,针对那些变量非固定的数据可以利用函数来实现 通过函数助手添加各种变量数据 Tools--->函数助手 1:生成当前时 ...
- Java-Ide快速创建getter&setter方法
1.右键 选择Generate 2.创建 类的equals方法
- Ubuntu安装Oracleclient远程连接数据库
平时Oracle数据库都安装在本地或者WindowsServer上进行使用,但因为工作需要,领导要求在虚拟机中安装Ubuntu来连接Windows本地安装的数据库,先将操作过程和遇到的问题进行梳理总结 ...
- java 从零开始手写 RPC (04) -序列化
序列化 java 从零开始手写 RPC (01) 基于 socket 实现 java 从零开始手写 RPC (02)-netty4 实现客户端和服务端 java 从零开始手写 RPC (03) 如何实 ...
- Win10连WiFi显示无internet,安全 却可以正常上网
1.现象: win10连WiFi显示无internet,安全 可以正常上网 2.原因: Wind10升级系统补丁后,更新了系统检查是否联网的注册表配置,新的域名在国内存在无法连接情况.导致此问题发生 ...
- Java基础之(七):Scanner对象
用户交互Scanner Scanner对象 调用java.util.Scanner 可以通过Scanner类来获取用户的输入 基本语法: Scanner scanner = new Scanner(S ...
- MySQL ENGINES 引擎
引擎 存储引擎是数据库底层软件组织. 数据库管理系统(DBMS)使用数据引擎进行创建.查询.更新和删除数据. 不同的存储引擎提供不同的存储机制.索引技巧.锁定水平等功能. MySQL的核心就是存储引擎 ...
- springMVC上传和下载附件
上传: 导入需要的jar包:Spring MVC类库 + 文件上传下载需要的JAR包,图中A处为文件上传下载需要的JAR包,其余为Spring MVC类库. 构建领域模层:model层和control ...
- 2020.11.6-vj补题
A - A CodeForces - 136A 题解:按输入的顺序输出对应的下标即可,定义一个数组,将输入的作为下标,下标为值,最后依次输出即可: #include<bits/stdc++.h& ...
- HttpServletResponse 入门
继承体系 功能: 设置响应消息 1. 设置响应行 格式:HTTP/1.1 200 ok 设置状态码:setStatus(int sc) 2. 设置响应头:setHeader(String name, ...