
Python--数据存储
新建测试文档
测试.txt
内容如下:
张三:今天天气真好.
李四:是的,真的太好了。
张三:阳光明媚。
李四:鸟语花香。
王五:装逼现场:请带好安全帽
张三:难得好天气,今天就不偷懒了。
李四:能把乞讨说的这么高大上的也就只有你了。
分隔符
张三:难得好天气,今天就不偷懒了。
李四:能把乞讨说的这么高大上的也就只有你了。
//分隔符之后的话是为了观察异常处理(多了一个分隔符,会录到那个文档呢?),能否顺利进行
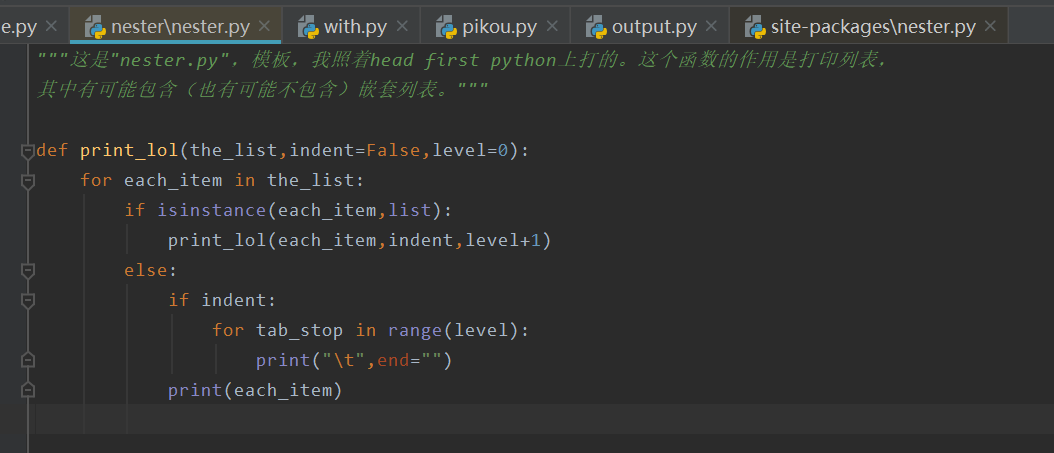
(如何导入模块,请看上一篇)
from nester import print_lol
#导入nester模块,其中就写了一个自定义函数print_lol可以把列表完全展开

zs = []

ls = []

ww = []

try:

 with open(r'C:\Users\努力学习,不要让自己失望\Desktop\测试.txt') as the_file:

  for each_line in the_file:

      try:

          (role,line_spoken) = each_line.split(":",1)

          if role =='张三':

              # 如果role==张三,将line_spoken添加到man列表

           zs.append(line_spoken)

          elif role =='李四':

            ls.append(line_spoken)

          elif role == '王五':

            ww.append(line_spoken)

      except ValueError:

          # 出现ValueError时,直接输出 each_line的值

          print(each_line,end="")

 the_file.close()

except IOError:

    #找不到文件时提示文件不存在

    print("文件不存在!")

try:

 with open(r'C:\Users\努力学习,不要让自己失望\Desktop\zs.txt','w') as the_man:

     print_lol(zs,the_man)

     #调用print_lol方法处理列表数据

 with open(r'C:\Users\努力学习,不要让自己失望\Desktop\ls.txt','w') as the_other:

     print_lol(ls,the_other)

     # 调用print_lol方法处理列表数据

except IOError:

    print("文件不存在!")

运行之后,就可以看到桌面上多了两个文档


分隔符 被过滤掉了
在运行的时候输出来了
Python--数据存储的更多相关文章
- python数据存储--JSON
HTML正文存储为两种格式:JSON和CSV. 存储为JSON: 首先利用Requests访问http://seputu.com获取HTML文档: #!coding:utf-8 import requ ...
- python数据存储技巧
1.文本存储 比如我们现在有10篇文章,每篇文章由三部分组成,题目,作者,内容(title,author,content),然后要求这三个部分明确展示出来,并且每篇文章之间用=====分割. 大致思路 ...
- Python数据存储:pickle模块的使用讲解
在机器学习中,我们常常需要把训练好的模型存储起来,这样在进行决策时直接将模型读出,而不需要重新训练模型,这样就大大节约了时间.Python提供的pickle模块就很好地解决了这个问题,它可以序列化对象 ...
- python数据存储-- CSV
CSV,其文件以纯文本形式存储表格数据(数字和文本),CSV记录简由某种换行符分隔字段间分隔又其他字符,常见逗号或者制表符, 例如: #coding:utf-8 import csv headers ...
- [转]pickle python数据存储
python的pickle模块实现了基本的数据序列和反序列化.通过pickle模块的序列化操作我们能够将程序中运行的对象信息保存到文件中去,永久存储:通过pickle模块的反序列化操作,我们能够从文件 ...
- Python数据存储 — MySQL数据库操作
本地安装MySQL 调试环境python3.6,调试python操作mysql数据库,首先要在本地或服务器安装mysql数据库. 安装参考:https://mp.csdn.net/postedit/8 ...
- Python - 数据存储与数据库简介
- Python多线程爬虫与多种数据存储方式实现(Python爬虫实战2)
1. 多进程爬虫 对于数据量较大的爬虫,对数据的处理要求较高时,可以采用python多进程或多线程的机制完成,多进程是指分配多个CPU处理程序,同一时刻只有一个CPU在工作,多线程是指进程内部有多个类 ...
- python轻量级数据存储
python为开发者提供了一个轻量级的数据存储方式shelve,对于一些轻量数据,使用shelve是个比较不错的方式.对于shelve,可以看成是一个字典,它将数据以文件的形式存在本地.下面介绍具体用 ...
- Python爬虫框架Scrapy实例(三)数据存储到MongoDB
Python爬虫框架Scrapy实例(三)数据存储到MongoDB任务目标:爬取豆瓣电影top250,将数据存储到MongoDB中. items.py文件复制代码# -*- coding: utf-8 ...
随机推荐
- 如何获取微信小程序for循环的index
在微信小程序开发中,对于wx:for,可以使用wx:for-index="index"来获取数组中的元素的索引值(下标). <view class="item&qu ...
- AcWing 90. 64位整数乘法
求a*b%p的值. 0<a,b,p<1e18; 原题链接 #include<bits/stdc++.h> #define ull unsigned long long usin ...
- CentOS-Docker安装RabbitMQ(单点)
这里注意获取镜像的时候要获取management版本的,不要获取last版本的,management版本的才带有管理界面. 获取镜像 $ docker pull rabbitmq:management ...
- linux 开机自启动的两种方式
方法 1 – 使用 rc.local sudo vi /etc/rc.local 在文件最后加上: sh /root/script.sh & 如果是 CentOS,我们修改的是文件 /etc/ ...
- runtime使用总结
runtime这个东西,项目是很少用到的,但面试又避不可少,了解其内部的机制对底层的理解还是很有必要的. 1.动态添加属性 拓展类别属性的简单实现 a.定义字面量指针 static char dyna ...
- SpringBoot 如何统一后端返回格式?老鸟们都是这样玩的!
大家好,我是飘渺. 今天我们来聊一聊在基于SpringBoot前后端分离开发模式下,如何友好的返回统一的标准格式以及如何优雅的处理全局异常. 首先我们来看看为什么要返回统一的标准格式? 为什么要对Sp ...
- solr_hacktool
https://github.com/mustblade/solr_hacktool 最近复现了几个solr漏洞,没找到现成工具,就心血来潮写了个小玩具.没了.
- Function.identity()
Java 8允许在接口中加入具体方法.接口中的具体方法有两种,default方法和static方法,identity()就是Function接口的一个静态方法.Function.identity()返 ...
- [刘阳Java]_美团点评2018届校招面试总结_Java后台开发【转载】
美团喜欢一口气把三轮技术面和HR面一起面完,虽然身心比较累(每一面差不多一个小时),不过也算是一个好事,不像某些公司一天就一面然后让回去等消息,等面试通知也等得让人很焦虑,而且还容易出现面试时间冲突. ...
- 【动画消消乐】HTML+CSS 自定义加载动画 062
效果展示 Demo代码 HTML <!DOCTYPE html> <html lang="en"> <head> <meta charse ...