
梯度下降&随机梯度下降&批梯度下降
梯度下降法
下面的h(x)是要拟合的函数,J(θ)损失函数,theta是参数,要迭代求解的值,theta求解出来了那最终要拟合的函数h(θ)就出来了。其中m是训练集的记录条数,j是参数的个数。
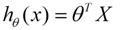

梯度下降法流程:
(1)先对θ随机赋值,可以是一个全零的向量。
(2)改变θ的值,使J(θ)按梯度下降的方向减少。
以上式为例:
(1)对于我们的函数J(θ)求关于θ的偏导:
(2)下面是更新的过程,也就是θi会向着梯度最小的方向进行减少。θi表示更新之前的值,-后面的部分表示按梯度方向减少的量,α表示步长,也就是每次按照梯度减少的方向变化多少。

值得注意的是,梯度是有方向的,对于一个向量θ,每一维分量θi都可以求出一个梯度的方向,我们就可以找到一个整体的方向,在变化的时候,我们就朝着下降最多的方向进行变化就可以达到一个最小点,不管它是局部的还是全局的。
批量梯度下降
(1)将J(θ)对θ求偏导,得到每个θ对应的梯度(m为训练样本的个数):

(2)由于是要最小化风险函数,所以按每个参数theta的梯度负方向,来更新每个theta

(3)从上面公式可以注意到,它得到的是一个全局最优解,但是每迭代一步,都要用到训练集所有的数据,如果m很大,那么可想而知这种方法的迭代速度!!所以,这就引入了另外一种方法,随机梯度下降。
随机梯度下降
(1)上面的风险函数可以写成如下这种形式,损失函数对应的是训练集中每个样本的粒度,而上面批量梯度下降对应的是所有的训练样本:

(2)每个样本的损失函数,对theta求偏导得到对应梯度,来更新theta

(3)随机梯度下降是通过每个样本来迭代更新一次,如果样本量很大的情况(例如几十万),那么可能只用其中几万条或者几千条的样本,就已经将theta迭代到最优解了,对比上面的批量梯度下降,迭代一次需要用到十几万训练样本,一次迭代不可能最优,如果迭代10次的话就需要遍历训练样本10次。但是,SGD伴随的一个问题是噪音较BGD要多,使得SGD并不是每次迭代都向着整体最优化方向。
梯度下降&随机梯度下降&批梯度下降的更多相关文章
- 批量梯度下降(BGD)、随机梯度下降(SGD)以及小批量梯度下降(MBGD)的理解
梯度下降法作为机器学习中较常使用的优化算法,其有着三种不同的形式:批量梯度下降(Batch Gradient Descent).随机梯度下降(Stochastic Gradient Descent ...
- 机器学习笔记 1 LMS和梯度下降(批梯度下降) 20170617
https://www.cnblogs.com/alexYuin/p/7039234.html # 概念 LMS(least mean square):(最小均方法)通过最小化均方误差来求最佳参数的方 ...
- 监督学习:随机梯度下降算法(sgd)和批梯度下降算法(bgd)
线性回归 首先要明白什么是回归.回归的目的是通过几个已知数据来预测另一个数值型数据的目标值. 假设特征和结果满足线性关系,即满足一个计算公式h(x),这个公式的自变量就是已知的数据x,函数值h(x)就 ...
- 监督学习——随机梯度下降算法(sgd)和批梯度下降算法(bgd)
线性回归 首先要明白什么是回归.回归的目的是通过几个已知数据来预测另一个数值型数据的目标值. 假设特征和结果满足线性关系,即满足一个计算公式h(x),这个公式的自变量就是已知的数据x,函数值h(x)就 ...
- p1 批梯度下降算法
(蓝色字体:批注:绿色背景:需要注意的地方:橙色背景是问题) 一,机器学习分类 二,梯度下降算法:2.1模型 2.2代价函数 2.3 梯度下降算法 一,机器学习分类 无监督学习和监督学习 无监 ...
- 1. 批量梯度下降法BGD 2. 随机梯度下降法SGD 3. 小批量梯度下降法MBGD
排版也是醉了见原文:http://www.cnblogs.com/maybe2030/p/5089753.html 在应用机器学习算法时,我们通常采用梯度下降法来对采用的算法进行训练.其实,常用的梯度 ...
- 梯度下降算法对比(批量下降/随机下降/mini-batch)
大规模机器学习: 线性回归的梯度下降算法:Batch gradient descent(每次更新使用全部的训练样本) 批量梯度下降算法(Batch gradient descent): 每计算一次梯度 ...
- 梯度下降、随机梯度下降、方差减小的梯度下降(matlab实现)
梯度下降代码: function [ theta, J_history ] = GradinentDecent( X, y, theta, alpha, num_iter ) m = length(y ...
- ubuntu之路——day7.4 梯度爆炸和梯度消失、初始化权重、梯度的数值逼近和梯度检验
梯度爆炸和梯度消失: W[i] > 1:梯度爆炸(呈指数级增长) W[i] < 1:梯度消失(呈指数级衰减) *.注意此时的1指单位矩阵,W也是系数矩阵 初始化权重: np.random. ...
随机推荐
- 侯捷STL学习(十)--容器hashtable探索(unordered set/map)
layout: post title: 侯捷STL学习(十) date: 2017-07-23 tag: 侯捷STL --- 第二十三节 容器hashtable探索 hashtable冲突(碰撞)处理 ...
- src路径
- c# 代码调用ssis包
https://docs.microsoft.com/en-us/sql/integration-services/run-manage-packages-programmatically/loadi ...
- Django之时区
在settings.py中修改如下配置: TIME_ZONE = 'Asia/Shanghai' USE_I18N = True USE_L10N = True USE_TZ = False 这样在m ...
- MySQL在cmd和python下的常用操作
环境配置1:安装mysql,环境变量添加mysql的bin目录 环境配置2:python安装MySQL-Python 请根据自身操作系统下载安装,否则会报c ++ compile 9.0,import ...
- Strophe.Status的所有值
ERROR: 0 CONNECTING: 1 CONNFAIL: 2 AUTHENTICATING: 3 AUTHFAIL: 4 CONNECTED: 5 DISCONNECTED: 6 DISCON ...
- Comparatable接口和Comparator接口的使用与区别
这篇博文可以为你解决的问题如下: 什么是自然排序 Collections.sort()与Arrays.sort()的异同点 Comparatable接口和Comparator接口各自的排序依据(理论讲 ...
- 关于jdk1.5之后的自定拆装箱
我们都知道jdk在1.5版本之后,增加了一些新特性,我们称之为语法糖,有:1.泛型,2.foreach增强for循环,3.自动拆装箱,4.可变参数,5.枚举,6.静态导入 public class T ...
- centos 端口iptables配置
1.安装iptables yum install iptables* -y 2.打开端口 iptables -I INPUT -p tcp --dport -j ACCEPT 3.查看本机关于IPTA ...
- js转化与排序
1.对象转化为数组 object.keys() var obj={a:3,b:7,c:8,d:false} alert(Object.keys(obj)) 注意此函数会把对象的key转化为数组 spl ...