
目标检测 — Inception-ResNet-v2
这篇文章介绍的网络有Inception V1、Inception V2、Inception V3、Inception V4与Inception-ResNet-V2。
1、Inception V1
主要贡献:
(1)提出inception architecture并对其优化
(2)取消全连层(因为FC网络输入要固定、参数过多、容易过拟合)
(3)运用auxiliary classifiers加速网络converge,简称AC
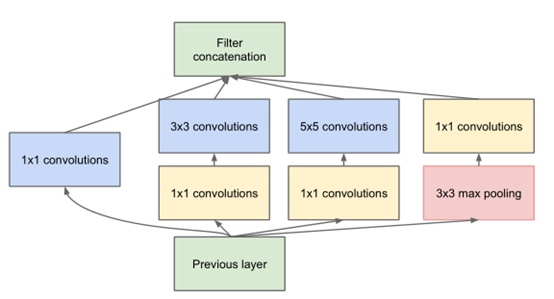
其中1×1的卷积层可以控制kernels的数量,还增加了网络的非线性程度。多个卷层后将卷积直接concate一下。
网络中间层加入了两个AC,这两个AC在训练的时候也跟着学习,同时把自己学习到的梯度反馈给网络,算上网络最后一层的梯度反馈,GoogLeNet一共有3个“梯度提供商”,先不说这么做有没有问题,它确实提高了网络收敛的速度,因为梯度大了嘛。另外,GoogLeNet在做inference的时候AC是要被摘掉的。
该团队又提出了inception v2的结构,基于上面提到的一些原则,在V1的基础之上主要做了以下改进:
(1)使用BN层,将每一层的输出都规范化到一个N(0,1)的正态分布,这将有助于训练,因为下一层不必学习输入数据中的偏移,并且可以专注与如何更好地组合特征(也因为在v2里有较好的效果,BN层几乎是成了深度网络的必备)。这也是最大贡献Batch Normalization(BN)。BN层放在每个隐藏层激活函数前,即 wx+b 之后,之后再加激活函数。总的来讲,加入BN层的反向传播没有发生根本的改变,只是多了一个反向计算过程(batchnorm_backward函数)而已。
(2)使用两个小的3*3卷积核代替一个5*5的大卷积核,好处是:相同的感受野、更少的参数、更深的网络提取特征。
(3)尝试更小的卷积:1*3 + 3*1 替换3*3 卷积。
3、Inception V3
- 1、分解大filters,使其小型化、多层化,其中有个“非对称卷积”很新颖
- 2、优化inception v1的auxiliary classifiers
- 3、提出一种缩小特征图大小的方法,说白了就是一种新的、更复杂的pooling层
- 4、Label smooth,“标签平滑”,很难用中文说清楚的一种方法
4、Inception V4
各种改网络结构,各种复杂,也是醉了。
将原来卷积、池化的顺次连接(网络的前几层)替换为stem模块,来获得更深的网络结构。
5、Inception-ResNet-v2
- 1、在Inception v3的基础上发明了Inception v4,v4比v3更加复杂,复杂到不可思议
- 2、结合ResNet与GoogLeNet,发明了Inception-ResNet-v1、Inception-ResNet-v2,其中Inception-ResNet-v2效果非常好,但相比ResNet,Inception-ResNet-v2的复杂度非常惊人,跟Inception v4差不多
- 3、加入了Residual Connections以后,网络的训练速度加快了
- 4、在网络复杂度相近的情况下,Inception-ResNet-v2略优于Inception-v4
- 5、Residual Connections貌似只能加速网络收敛,真正提高网络精度的是“更大的网络规模”
6、总结
inception 网络系列是从GoogLeNet开始的,一步步将网络设计的更复杂,最后直接结合残差网络,复杂度进一步上升,残差网络负责加快收敛,重要的还是模型的规模。Inception-ResNet v2、ResNet152和Inception v4模型规模差不多,v4略小,Inception v3和ResNet50模型规模相当。
依我个人理解,网络的负责是为了充分挖掘训练数据图像的特征,减少卷积过程中特征的损失,从而提高分类准确度。但在现实应用中,还需要在模型复杂度,计算量和任务需求上进行权衡选择。如果相对简单的网络能满足要求,就不必须选择复杂的网络。
目标检测 — Inception-ResNet-v2的更多相关文章
- 目标检测之YOLO V2 V3
YOLO V2 YOLO V2是在YOLO的基础上,融合了其他一些网络结构的特性(比如:Faster R-CNN的Anchor,GooLeNet的\(1\times1\)卷积核等),进行的升级.其目的 ...
- 目标检测 - Tensorflow Object Detection API
一. 找到最好的工具 "工欲善其事,必先利其器",如果你想找一个深度学习框架来解决深度学习问题,TensorFlow 就是你的不二之选,究其原因,也不必过多解释,看过其优雅的代码架 ...
- 目标检测算法之YOLOv1与v2
YOLO:You Only Look Once(只需看一眼) 基于深度学习方法的一个特点就是实现端到端的检测,相对于其他目标检测与识别方法(如Fast R-CNN)将目标识别任务分成目标区域预测和类别 ...
- 目标检测网络之 YOLOv2
YOLOv1基本思想 YOLO将输入图像分成SxS个格子,若某个物体 Ground truth 的中心位置的坐标落入到某个格子,那么这个格子就负责检测出这个物体. 每个格子预测B个bounding b ...
- AI佳作解读系列(二)——目标检测AI算法集杂谈:R-CNN,faster R-CNN,yolo,SSD,yoloV2,yoloV3
1 引言 深度学习目前已经应用到了各个领域,应用场景大体分为三类:物体识别,目标检测,自然语言处理.本文着重与分析目标检测领域的深度学习方法,对其中的经典模型框架进行深入分析. 目标检测可以理解为是物 ...
- 目标检测网络之 YOLOv3
本文逐步介绍YOLO v1~v3的设计历程. YOLOv1基本思想 YOLO将输入图像分成SxS个格子,若某个物体 Ground truth 的中心位置的坐标落入到某个格子,那么这个格子就负责检测出这 ...
- 【转】目标检测之YOLO系列详解
本文逐步介绍YOLO v1~v3的设计历程. YOLOv1基本思想 YOLO将输入图像分成SxS个格子,若某个物体 Ground truth 的中心位置的坐标落入到某个格子,那么这个格子就负责检测出这 ...
- 【目标检测】YOLO:
PPT 可以说是讲得相当之清楚了... deepsystems.io 中文翻译: https://zhuanlan.zhihu.com/p/24916786 图解YOLO YOLO核心思想:从R-CN ...
- 目标检测之RefineDet
RefineDet 一.相关背景 中科院自动化所最新成果,CVPR 2018 <Single-Shot Refinement Neural Network for Object Detectio ...
- One Stage目标检测
在计算机视觉中,目标检测是一个难题.在大型项目中,首先需要先进行目标检测,得到对应类别和坐标后,才进行之后的各种分析.如人脸识别,通常是首先人脸检测,得到人脸的目标框,再对此目标框进行人脸识别.如果该 ...
随机推荐
- 怎样取消不能改动(仅仅读打开)的word文件的password
作者:iamlaosong 朋友给我一个文档,是加了防改动password的,希望我能帮其取消.由于须要原文档的格式,取消方法例如以下(office2007环境): 1.打开文件.文件打开时,提演示样 ...
- 【Github】之突然访问不了Github地址
访问Github突然上不去了 解决办法: 一.修改hosts 1.打开Dns检测|Dns查询 - 站长工具2.在检测输入栏中输入http://github.com官网3.把检测列表里的TTL值最小的I ...
- 记CBS一次动人心魄的数据保卫战
接触分布式存储已经有一年多的时间了,首次遇到存储侧三份数据都有异常的情况,三份数据异常意味着客户数据的丢失,这个对云存储来讲是致命的打击.为了保证数据的安全,CBS运维和开发的同学进行了持续两天一夜的 ...
- Linux下安装 activemq 并指定jdk 1.8
1. 下载安装包 <apache-activemq-5.15.4-bin.tar.gz> 下载地址:https://pan.baidu.com/s/18xzjBAchjWqsHNA1HuY ...
- 【BZOJ5037】[Jsoi2014]电信网络 最大权闭合图
[BZOJ5037][Jsoi2014]电信网络 Description JYY创建的电信公司,垄断着整个JSOI王国的电信网络.JYY在JSOI王国里建造了很多的通信基站.目前所有的基站都是使用2G ...
- 【BZOJ4016】[FJOI2014]最短路径树问题 最短路径树+点分治
[BZOJ4016][FJOI2014]最短路径树问题 Description 给一个包含n个点,m条边的无向连通图.从顶点1出发,往其余所有点分别走一次并返回. 往某一个点走时,选择总长度最短的路径 ...
- height为auto, 滚动条出现时, 使页面不跳动
<style> html { margin-left: calc(100vw - 100%); } </style> ;
- centos6下nginx配置php可用
先查看下所有服务的状态,看看php-fpm有没有正在运行 [root@centos64 html]# service --status-all php-fpm (pid 3568) 正在运行... ...
- 自编码器(autoencoder)
今天我们会来聊聊用神经网络如何进行非监督形式的学习. 也就是 autoencoder, 自编码. 压缩与解压 有一个神经网络, 它在做的事情是 接收一张图片, 然后 给它打码, 最后 再从打码后的图片 ...
- Android Dev Tips
Ref:Android Service与Activity之间通信的几种方式 Ref:基础总结篇之五:BroadcastReceiver应用详解 Ref:Android Activity和Intent机 ...