
Gradle +HanLP +SpringBoot 构建关键词提取,摘要提取 。入门篇
前段时间,领导要求出一个关键字提取的微服务,要求轻量级。
对于没写过微服务的一个小白来讲。硬着头皮上也不能说不会啊。
首先了解下公司目前的架构体系,发现并不是分布式开发,只能算是分模块部署。然后我需要写个Boot的服务,对外提供一个接口就行。
在上网浏览了下分词概念后,然后我选择了Gradle & HanLP & SpringBoot & JDK1.8 & tomcat8 & IDEA工具来实现。
Gradle 我也是第一次听说,和Maven一样,可以很快捷的管理项目需要的jar。下载,解压,配置环境变量,验证等。不再赘述,可以去这里了解下https://www.w3cschool.cn/gradle/ctgm1htw.html
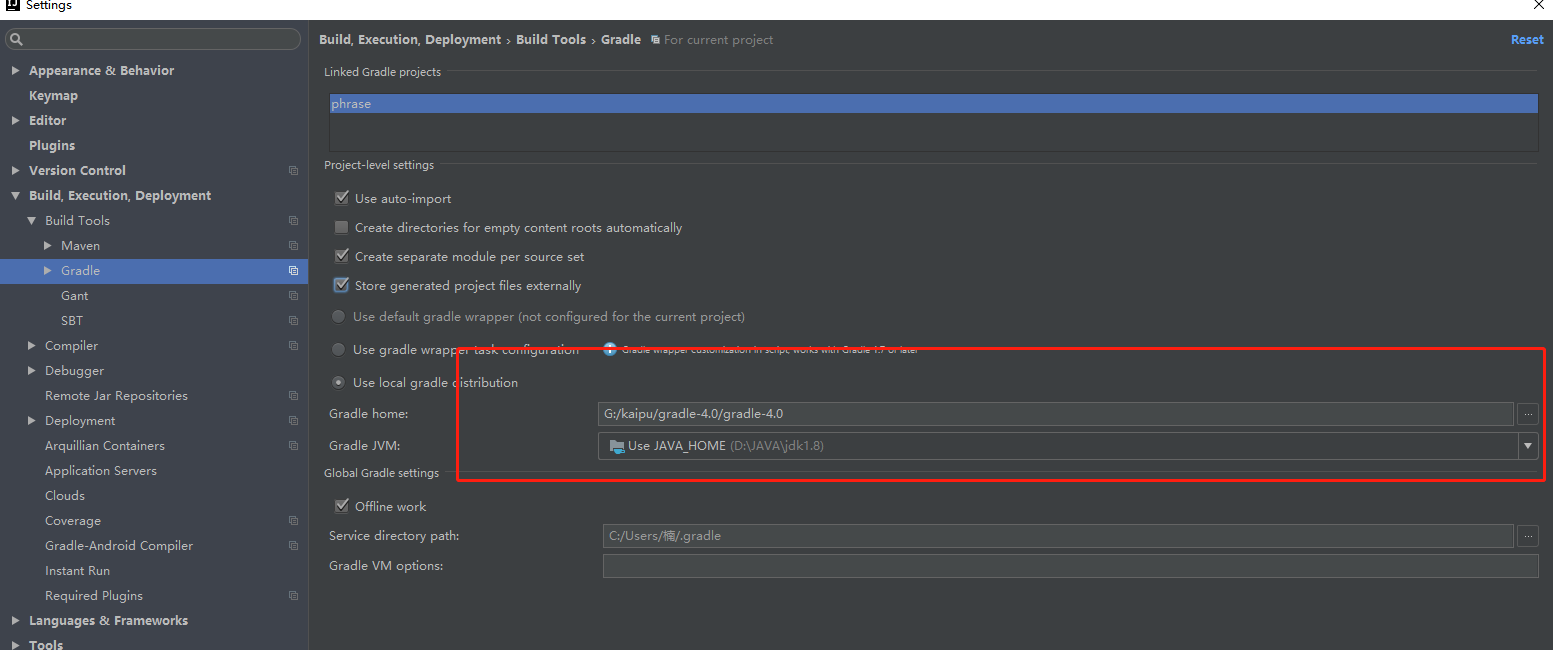
然后准备就绪后,在idea里配置一下Gradle路径
HanLP呢,老规矩,先下载,解压,https://github.com/hankcs/HanLP/releases 。简单看下目录结构
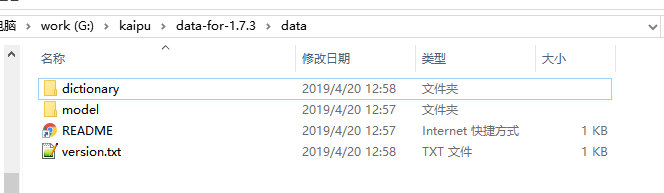
HanLP分为词典 和模型,其中词典(dictionary)是词法分析必备,模型(model)是句法分析必需。解压好准备data的上级目录 的绝对路径 下面会提到用途。
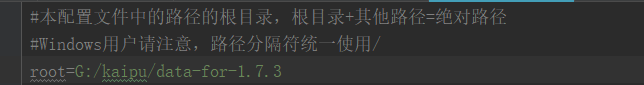
这里为G:/kaipu/data-for-1.7.3
tomcat8 去官网自行下载,选择自己操作系统对应的。 jdk1.8 下载安装,环境变量配置不再描述。
一切准备就绪,开始创建项目
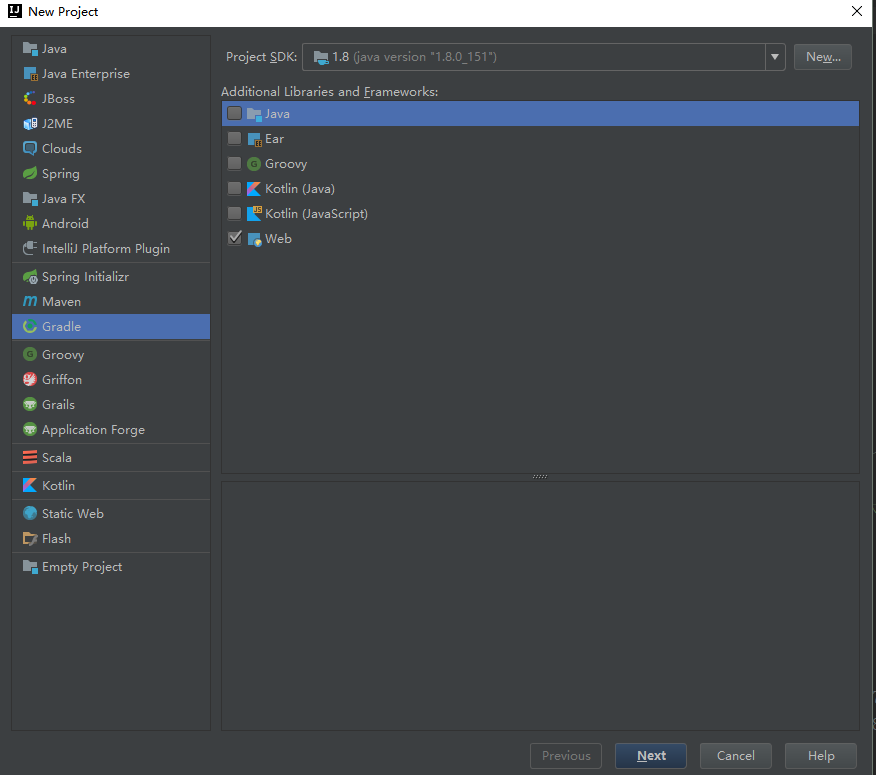
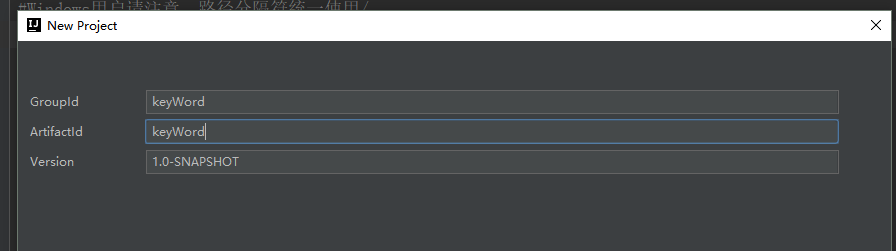
输入项目ID:keyWord,NEXT
选择本地的gradle
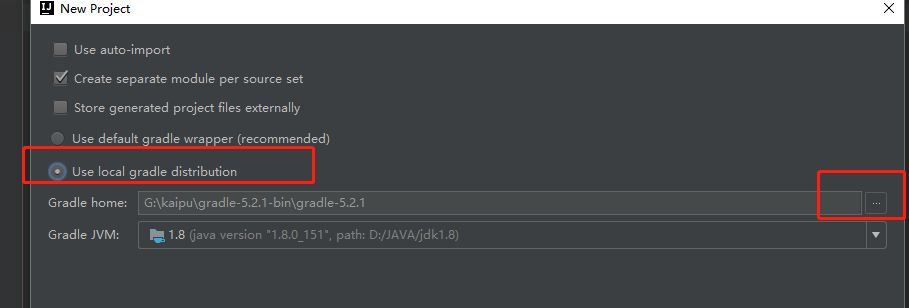
Next ,Finish
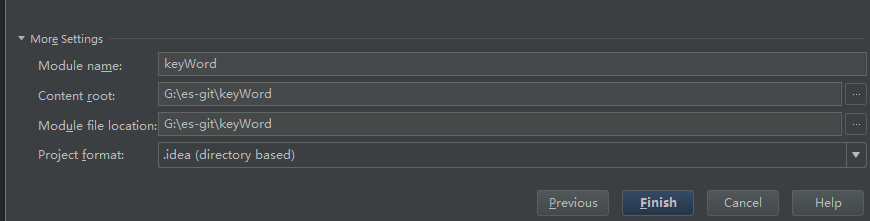
此刻项目就创建好了。
打开根目录下的
dependencies {

    compile 'org.springframework.boot:spring-boot:2.0.5.RELEASE'

    compile 'org.springframework.boot:spring-boot-starter-web:2.0.5.RELEASE'

    providedRuntime 'org.springframework.boot:spring-boot-starter-tomcat:2.0.5.RELEASE'

    testCompile group: 'junit', name: 'junit', version: '4.11'

    compile 'com.hankcs:hanlp:portable-1.7.3'
}
前三个jar 是集成springboot外部tomcat用的,第四个是junit单元测试依赖,第五个就是我们要用的hanlp依赖。
PS:这里我着重说下打包的事情,因为我没用过Gradle打包,项目时间紧,我就延用了war包格式,这里先记录下过程,这个项目后,再回头来研究Gradle打JAR包。
group 'keyword'

version '1.0-SNAPSHOT'

apply plugin: 'java'

apply plugin: 'war'

war {

    archiveName 'key-word.war'

}
等待idea自动导包完成后,我们来加载hanlp
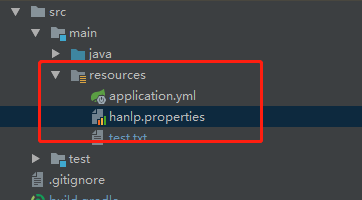
在resources下,出现一个hanlp.properties,打开编辑这个文件,更改root路径。这个路径就是上面我们提到的 data上级目录的绝对路径。
创建第一个测试类
  @Test

    public void test0(){

        String text = "中国是世界上的经济大国,社会主义强国!";
     List<Term> keyWords = HanLP.segment(text);
      System.out.println(keyWords.toString());
  }
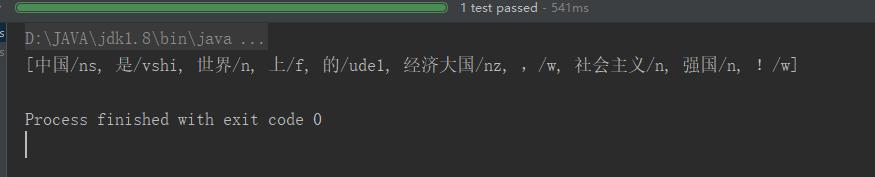
说明词库引入成功。
接下来可以正常开发,按照需求,需要提取正文里的关键词,摘要。
分析如下:
关键词抽取工具:
思路:输入标题,正文文本,综合考虑词频、位置、词性、组合性短语长度等因素,计算权重得分;返回topN个关键词。在此基础上进行抽取式摘要,按句子包含的关键词数量和权重进行处理。
原理:分词后,将命名实体单独拿到,再找合适的名词短语。依托HanLP的核心词典,根据TF*IDF算法计算每个命名实体和名词性短语的得分score,按score倒排返回前面若干关键词。
首先定义一个关键词类。可以是个单词,也可以是几个单词组成的短语。
public class Phrase implements Comparable<Phrase>{

    private String word;           //候选关键词

    private boolean inDictionary;  //是否在HanLP词典中

    private String suffixWord;     //中心词。对单词,中心词就是word。如果是短语,则是短语中最后一词

    private String suffixWordPos;  //中心词的词性

    private String prefixWordPos;  //首词的词性

    private int freqOfDict = 1;    //在词典中该词的词频

    private boolean single;        //true表示单词,false表示短语

    private Location location;     //该候选关键词出现的位置

    private int offset;            //该候选词在正文中位置

    private boolean isCandidate;   //是否候选关键词

    *

    *

    *

   /**
  *这会在比较score时用到
  */

    @Override

    public int compareTo(Phrase o) {

        return this.getWord().compareTo(o.getWord());

    }

}
以下是核心算法的一部分,寻找候选关键词
/**全局逻辑
先找出关键词,再计算分数
一、

     * 从分词Term中解析 候选的关键词,

     * 因为要计算每个句子的分数值需要句子里的所有词累加计算score,所以这里都需要打标分数。

     * @param terms              分词列表

     * @param title              文章标题

     * @param firstParagraphEnd  对于正文处理,表示正文第一段结尾位置

     * @param lastParagraphBegin 对于正文处理,表示正文最后一段开始位置

     */
int index= 0;
while (index < terms.size()) {
    //当前词
    Term current = terms.get(index);
    //首先判断是否是命名实体 人名开头 包含 地名 动名词 其他专名,或者团体名开头
if (current.nature.startsWith("nr")

                    || current.nature.equals(Nature.ns)

                    || current.nature.equals(Nature.nz)

                    || current.nature.equals(Nature.vn)

                    || current.nature.startsWith("nt")) {

                Phrase phrase = new Phrase(current.word,

                        CoreDictionary.contains(current.word),

                        current.word,

                        current.nature.toString(),

                        current.nature.toString(),

                        CoreDictionary.get(current.word) == null ? 100 : CoreDictionary.get(current.word).totalFrequency,

                        true,

                        title.contains(current.word) ? Location.TITLE : whichLocation(terms.get(index).offset, firstParagraphEnd, lastParagraphBegin),

                        terms.get(index).offset, true);

                phrases.add(phrase);

                index++;

            }
二、
//计算候选关键词的权重
TreeMap<Phrase, Double> scoreMap = new TreeMap<>();
for (Phrase phrase : phrases) {
    double score = scoreMap.containsKey(phrase) ? scoreMap.get(phrase) : 0.0;
    String phraseString = phrase.getWord().toString();
    int wordLength = phraseString.length();
    //排除单字符 的关键字,不进行输出
    if (score == 0.0 && wordLength != 1) {
        //weight方法:根据词性、词频、位置、词语长度等因素计算权重
        //这里依赖HanLp核心词典 和自定义词典 实现TF*IDF算法

        if (title.contains(phrase.getWord())) {
            phrase.setFreqOfDict(phrase.getFreqOfDict() / 2);
        }
        if (phrase.getPrefixWordPos().startsWith("v") && phrase.getWord().contains("的")) {
            phrase.setFreqOfDict(phrase.getFreqOfDict() * 1000);
        }
        score += Math.log(weight(phrase, content, title) * freqMap.get(phrase.getWord()) / phrase.getFreqOfDict());
        scoreMap.put(phrase, score);
    }

}
三、

倒排
Comparator<Map.Entry<Phrase, Double>> valueComparator = new Comparator<Map.Entry<Phrase, Double>>() {
    @Override
    public int compare(Map.Entry<Phrase, Double> o1,
                       Map.Entry<Phrase, Double> o2) {
        return (o2.getValue().compareTo(o1.getValue()));
    }
};
List<Map.Entry<Phrase, Double>> list = new ArrayList<Map.Entry<Phrase, Double>>(scoreMap.entrySet());
Collections.sort(list, valueComparator);

此刻就可利用subList函数 取出tonN的关键词了
subList(0, Math.min(topN, 候选关键词数组size()));

四、
在三的基础上,对正文按标点符号 。?!;.!? 等进行分句。
List<Sentence> sentences = new ArrayList<>();
int i = 0;
int lastSentenceEnd = 0;
while (i <= content.length() - 1) {
    char c = content.charAt(i);
    if (SENTENCE_END_TAGS.indexOf(c) >= 0
            && i > lastSentenceEnd + 1
            && i > 0
            && i < content.length()) {
        Location location = Location.MIDDLE;
        if (i < firstParagraphEnd) {
            location = Location.FIRST;
        } else if (i > lastParagraphBegin) {
            location = Location.LAST;
        }
        int begin = lastSentenceEnd + 1;
        if (sentences.isEmpty()) begin = 0; // 对第一句,应该从0开始
        Sentence sentence = new Sentence(begin, i, location);
        sentences.add(sentence);
        lastSentenceEnd = i;
    }
    i++;
}
五,分句后,对每句含有的词,在三的基础上,进行分数累加。(有个小逻辑:句子长度对分数比例的影响 || 单个句子包含多个命名实体 人名等对分数比例的影响。|| 。。。)这些需要大量的场景测for (Sentence sentence : sentences) {
    String line = content.substring(sentence.getBegin(), sentence.getEnd() + 1);
    double sumScore = wordsWeight.get(wordsWeight.size() - 1).getValue();
    //注意:要用关键词中最小权重做为基数,避免句子权重计算结果为0
    int maxSize = Math.min(topN, wordsWeight.size());
    for (int i = 0; i < maxSize; i++) {
        Map.Entry<Phrase, Double> weight = wordsWeight.get(i);
        double weightDouble = weight.getValue();
        if (line != null && line.indexOf(weight.getKey().getWord()) >= 0){
            List<Term> terms = NLPTokenizer.segment(line);
            int index =0;int termCount = 0;
       sumScore += weightDouble;}
      }
    sentence.setScore(sumScore);
然后同理,根据subList()取出想要的几个句子。再根据句子所在正文的位置,进行一个先后顺序的排列。
Comparator<Sentence> valueComparator = new Comparator<Sentence>() {

    @Override
    public int compare(Sentence o1, Sentence o2) {
        return o1.getBegin() - o2.getBegin();
    }
};
Collections.sort(prefixSentences, valueComparator);
StringBuilder sb = new StringBuilder();
for (Sentence sentence : prefixSentences) {
    sb.append(SentenceTool.toString(sentence, content));
}
还有一些可增删的业务逻辑:
去除文章末尾误识别的编辑、记者名称等
判断关键词里的 发言人;|| *** 说:“”。这些权重适当降低

保留句子里的实词词性,去除虚词词性(权重降低),来保证摘要的理性。

等等等等。

调试期间,有很多坑,现在记录下来,以便以后复习查看。
以上内容纯属个人所有,转载请注明出处。
Gradle +HanLP +SpringBoot 构建关键词提取,摘要提取 。入门篇的更多相关文章
- webpack+vue+vueRouter模块化构建完整项目实例详细步骤-入门篇
新建项目 开始(确认已经安装node环境和npm包管理工具) 1.新建项目文件名为start_vuedemo 2.npm init -y 初始化项目,我的win7系统,工程在d盘的vue_test_p ...
- springboot集成spring security安全框架入门篇
一. :spring security的简介 Spring Security是一个能够为基于Spring的企业应用系统提供声明式的安全访问控制解决方案的安全框架.它提供了一组可以在Spring应用上下 ...
- Textrank权值提取文本标签提取:
Textrank权值提取文本标签提取: 我已经爬取到了指定博主的新浪微博,然后我想从微博中提取出可以代表该博主兴趣特征的100个关键词,然后由这100个关键词提取出10个标签,代表博主的兴趣.我们此处 ...
- gradle结合spring-boot生成可运行jar包,并打印日志
1.用gradle把springboot项目打包成jar 1.1 build.gradle 中添加 buildscript { repositories { mavenLocal() maven { ...
- 用gradle把springboot项目打包成jar
``` 用gradle把springboot项目打包成jar ```### build.gradle 中添加 buildscript { repositories { mavenLocal() mav ...
- 使用 Gradle 实现 TFS 构建自动化
发布于 2014-07-16 作者 陈 忠岳 感谢微软开放技术有限公司(简称"微软开放技术")发布的构建模板,我们现在便可以在 Team Foundation Server(TFS ...
- gradle 打包springboot项目,找不到项目jar application.class
如题:gradle 打包springboot项目,找不到项目jar入口main方法:application.class 检查:lib/目录下没有相应项目的jar包 用gradle命令行查看日志:gra ...
- Spring-Boot构建多模块项目
Spring-Boot构建多模块项目 功能模块单独项目开发,可以将一个庞大的项目分解成多个小项目,便于细分开发 Maven多模块项目不能独立存在,必须有一个介质来包含. 1.创建一个Maven 项目, ...
- ArcGIS案例学习笔记2_1_山顶点提取最大值提取
ArcGIS案例学习笔记2_1_山顶点提取最大值提取 计划时间:第二天上午 目的:最大值提取 教程:Pdf page=343 数据:chap8/ex5/dem.tif 背景知识:等高线种类 基本等高线 ...
随机推荐
- CentOSserverMysql主从复制集群结构
在配置Mysql数据库主从复制集群时间,以确保: 1.主从server操作系统版本号和位数一致. 2.Mysql版本号一致. 为了保证稳定性,最好server操作系统和Mysql数据库环境一致. Ce ...
- A Byte of Python (for Python 3.0) 下载
在线阅读:http://www.swaroopch.org/notes/Python_en:Table_of_Contents 英文版 下载地址1:http://files.swaroopch.com ...
- 转:PyQt4学习资料汇总 from coderzh
一个月前研究了下PyQt4,感觉比较不错.相比wxpython,界面美观了很多,并且将界面设计与代码逻辑很好的分离了开来.关于PyQt4的资料也不少,这里我将我找到的资料汇总一下,以防自己以后忘得一干 ...
- device platform 相应的表
hw.machine 这个值相应相关代码最好在后台管理,降低手机端代码更新次数 if ([platform isEqualToString:@"iPhone1,1"]) retur ...
- 微信公众号开发系列-Http请求包基类
HttpHelper请求包基类,支持get请求和POS要求.以促进微通道交互界面的开发,为了准备的人机交互界面,背部. 1.HttpHelper帮助基类 [csharp] view plaincopy ...
- 手把手教你开发Nginx模块
前面的哪些话 关于Nginx模块开发的博客资料,网上很多,很多.但是,每篇博客都只提要点,无法"step by step"照着做,对于初次接触Nginx开发的同学,只能像只盲目的蚂 ...
- asp .net Cookies
Request.Cookies和Response.Cookies When validating cookies or cookie data from the browser you should ...
- SingletonBaseTemplate
public static byte[] writeValueAsZipByte(List<CraneDataDtls> dtls) { ObjectMapper mapper = new ...
- 基于IdentityServer4的单点登录——Client
以MvcClient项目为例 1.新建项目并添加引用 新建一个asp .net core 2.0的项目引用IdentityModel 2.配置 比之前的控制台客户端多这个步骤,需要配置这个客户端的Cl ...
- JAVASCRIPT高程笔记-------第六章 面向对象的程序设计
理解对象的概念 js中的对象与其他 编程语言中的类不一样 ECMAscript 没有类的概念 ECMA-262 把对象定义为 “无序属性的集合,其属性可以包含基本值,对象或者函数” ...