
Spark安装与部署
1.首先安装scala(找到合适版本的具体地址下载)
wget https://www.scala-lang.org/download/****
2.安装spark
wget http://mirrors.tuna.tsinghua.edu.cn/apache/spark/spark-2.4.3/spark-2.4.3-bin-hadoop2.7.tgz

tar -zxvf spark-2.4.-bin-hadoop2..tgz

rm spark-2.4.-bin-hadoop2..tgz
3.配置环境变量
vim /etc/profile
4.刷新环境变量
source /etc/profile
5.复制配置文件
cp slaves.template slaves

cp spark-env.sh.template spark-env.sh
6.接着进行以下配置
vim /etc/profile(查看其它配置文件直接复制即可)

vim ./spark-2.4.-bin-hadoop2./conf

vim spark-env.sh
7.启动spark环境
1)先启动Hadoop环境
/usr/local/hadoop-2.7./sbin/start-all.sh
2) 启动Spark环境
/usr/local/spark-2.4.-bin-hadoop2./sbin/start-all.sh
8.查看spark的web控制界面

9.查看Hadoop的web端界面
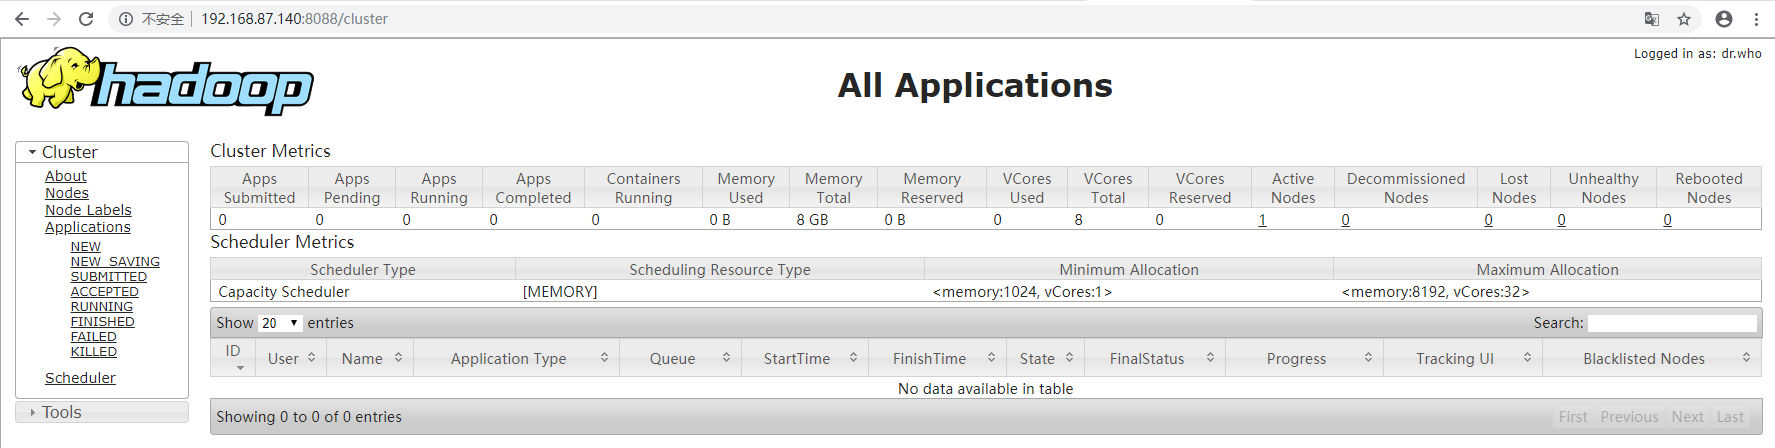
10.验证Spark是否安装成功
bin/run-example SparkPi

bin/run-example SparkPi >& | grep "Pi is"

11.使用Spark Shell编写代码
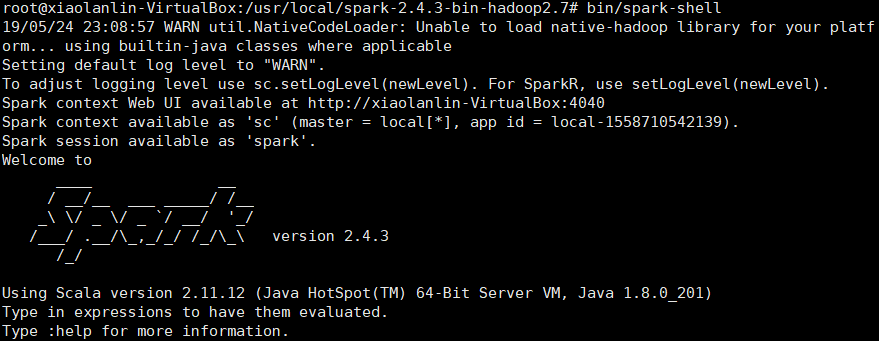
1)启动Spark Shell
bin/spark-shell
2)加载text文件
3)简单RDD操作
scala> textFile.first() // 获取RDD文件textFile的第一行内容

scala> textFile.count() // 获取RDD文件textFile的所有项的计数

scala> val lineWithSpark=textFile.filter(line=>line.contains("Spark"))// 抽取含有“Spark”的行,返回一个新的RDD

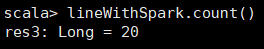
scala> lineWithSpark.count() //统计新的RDD的行数
4)可以通过组合RDD操作进行组合,可以实现简易MapReduce操作
scala> textFile.map(line=>line.split(" ").size).reduce((a,b)=>if(a>b) a else b) //找出文本中每行的最多单词数

5)退出Spark shell
:quit

Spark安装与部署的更多相关文章
- Spark入门实战系列--2.Spark编译与部署(中)--Hadoop编译安装
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .编译Hadooop 1.1 搭建环境 1.1.1 安装并设置maven 1. 下载mave ...
- Spark入门实战系列--2.Spark编译与部署(下)--Spark编译安装
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .编译Spark .时间不一样,SBT是白天编译,Maven是深夜进行的,获取依赖包速度不同 ...
- Spark安装部署(local和standalone模式)
Spark运行的4中模式: Local Standalone Yarn Mesos 一.安装spark前期准备 1.安装java $ sudo tar -zxvf jdk-7u67-linux-x64 ...
- CentOS6安装各种大数据软件 第十章:Spark集群安装和部署
相关文章链接 CentOS6安装各种大数据软件 第一章:各个软件版本介绍 CentOS6安装各种大数据软件 第二章:Linux各个软件启动命令 CentOS6安装各种大数据软件 第三章:Linux基础 ...
- Spark 安装部署与快速上手
Spark 介绍 核心概念 Spark 是 UC Berkeley AMP lab 开发的一个集群计算的框架,类似于 Hadoop,但有很多的区别. 最大的优化是让计算任务的中间结果可以存储在内存中, ...
- spark-2.2.0安装和部署——Spark集群学习日记
前言 在安装后hadoop之后,接下来需要安装的就是Spark. scala-2.11.7下载与安装 具体步骤参见上一篇博文 Spark下载 为了方便,我直接是进入到了/usr/local文件夹下面进 ...
- Spark学习(一) -- Spark安装及简介
标签(空格分隔): Spark 学习中的知识点:函数式编程.泛型编程.面向对象.并行编程. 任何工具的产生都会涉及这几个问题: 现实问题是什么? 理论模型的提出. 工程实现. 思考: 数据规模达到一台 ...
- Spark入门实战系列--2.Spark编译与部署(上)--基础环境搭建
[注] 1.该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取: 2.Spark编译与部署将以CentOS 64位操作系统为基础,主要是考虑到实际应用 ...
- Spark on Mesos部署
一.Mesos的安装和部署 1.下载mesos源码和依赖包 部署环境 centOS 6.6 mesos-0.21.0 spark-1.4.1 因为mesos官方只提供源码,所以必须要自己进行编译安装使 ...
随机推荐
- C++学习书籍推荐《C++编程思想第二版第一卷》下载
百度云及其他网盘下载地址:点我 编辑推荐 “经典原版书库”是响应教育部提出的使用原版国外教材的号召,为国内高校的计算机教学度身订造的.<C++编程思想>(英文版第2版)是书库中的一本,在广 ...
- wcf服务编程(一)
步骤一:定义契约 [ServiceContract] //定义服务契约 需要引用System.ServiceModel public interface ICalculator { [Operatio ...
- 剑指offer第二版-7.重建二叉树
描述:输入某二叉树的前序遍历和中序遍历结果,重建该二叉树.假设前序遍历或中序遍历的结果中无重复的数字. 思路:前序遍历的第一个元素为根节点的值,据此将中序遍历数组拆分为左子树+root+右子树,前序遍 ...
- J2EE:Servlet上传文件到服务器,并相应显示
Servlet 可以与HTML一起使用来允许用户上传文件到服务器 编辑上传文件的页面upload.html 注意事项:上传方式使用POST不能使用GET(GET不能上传文件) 表单 enctype 属 ...
- 使用gulp构建微信小程序工作流
前言 刚入门微信小程序的时候,一切都基于微信web开发者工具,没有使用其他框架,也没有工程化的概念.当时做的项目都比较简单,单单用微信web开发者工具倒也得心应手.学了些东西后,就按捺不住地想跳出原生 ...
- 【基本数据结构之堆】-C++
注意:这篇博客讲的是手写堆,喜欢用C++自带数据结构模拟的慎入 今天我们来聊一聊一种奇怪 的数据结构: 堆 为什么说这个数据结构有点奇怪呢? 先看看其他的在我眼里是正常的数据结构: 队列(近似于排队) ...
- Jsoup访问https网址异常SSLHandshakeException(已解决)
爬取网页遇到的目标站点证书不合法问题. 使用jsoup爬取解析网页时,出现了如下的异常情况. javax.net.ssl.SSLHandshakeException: sun.security.val ...
- RecycleView文字吸顶,点击吸顶布局刷新数据
实现效果 需求 Recycle有一个头布局,可以跟随列表进行滑动 点击头布局之后可以重新加载列表数据 随着头布局的消失,留下一个可点击的布局(该布局在头布局中) 效果类似下图: 淘宝的商品列表,随着我 ...
- SublimeText3 汉化
Sublime Text3 汉化 Sublime Text 作为一款方便的代码编辑软件广受大家喜爱,所以在自己在汉化成功后记录该方法,方便大家使用. 安装 一个插件 package control 即 ...
- Flink 从0到1学习—— Flink 不可以连续 Split(分流)?
前言 今天上午被 Flink 的一个算子困惑了下,具体问题是什么呢? 我有这么个需求:有不同种类型的告警数据流(包含恢复数据),然后我要将这些数据流做一个拆分,拆分后的话,每种告警里面的数据又想将告警 ...