
通过livy向CDH集群的spark提交任务
场景
产品中需要通过前端界面选择执行某种任务(spark任务),然后通过livy 的restful api 提交集群的spark任务
简单介绍下livy,翻译自官网:
Livy是基于Apache许可的一个服务,它可以让远程应用通过REST API比较方便的与Spark集群交互。通过简单的REST接口或RPC客户端库,它可以让你轻松的提交Spark作业或者Spark代码片段,同步或者异步的结果检索,以及SparkContext管理。Livy还简化了Spark和应用程序服务器之间的交互,从而为web/mobile应用简化Spark架构。
主要功能有:
1.由多个客户端为多个Spark作业使用长时间运行的SparkContexts。
2.同时管理多个SparkContexts,让它们在集群中(YARN/Mesos)运行,从而实现很好的容错和并发,而不是在Livy服务上运行。
3.预编译的jars,代码片段或者Java/Scala客户端API都可以用来提交作业。
4.安全认证的通信。(比如kerberos)
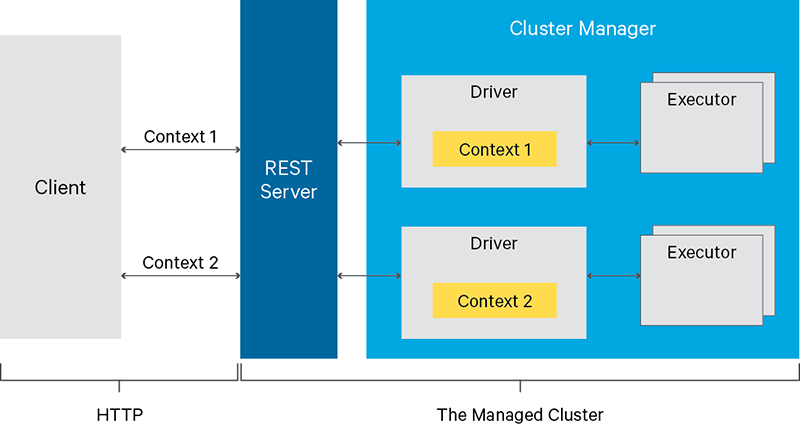
livy的rest api比较多(参考链接),这里介绍其中一种
代码如下:
<dependency>
	<groupId>org.apache.httpcomponents</groupId>
	<artifactId>httpclient</artifactId>
	<version>4.5.4</version>
</dependency>

<!-- https://mvnrepository.com/artifact/com.alibaba/fastjson -->
<dependency>
	<groupId>com.alibaba</groupId>
	<artifactId>fastjson</artifactId>
	<version>1.2.47</version>
</dependency>
package cn.com.dtmobile.livy;

import java.io.BufferedReader;
import java.io.DataOutputStream;
import java.io.IOException;
import java.io.InputStreamReader;
import java.net.HttpURLConnection;
import java.net.URL;

import com.alibaba.fastjson.JSON;
import com.alibaba.fastjson.JSONObject;

public class HttpUtils {

    public static HttpURLConnection init(HttpURLConnection conn){
        conn.setDoInput(true);
        conn.setDoOutput(true);
        conn.setRequestProperty("charset","utf-8");
        conn.setRequestProperty("Content-Type","application/json");
        return conn;
    }

    /**
     * HttpGET请求
     */
    public static JSONObject getAccess(String urlStr) {

        HttpURLConnection conn = null;
        BufferedReader in = null;
        StringBuilder builder = null;
        JSONObject response = null;
        try {
            URL url = new URL(urlStr);
            conn = init((HttpURLConnection) url.openConnection());
            conn.setRequestMethod("GET");
            conn.connect();

            in = new BufferedReader(new InputStreamReader(conn.getInputStream(), "utf-8"));
            String line = "";
            builder = new StringBuilder();
            while((line = in.readLine()) != null){
                builder.append(line);
            }

            response = JSON.parseObject(builder.toString());

        }catch (Exception e){
            e.printStackTrace();
        }finally {
            if (conn!=null)
                conn.disconnect();
            try {
                if (in != null)
                    in.close();
            } catch (IOException e) {
                e.printStackTrace();
            }
        }

        return response;
    }

    /**
     * HttpDelete请求
     */
    public static Boolean deleteAccess(String urlStr) {
        HttpURLConnection conn = null;
        try {
            URL url = new URL(urlStr);
            conn = init((HttpURLConnection) url.openConnection());
            conn.setRequestMethod("DELETE");
            conn.connect();

            conn.getInputStream().close();

            conn.disconnect();
        }catch (Exception e){
            e.printStackTrace();
            return false;
        }

        return true;
    }

    /**
     * HttpPost请求
     */
    public static String postAccess(String urlStr, JSONObject data)  {
        HttpURLConnection conn = null;
        BufferedReader in = null;
        StringBuilder builder = null;
        DataOutputStream out = null;
        try {
            URL url = new URL(urlStr);
            conn = init((HttpURLConnection) url.openConnection());
            conn.setRequestMethod("POST");
            conn.connect();

            out = new DataOutputStream(conn.getOutputStream());
            out.write(data.toString().getBytes("utf8"));
            out.flush();

            in = new BufferedReader(new InputStreamReader(conn.getInputStream(), "utf-8"));
            String line = "";
            builder = new StringBuilder();
            while((line = in.readLine()) != null){
                builder.append(line);
            }

        }catch (Exception e){
            e.printStackTrace();
        }finally {
            if (conn!= null)
                conn.disconnect();
            try {
                if (in!=null)
                    in.close();
                if (out!=null)
                    out.close();
            } catch (IOException e) {
                e.printStackTrace();
            }
        }
        if (builder != null)
            return builder.toString();
        return "";
    }

}
package cn.com.dtmobile.livy;

import com.alibaba.fastjson.JSON;
import com.alibaba.fastjson.JSONException;
import com.alibaba.fastjson.JSONObject;

public class LivyApp {

    static String host = "http://172.xx.x.xxx:8998";

    public static int submitJob() throws JSONException {
        JSONObject data = new JSONObject();

        JSONObject conf = new JSONObject();
        conf.put("spark.master","yarn-cluster");

        data.put("conf",conf);
        data.put("proxyUser","etluser");
        data.put("file","/kong/data/jar/your_jar.jar");// 指定执行的spark jar (hdfs路径)
        data.put("jars",new String[]{"/kong/data/jar/dbscan-on-spark_2.11-0.2.0-SNAPSHOT.jar"});//指定spark jar依赖的外部jars
        data.put("className", "cn.com.dtmobile.spark.App");
        data.put("name","jonitsiteplan");
        data.put("executorCores",3);
        data.put("executorMemory","2g");
        data.put("driverCores",1);
        data.put("driverMemory","4g");
        data.put("numExecutors",6);
        data.put("queue","default");
        data.put("args",new String[]{"杭州","yj_hangzhou","2019041719"});//传递参数

        String res = HttpUtils.postAccess(host + "/batches", data);

        JSONObject resjson = JSON.parseObject(res);
        System.out.println("id:"+resjson.getIntValue("id"));
        return resjson.getIntValue("id");
    }

    public static void getJobInfo(int id){
//        JSONObject response = HttpUtils.getAccess(host + "/batches/3");
//        System.out.print(response.toString(1));

//        JSONObject log = HttpUtils.getAccess(host + "/batches/3/log");
//        System.out.print(log.toString(1));

        JSONObject state = HttpUtils.getAccess(host + "/batches/"+id+"/state");
        System.out.println(state.getString("state"));
    }

    public static void killJob(int id){
        // 可以直接kill掉spark任务
        if(HttpUtils.deleteAccess(host+"/batches/"+id)) {
        	System.out.println("kill spark job success");
        }

    }

    public static void main(String[] args) {
    	int id  = submitJob();
    	while(true) {
    		try {
				getJobInfo(id);
				Thread.sleep(10000);
			} catch (InterruptedException e) {
			}
    	}

//    	killJob(9);
    }

}
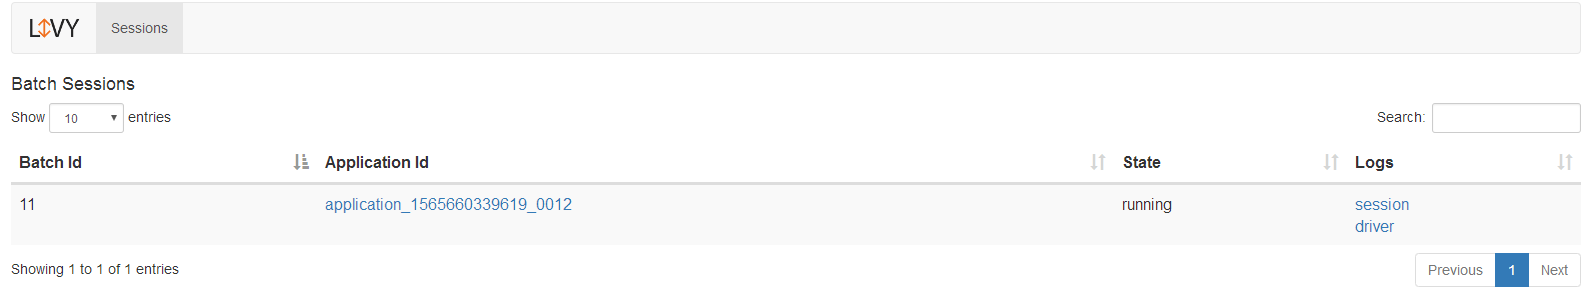
执行提交以后,可以在livy的UI界面上任务的状态,也可以通过api轮询的获取任务状态,以及任务的输出日志
yarn界面

通过livy向CDH集群的spark提交任务的更多相关文章
- CDH集群安装&测试总结
0.绪论 之前完全没有接触过大数据相关的东西,都是书上啊,媒体上各种吹嘘啊,我对大数据,集群啊,分布式计算等等概念真是高山仰止,充满了仰望之情,觉得这些东西是这样的: 当我搭建的过程中,发现这些东西是 ...
- CDH集群中YARN的参数配置
CDH集群中YARN的参数配置 前言:Hadoop 2.0之后,原先的MapReduce不在是简单的离线批处理MR任务的框架,升级为MapReduceV2(Yarn)版本,也就是把资源调度和任务分发两 ...
- CentOS7安装CDH 第七章:CDH集群Hadoop的HA配置
相关文章链接 CentOS7安装CDH 第一章:CentOS7系统安装 CentOS7安装CDH 第二章:CentOS7各个软件安装和启动 CentOS7安装CDH 第三章:CDH中的问题和解决方法 ...
- 相同版本的CDH集群间迁移hdfs以及hbase
前言 由于项目数据安全的需要,这段时间看了下hadoop的distcp的命令使用,不断的纠结的问度娘,度娘告诉我的结果也让我很纠结,都是抄来抄去, 还好在牺牲大量的时间的基础上还终于搞出来了,顺便写这 ...
- 朝花夕拾之--大数据平台CDH集群离线搭建
body { border: 1px solid #ddd; outline: 1300px solid #fff; margin: 16px auto; } body .markdown-body ...
- CDH集群频繁告警(host频繁swapping)
最近CDH集群频繁告警,原因是某些host频繁swapping,极大影响了集群的性能. 后来发现有个设置(/proc/sys/vm/swappiness)需要修改,默认值60 Setting the ...
- Cloudera Manager安装_搭建CDH集群
2017年2月22日, 星期三 Cloudera Manager安装_搭建CDH集群 cpu 内存16G 内存12G 内存8G 默认单核单线 CDH1_node9 Server || Agent ...
- CDH集群搭建部署
1. 硬件准备 使用了五台机器,其中两台8c16g,三台4c8g.一台4c8g用于搭建cmServer和NFS服务端,另外4台作为cloudera-manager agent部署CDH集群. ...
- Spark集群模式&Spark程序提交
Spark集群模式&Spark程序提交 1. 集群管理器 Spark当前支持三种集群管理方式 Standalone-Spark自带的一种集群管理方式,易于构建集群. Apache Mesos- ...
随机推荐
- I/O:ByteBuffer
ByteBuffer: static ByteBuffer allocate(int capacity) :分配一个新的字节缓冲区. static ByteBuffer allocateDirect( ...
- R语言矩阵
矩阵是元素布置成二维矩形布局的R对象. 它们包含相同原子类型的元素. R创建矩阵的语法: matrix(data, nrow, ncol, byrow, dimnames) 参数说明: data - ...
- 安卓开发之详解getChildFragmentManager和getsupportFragmentManager和getFragmentManager详解
安卓开发之详解getChildFragmentManager和getsupportFragmentManager和getFragmentManager详解 getFragmentManager()所得 ...
- [leetcode] 20. Valid Parentheses (easy)
原题链接 匹配括号 思路: 用栈,遍历过程中,匹配的成对出栈:结束后,栈空则对,栈非空则错. Runtime: 4 ms, faster than 99.94% of Java class Solut ...
- 从微信小程序开发者工具源码看实现原理(四)- - 自适应布局
从前面从微信小程序开发者工具源码看实现原理(一)- - 小程序架构设计可以知道,小程序大部分是通过web技术进行渲染的,也就是最终通过浏览器的dom tree + cssom来生成渲染树:既然最终是通 ...
- [学习笔记] NumPy走一趟(持续更)
Numpy学习笔记 之前没有花时间去专门学Numpy,都是用到什么就草草查一下,最近在学DeepLearning,就决定还是系统地把Numpy学一遍. 一.Numpy基础篇 https://www.r ...
- Spring中FactoryBean的作用和实现原理
BeanFactory与FactoryBean,相信很多刚翻看Spring源码的同学跟我一样很好奇这俩货怎么长得这么像,分别都是干啥用的.BeanFactory是Spring中Bean工厂的顶层接口, ...
- hdoj 4706 Children's Day
题目意思就是用a-z组成一个N,然后到z后又跳回a,输出宽从3到10的N. #include <stdio.h> #include <string.h> char s[14][ ...
- Django settings.py 配置文件详解
settings.py 配置文件 import os BASE_DIR = os.path.dirname(os.path.dirname(os.path.abspath(__file__))) #引 ...
- ASP.NET Core Identity自定义数据库结构和完全使用Dapper而非EntityFramework Core
前言 原本本节内容是不存在的,出于有几个人问到了我:我想使用ASP.NET Core Identity,但是我又不想使用默认生成的数据库表,想自定义一套,我想要使用ASP.NE Core Identi ...