
使用R语言预测产品销量
使用R语言预测产品销量
通过不同的广告投入,预测产品的销量。因为响应变量销量是一个连续的值,所以这个问题是一个回归问题。数据集共有200个观测值,每一组观测值对应一种市场情况。
数据特征
- TV:对于一个给定市场的单一产品,用于电视上的广告费用(以千为单位)
- Radio:用于广告媒体上投资的广告费用
- Newspaper:用于报纸媒体上的广告费用
响应
- Sales:对应产品的销量
加载数据
> data <- read.csv("http://www-bcf.usc.edu/~gareth/ISL/Advertising.csv",colClasses=c("NULL",NA,NA,NA,NA))

> head(data)

  TV Radio Newspaper Sales

1 230.1  37.8      69.2  22.1

2  44.5  39.3      45.1  10.4

3  17.2  45.9      69.3   9.3

4 151.5  41.3      58.5  18.5

5 180.8  10.8      58.4  12.9

6   8.7  48.9      75.0   7.2

# 显示Sales和TV的关系

> plot(data$TV, data$Sales, col="red", xlab='TV', ylab='sales')

# 用线性回归拟合Sales和TV广告的关系

> fit=lm(Sales~TV,data=data)

# 查看估算出来的系数

> coef(fit)

(Intercept)          TV

 7.03259355  0.04753664

# 显示拟合出来的模型的线

> abline(fit)

# 显示Sales和Radio的关系

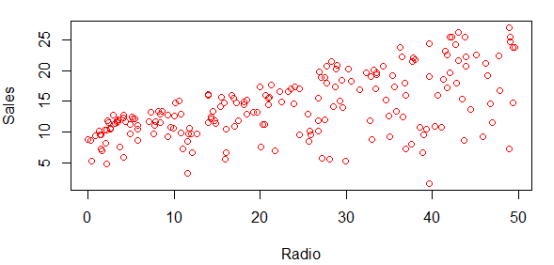
> plot(data$Radio, data$Sales, col="red", xlab='Radio', ylab='Sales')
# 用线性回归拟合Sales和Radio广告的关系

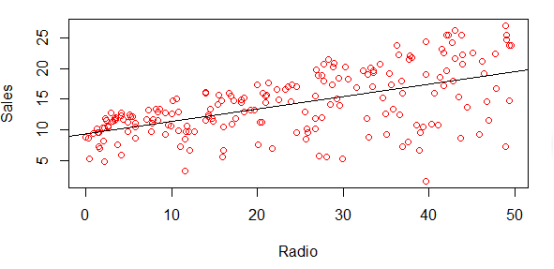
> fit1=lm(Sales~Radio,data=data)

# 查看估算出来的系数

> coef(fit1)

(Intercept)       Radio

  9.3116381   0.2024958

# 显示拟合出来的模型的线

> abline(fit1)
# 显示Sales和Newspaper的关系

> plot(data$Newspaper, data$Sales, col="red", xlab='Radio', ylab='Sales')

# 用线性回归拟合Sales和Radio广告的关系

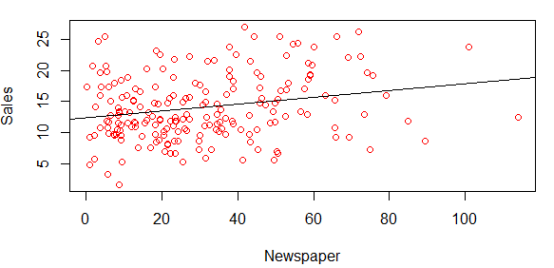
> fit2=lm(Sales~Newspaper,data=data)

# 查看估算出来的系数

> coef(fit2)

(Intercept)   Newspaper

 12.3514071   0.0546931

# 显示拟合出来的模型的线

> abline(fit2)
# 创建散点图矩阵

> pairs(~Sales+TV+Radio+Newspaper,data=data, main="Scatterplot Matrix")

第一行图形显示TV,Radio,Newspaper对Sales的影响。纵轴为Sales,横轴分别为TV,Radio,Newspaper。从图中可以看出,TV特征和销量是有比较强的线性关系的。
划分训练集和测试集
> trainRowCount <- floor(0.8 * nrow(data))

> set.seed(1)

> trainIndex <- sample(1:nrow(data), trainRowCount)

> train <- data[trainIndex,]

> test <- data[-trainIndex,]

> dim(data)

[1] 200   4

> dim(train)

[1] 160   4

> dim(test)

[1] 40  4
拟合线性回归模型
> model <- lm(Sales~TV+Radio+Newspaper, data=train)

> summary(model)

Call:

lm(formula = Sales ~ TV + Radio + Newspaper, data = train)

Residuals:

    Min      1Q  Median      3Q     Max

-8.7734 -0.9290  0.2475  1.2213  2.8971

Coefficients:

             Estimate Std. Error t value Pr(>|t|)

(Intercept)  2.840243   0.353175   8.042 2.07e-13 ***

TV           0.046178   0.001579  29.248  < 2e-16 ***

Radio        0.189668   0.009582  19.795  < 2e-16 ***

Newspaper   -0.001156   0.006587  -0.176    0.861

---

Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 1.745 on 156 degrees of freedom

Multiple R-squared:  0.8983,    Adjusted R-squared:  0.8963

F-statistic: 459.2 on 3 and 156 DF,  p-value: < 2.2e-16
预测和计算均方根误差
> predictions <- predict(model, test)

> mean((test["Sales"] - predictions)^2)

[1] 2.050666
特征选择
在之前的各变量和销量之间关系中,我们看到Newspaper和销量之间的线性关系比较弱,并且上面模型中Newspaper的系数为负数,现在去掉这个特征,看看线性回归预测的结果的均方根误差。
> model1 <- lm(Sales~TV+Radio, data=train)

> summary(model1)

Call:

lm(formula = Sales ~ TV + Radio, data = train)

Residuals:

    Min      1Q  Median      3Q     Max

-8.7434 -0.9121  0.2538  1.1900  2.9009

Coefficients:

            Estimate Std. Error t value Pr(>|t|)

(Intercept) 2.821417   0.335455   8.411 2.35e-14 ***

TV          0.046157   0.001569  29.412  < 2e-16 ***

Radio       0.189132   0.009053  20.891  < 2e-16 ***

---

Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 1.74 on 157 degrees of freedom

Multiple R-squared:  0.8983,    Adjusted R-squared:  0.897

F-statistic:   693 on 2 and 157 DF,  p-value: < 2.2e-16

> predictions1 <- predict(model1, test)

> mean((test["Sales"] - predictions1)^2)

[1] 2.050226
从上可以看到2.050226<2.050666,将Newspaper这个特征移除后,得到的均方根误差变小了,说明Newspaper不适合作为预测销量的特征,则去掉Newspaper特征后得到了新的模型。
使用R语言预测产品销量的更多相关文章
- R语言预测实战(游浩麟)笔记1
预测流程 确定主题.指标.主体.精度.周期.用户.成本和数据七要素. 收集数据.内容划分.收集原则. 选择方法.主要方法有自相关分析.偏相关分析.频谱分析.趋势分析.聚类分析.关联分析.相关分析.互相 ...
- R语言预测实战(第一章)
本例使用forecast包中自带的数据集wineind,它表示从1980年1月到1994年8月, 由葡萄酒生产商销售的容量不到1升的澳大利亚酒的总量.数据示意如下: #观察曲线簇 len=1993-1 ...
- R语言预测实战(第二章--预测方法论)
2.1预测流程 从确定预测主题开始,一次进行数据收集.选择方法.分析规律.建立模型.评估效果直到发布模型. 2.2.1确定主题 (1)指标:表达的是数量特征,预测的结果也通常是通过指标的取值来体现. ...
- R语言预测实战(游浩麟)笔记2
特征构建技术 特征变换,对原始的某个特征通过一定的规则或映射得到新特征的方法,主要方法包括概念分层.标准化.离散化.函数变换以及深入表达.特征变换主要由人工完成,属于比较基础的特征构建方法. 概念分层 ...
- 手把手教你学习R语言
本文为带大家了解R语言以及分段式的步骤教程! 人们学习R语言时普遍存在缺乏系统学习方法的问题.学习者不知道从哪开始,如何进行,选择什么学习资源.虽然网络上有许多不错的免费学习资源,然而它们多过了头,反 ...
- R语言︱XGBoost极端梯度上升以及forecastxgb(预测)+xgboost(回归)双案例解读
XGBoost不仅仅可以用来做分类还可以做时间序列方面的预测,而且已经有人做的很好,可以见最后的案例. 应用一:XGBoost用来做预测 ------------------------------- ...
- 基于R语言的时间序列分析预测
数据来源: R语言自带 Nile 数据集(尼罗河流量) 分析工具:R-3.5.0 & Rstudio-1.1.453 #清理环境,加载包 rm(list=ls()) library(forec ...
- 预测分析建模 Python与R语言实现
预测分析建模 Python与R语言实现 目录 前言 第1章 分析与数据科学1第2章 广告与促销10第3章 偏好与选择24第4章 购物篮分析31第5章 经济数据分析42第6章 运营管理56第7章 文本分 ...
- R语言利用ROCR评测模型的预测能力
R语言利用ROCR评测模型的预测能力 说明 受试者工作特征曲线(ROC),这是一种常用的二元分类系统性能展示图形,在曲线上分别标注了不同切点的真正率与假正率.我们通常会基于ROC曲线计算处于曲线下方的 ...
随机推荐
- ${FUNCNAME[@]}和$LINENO使用
$LINENO代表shell脚本的当前行号 [root@mysql-B ~]# cat test1.sh #!/bin/bash trap 'echo “before execute line:$LI ...
- 【MVC 笔记】MVC 自定义 Attribute 属性中的猫腻
原想在 MVC Action 上加一个自定义 Attribute 来做一些控制操作,最先的做法是在自定 Attribute 中定义一个属性来做逻辑判断,可惜事与愿违,这个属性值居然会被缓存起来,于是于 ...
- 一篇文章搞定JS类型转换
啥要说这个东西?一道面试题就给我去说它的动机.题如下: var bool = new Boolean(false); if (bool) { alert('true'); } else { alert ...
- Qt使Release版本可调试
只需在pro文件中加入 QMAKE_CXXFLAGS_RELEASE = $$QMAKE_CFLAGS_RELEASE_WITH_DEBUGINFO QMAKE_LFLAGS_RELEASE = $$ ...
- 针对TianvCms的搜索优化文章源码(无版权, 随便用)
介绍: 搜索优化虽然不是什么高深的技术, 真正实施起来却很繁琐, 后台集成搜索优化的文章可以便于便于管理, 也让新手更明白优化的步奏以及优化的日常. 特点: 根据自己的经验和查阅各种资料整理而成, 相 ...
- 分布式数据库中间件 MyCat 搞起来!
关于 MyCat 的铺垫文章已经写了三篇了: MySQL 只能做小项目?松哥要说几句公道话! 北冥有 Data,其名为鲲,鲲之大,一个 MySQL 放不下! What?Tomcat 竟然也算中间件? ...
- 在网页中添加动画,使用WOW.js来实现
[来源] 页面在向下滚动的时候,有些元素会产生细小的动画效果.虽然动画比较小,但却能吸引你的注意 刚知道wow.js这个插件,之前写的类似滚动时页面效果都是自己用jQuery写的,现在有了插件,开发更 ...
- 关于AI本质的思考
前言 最近几天和一位朋友探讨了一下现阶段的人工智能以及未来发展,并且仔细重读了尤瓦尔赫拉利的“简史三部曲”,产生了一些关于AI的新想法,觉得有必要整理出来. 程序.AI的本质 现代的计算机都是基于图灵 ...
- chromedriver配置
需要先安装chrome浏览器,添加chrome源 sudo vim /etc/yum.repos.d/google-chrome.repo 添加以下内容 [google-chrome] name=go ...
- Java 8 新特性-Stream更优雅的处理集合入门
Java 8 新特性之--Stream 一. 简单介绍 Stream是Java 8提出了的一种新的对集合对象功能的增强.它集合Lambda表达式,对集合提供了一些非常便利,高效的操作,使得代码具有非常 ...