
Python——Pandas速查手册中文版
转自——http://blog.csdn.net/qq_33399185/article/details/60872853,非常感谢大神的整理!
还有图片版,转自——https://zhuanlan.zhihu.com/p/27878128
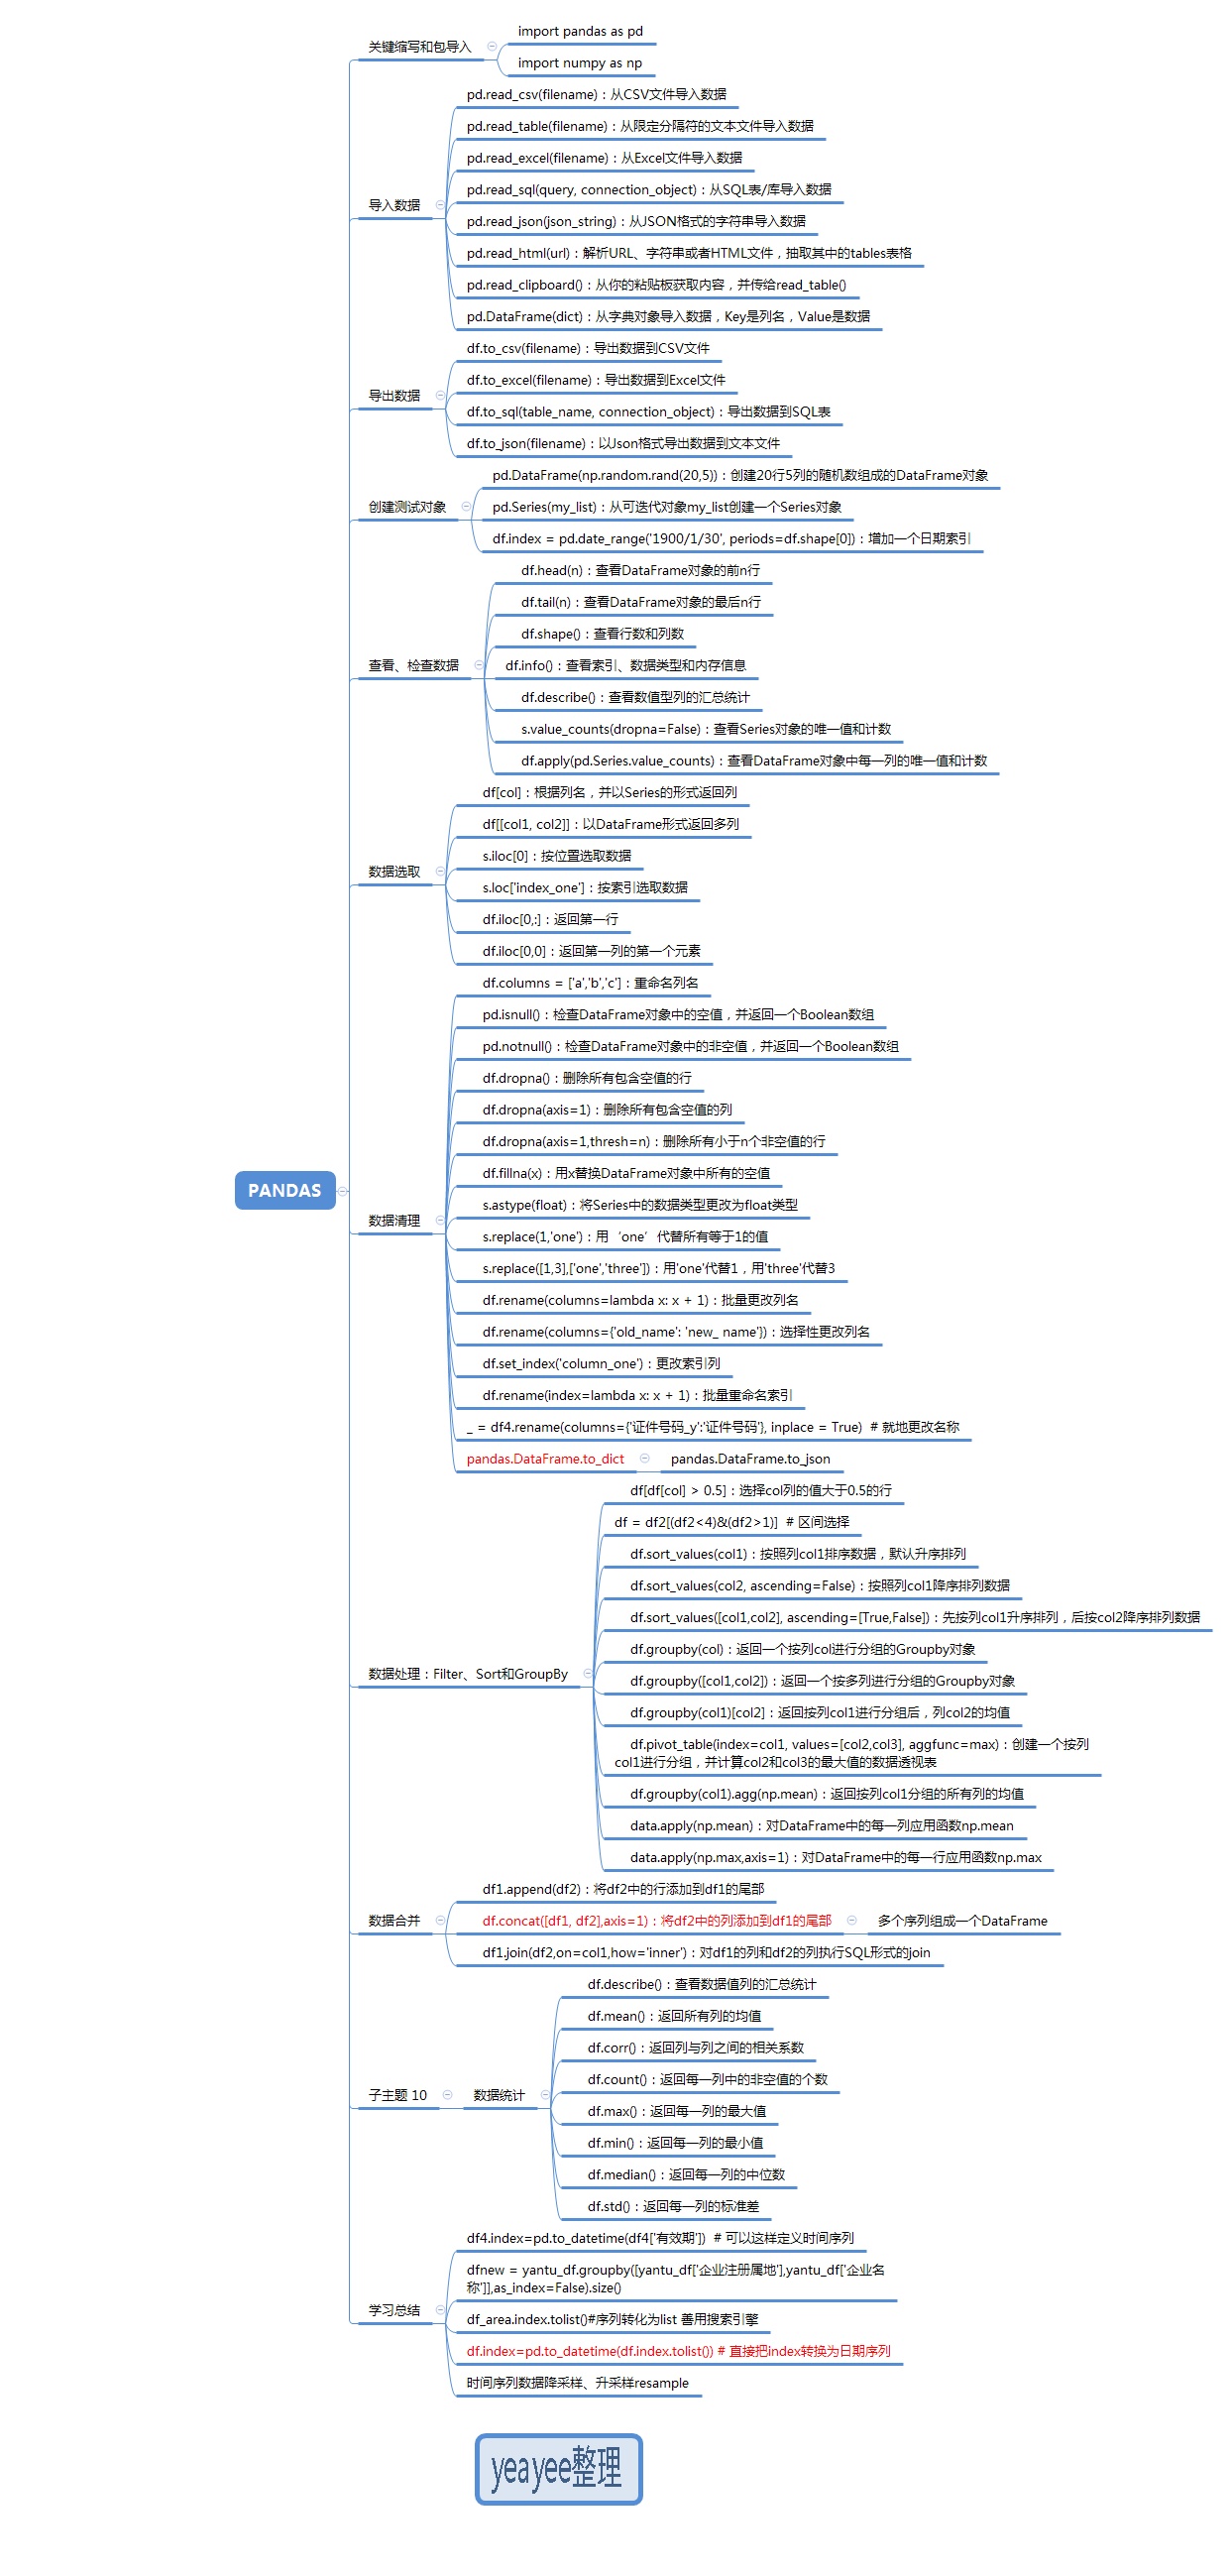
导入数据
- pd.read_csv(filename):从CSV文件导入数据
- pd.read_table(filename):从限定分隔符的文本文件导入数据
- pd.read_excel(filename):从Excel文件导入数据
- pd.read_sql(query, connection_object):从SQL表/库导入数据
- pd.read_json(json_string):从JSON格式的字符串导入数据
- pd.read_html(url):解析URL、字符串或者HTML文件,抽取其中的tables表格
- pd.read_clipboard():从你的粘贴板获取内容,并传给read_table()
- pd.DataFrame(dict):从字典对象导入数据,Key是列名,Value是数据
导出数据
- df.to_csv(filename):导出数据到CSV文件
- df.to_excel(filename):导出数据到Excel文件
- df.to_sql(table_name, connection_object):导出数据到SQL表
- df.to_json(filename):以Json格式导出数据到文本文件
创建测试对象
- pd.DataFrame(np.random.rand(20,5)):创建20行5列的随机数组成的DataFrame对象
- pd.Series(my_list):从可迭代对象my_list创建一个Series对象
- df.index = pd.date_range('1900/1/30', periods=df.shape[0]):增加一个日期索引
查看、检查数据
- df.head(n):查看DataFrame对象的前n行
- df.tail(n):查看DataFrame对象的最后n行
- df.shape():查看行数和列数
- http://df.info():查看索引、数据类型和内存信息
- df.describe():查看数值型列的汇总统计
- s.value_counts(dropna=False):查看Series对象的唯一值和计数
- df.apply(pd.Series.value_counts):查看DataFrame对象中每一列的唯一值和计数
数据选取
- df[col]:根据列名,并以Series的形式返回列
- df[[col1, col2]]:以DataFrame形式返回多列
- s.iloc[0]:按位置选取数据
- s.loc['index_one']:按索引选取数据
- df.iloc[0,:]:返回第一行
- df.iloc[0,0]:返回第一列的第一个元素
数据清理
- df.columns = ['a','b','c']:重命名列名
- pd.isnull():检查DataFrame对象中的空值,并返回一个Boolean数组
- pd.notnull():检查DataFrame对象中的非空值,并返回一个Boolean数组
- df.dropna():删除所有包含空值的行
- df.dropna(axis=1):删除所有包含空值的列
- df.dropna(axis=1,thresh=n):删除所有小于n个非空值的行
- df.fillna(x):用x替换DataFrame对象中所有的空值
- s.astype(float):将Series中的数据类型更改为float类型
- s.replace(1,'one'):用‘one’代替所有等于1的值
- s.replace([1,3],['one','three']):用'one'代替1,用'three'代替3
- df.rename(columns=lambda x: x + 1):批量更改列名
- df.rename(columns={'old_name': 'new_ name'}):选择性更改列名
- df.set_index('column_one'):更改索引列
- df.rename(index=lambda x: x + 1):批量重命名索引
数据处理:Filter、Sort和GroupBy
- df[df[col] > 0.5]:选择col列的值大于0.5的行
- df.sort_values(col1):按照列col1排序数据,默认升序排列
- df.sort_values(col2, ascending=False):按照列col1降序排列数据
- df.sort_values([col1,col2], ascending=[True,False]):先按列col1升序排列,后按col2降序排列数据
- df.groupby(col):返回一个按列col进行分组的Groupby对象
- df.groupby([col1,col2]):返回一个按多列进行分组的Groupby对象
- df.groupby(col1)[col2]:返回按列col1进行分组后,列col2的均值
- df.pivot_table(index=col1, values=[col2,col3], aggfunc=max):创建一个按列col1进行分组,并计算col2和col3的最大值的数据透视表
- df.groupby(col1).agg(np.mean):返回按列col1分组的所有列的均值
- data.apply(np.mean):对DataFrame中的每一列应用函数np.mean
- data.apply(np.max,axis=1):对DataFrame中的每一行应用函数np.max
数据合并
- df1.append(df2):将df2中的行添加到df1的尾部
- df.concat([df1, df2],axis=1):将df2中的列添加到df1的尾部
- df1.join(df2,on=col1,how='inner'):对df1的列和df2的列执行SQL形式的join
数据统计
- df.describe():查看数据值列的汇总统计
- df.mean():返回所有列的均值
- df.corr():返回列与列之间的相关系数
- df.count():返回每一列中的非空值的个数
- df.max():返回每一列的最大值
- df.min():返回每一列的最小值
- df.median():返回每一列的中位数
- df.std():返回每一列的标准差
Python——Pandas速查手册中文版的更多相关文章
- Pandas速查手册中文版
本文翻译自文章: Pandas Cheat Sheet - Python for Data Science ,同时添加了部分注解. 对于数据科学家,无论是数据分析还是数据挖掘来说,Pandas是一个非 ...
- 三、Pandas速查手册中文版
本文翻译自文章:Pandas Cheat Sheet - Python for Data Science,同时添加了部分注解. 对于数据科学家,无论是数据分析还是数据挖掘来说,Pandas是一个非常重 ...
- pandas速查手册(中文版)
本文翻译自文章:Pandas Cheat Sheet - Python for Data Science 对于数据科学家,无论是数据分析还是数据挖掘来说,Pandas是一个非常重要的Python包.它 ...
- 【转】Pandas速查手册中文版
本文翻译自文章:Pandas Cheat Sheet - Python for Data Science,同时添加了部分注解. 对于数据科学家,无论是数据分析还是数据挖掘来说,Pandas是一个非常重 ...
- Pandas速查手册中文版(转)
关键缩写和包导入 在这个速查手册中,我们使用如下缩写: df:任意的Pandas DataFrame对象 同时我们需要做如下的引入: import pandas as pd 导入数据 pd.read_ ...
- 4、numpy+pandas速查手册
<Python数据分析常用手册>一.NumPy和Pandas篇 一.常用链接: 1.Python官网:https://www.python.org/2.各种库的whl离线安装包:http: ...
- 程序员 & 设计师都能用上的 75 份速查手册
分享75份开发人员和设计师会用到的速查手册,由 vikas 收集整理,包括:jQuery.HTML.HTML5.CSS.CSS3.JavaScript.Photoshop .git.Linux.Jav ...
- 《zw版·Halcon-delphi系列原创教程》 zw版-Halcon常用函数Top100中文速查手册
<zw版·Halcon-delphi系列原创教程> zw版-Halcon常用函数Top100中文速查手册 Halcon函数库非常庞大,v11版有1900多个算子(函数). 这个Top版,对 ...
- 25个有用的和方便的 WordPress 速查手册
如果你是 WordPress 开发人员,下载一些方便的 WordPress 备忘单可以在你需要的时候快速查找.下面这个列表,我们已经列出了25个有用的和方便的 WordPress 速查手册,赶紧收藏吧 ...
随机推荐
- CodeForces-38B-Chess枚举+思维
CodeForces-38B-Chess 这是一道与下象棋有关的题目,题意是给你一个车和马的坐标,然后再给你一个马,让你判断最后三者都不会被吃掉的可能性,注意的是三者是三个独立的个体. 这道题要知道一 ...
- HZNU Training 1 for Zhejiang Provincial Collegiate Programming Contest
赛后总结: TJ:今天我先到实验室,开始看题,一眼就看了一道防AK的题目,还居然觉得自己能做wwww.然后金姐和彭彭来了以后,我和他们讲了点题目.然后金姐开始搞dfs,我和彭彭看榜研究F题.想了很久脑 ...
- CF 990D Graph And Its Complement 第十八 构造、思维
Graph And Its Complement time limit per test 2 seconds memory limit per test 256 megabytes input sta ...
- webpack4 公共模块打包,怎么抽取出来一个需要经常修改的包
项目中有一个需求: 所有页面引用了一个公共ad.js 因为广告需要不断投放新渠道,所以ad.js需要经常上线更新,这样会导致打包出来的 commons.js经常更新,缓存一下无效了.所以急需将ad.j ...
- 变量的范围 namespace
变量的范围 范围 变量有 菊部变量 和 全局变量之分, local variable 和 global variable 一般在函数体外定义的变量是全局的,函数体内定义的变量只能在函数内使用 注意:在 ...
- try(){}自动释放资源,AutoCloseable
我们在使用资源的时候,必须关闭资源,比如使用jdbc连接或者inputStream的时候,必须在finally中将资源关闭.然而有的时候我们会忘记关闭资源.那么有没有更好的方法呢? SqlSessio ...
- sql 单表distinct/多表group by查询去除重复记录
单表distinct 多表group by group by 必须放在 order by 和 limit之前,不然会报错 下面先来看看例子: table id name 1 a 2 b ...
- nexus 私服 低配置服务器启动不能访问的问题
1核1G的渣渣服务器启动无法访问. 请更换更高配置的服务器.
- Winform中对ZedGraph的曲线标签进行设置,比如去掉标签边框
场景 Winforn中设置ZedGraph曲线图的属性.坐标轴属性.刻度属性: https://blog.csdn.net/BADAO_LIUMANG_QIZHI/article/details/10 ...
- Sublime Text 3 中实现编译C语言程序
这个是真坑,感觉用devc++写c程序特别的不爽,所以就用了sublime,但是,编译的时候又有不少问题, 下面就把我踩的坑记录下来 tools>Build System>New Buil ...