
python 堆排序
堆排序就是把堆顶的最大数取出,
将剩余的堆继续调整为最大堆,具体过程在第二块有介绍,以递归实现
剩余部分调整为最大堆后,再次将堆顶的最大数取出,再将剩余部分调整为最大堆,这个过程持续到剩余数只有一个时结束
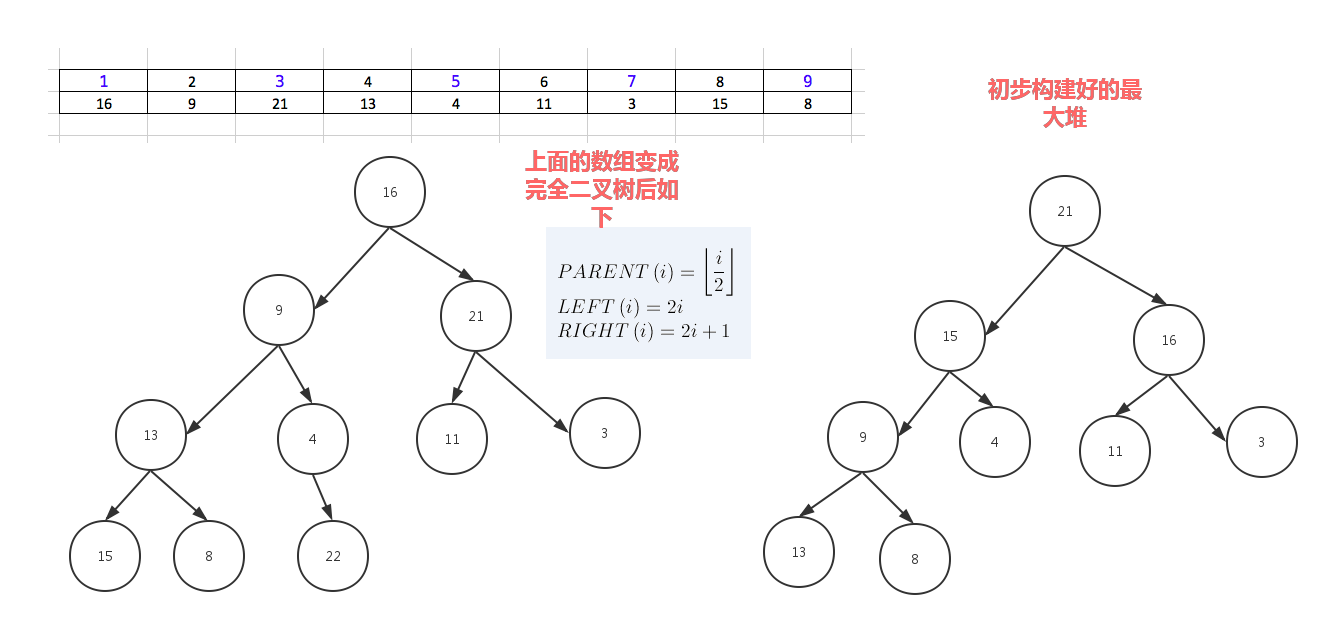
dataset = [16,9,21,3,13,14,23,6,4,11,3,15,99,8,22]

for i in range(len(dataset)-1,0,-1):

    print("-------",dataset[0:i+1],len(dataset),i)

    #for index in range(int(len(dataset)/2),0,-1):

    for index in range(int((i+1)/2),0,-1):

        print(index)

        p_index = index

        l_child_index = p_index *2 - 1

        r_child_index = p_index *2

        print("l index",l_child_index,'r index',r_child_index)

        p_node = dataset[p_index-1]

        left_child =  dataset[l_child_index]

        if p_node < left_child:  # switch p_node with  left child

            dataset[p_index - 1], dataset[l_child_index] = left_child, p_node

            # redefine p_node after the switch ,need call this val below

            p_node = dataset[p_index - 1]

        if r_child_index < len(dataset[0:i+1]): #avoid right out of list index range

            right_child =  dataset[r_child_index]

            print(p_index,p_node,left_child,right_child)

            if p_node < right_child: #swith p_node with right child

                dataset[p_index - 1] , dataset[r_child_index] = right_child,p_node

                # redefine p_node after the switch ,need call this val below

                p_node = dataset[p_index - 1]

        else:

            print("p node [%s] has no right child" % p_node)

    #最后这个列表的第一值就是最大堆的值,把这个最大值放到列表最后一个, 把神剩余的列表再调整为最大堆

    print("switch i index", i, dataset[0], dataset[i] )

    print("before switch",dataset[0:i+1])

    dataset[0],dataset[i] = dataset[i],dataset[0]

    print(dataset)
堆排序详解:http://www.cnblogs.com/0zcl/p/6737944.html
python 堆排序的更多相关文章
- python堆排序
堆是完全二叉树 子树是不相交的 度 节点拥有子树的个数 满二叉树: 每个节点上都有子节点(除了叶子节点) 完全二叉树: 叶子结点在倒数第一层和第二层,最下层的叶子结点集中在树的左部 ,在右边的话,左子 ...
- python堆排序实现TOPK问题
# 构建小顶堆跳转def sift(li, low, higt): tmp = li[low] i = low j = 2 * i + 1 while j <= higt: # 情况2:i已经是 ...
- python3数据结构与算法
python内置的数据结构包括:列表(list).集合(set).字典(dictionary),一般情况下我们可以直接使用这些数据结构,但通常我们还需要考虑比如搜索.排序.排列以及赛选等一些常见的问题 ...
- 排序NB三人组
排序NB三人组 快速排序,堆排序,归并排序 1.快速排序 方法其实很简单:分别从初始序列“6 1 2 7 9 3 4 5 10 8”两端开始“探测”.先从右往左找一个小于6的数,再从左往 ...
- Python3 实例
一直以来,总想写些什么,但不知从何处落笔. 今儿个仓促,也不知道怎么写,就把手里练习过的例子,整理了一下. 希望对初学者有用,都是非常基础的例子,很适合初练. 好了,Follow me. 一.Pyth ...
- 数据结构:堆排序 (python版) 小顶堆实现从大到小排序 | 大顶堆实现从小到大排序
#!/usr/bin/env python # -*- coding:utf-8 -*- ''' Author: Minion-Xu 小堆序实现从大到小排序,大堆序实现从小到大排序 重点的地方:小堆序 ...
- 你需要知道的九大排序算法【Python实现】之堆排序
六.堆排序 堆排序是一种树形选择排序,是对直接选择排序的有效改进. 堆的定义下:具有n个元素的序列 (h1,h2,...,hn),当且仅当满足(hi>=h2i,hi>=2i+1)或(h ...
- python下实现二叉堆以及堆排序
python下实现二叉堆以及堆排序 堆是一种特殊的树形结构, 堆中的数据存储满足一定的堆序.堆排序是一种选择排序, 其算法复杂度, 时间复杂度相对于其他的排序算法都有很大的优势. 堆分为大头堆和小头堆 ...
- 高速排序,归并排序,堆排序python实现
高速排序的时间复杂度最好情况下为O(n*logn),最坏情况下为O(n^2),平均情况下为O(n*logn),是不稳定的排序 归并排序的时间复杂度最好情况下为O(n*logn),最坏情况下为O(n*l ...
随机推荐
- Entity Framework Core 2.1 Preview1 新增功能简介
两个星期前,微软发布了EF Core 2.1 Preview 1,同时还发布了.NET Core 2.1 Preview 1和ASP.NET Core 2.1 Preview 1:EF Core 2. ...
- 【BZOJ1968】约数研究(数论)
[BZOJ1968]约数研究(数论) 题面 BZOJ链接(题目是图片形式的) 题解 傻逼题 \(NOIP\) \(T1\)难度 不会做的话您可以退役 #include<iostream> ...
- [ZJOI2014]力
推公式发现(这不是水题吗,这要推吗) \[E_i=\Sigma^{i-1}_{j=1} \frac{q_j}{(i-j)^2} - \Sigma^{n}_{j=i+1} \frac{q_j}{(i-j ...
- TypeScript入门知识五(面向对象特性二)
1.泛型(generic) 参数化的类型,一般用来限制集合的内容 class Person { constructor(private name: string) { } work() { }}var ...
- asp.net mvc 5 关闭xss过滤
在控制器方法的头部添加 [ValidateInput(false)] 如果向mvc服务端提交带html标签的内容就会导致校验失败异常,从而得不到想要的结果,关闭的方法是在相应方法头部添加 ...
- JS获取当前周
var now = new Date() var weekFirstDay = new Date(now- (now.getDay() - 1) * 86400000) var firstMonth ...
- HDFS基本原理总结
HDFS由三个基本组件组成:NameNode,SecondaryName,DataNode,其思想类似于Linux的文件系统,可以进行类比. 1.NameNode介绍: 1.管理整个文件系统的命名空间 ...
- WBS
Need 需求分析: 为了满足中老年人因工作忙碌而无暇阅读的痛苦,我们设计推广出一款听书软件.可以给中老年人带来的好处是不再受繁琐的听书软件的束缚,操作简单,携带便捷. Approach 实现方法: ...
- pycharm创建Flask项目,jinja自动补全,flask智能提示
pycharm创建Flask项目,jinja自动补全,flask智能提示 之前一直都是用在idea里创建空项目然后导入,之后就没有各种的智能提示,在选择文类,选择模板之类的地方就会很麻烦. 步骤1:用 ...
- python装饰器使用
看了不少python关于装饰器文章,觉得还挺实用,发贴来mark一下(以前做笔记总会长时间不看就忘记,放这里应该不会忘了吧 - -) 先来看一个简单的知识点: def a(): print(" ...