
Spark-1.X编译构建及配置安装
前提条件(环境要求)
jdk版本:1.7+
scala版本:1.10.4+
maven版本:3.3.3+
本博客中使用的软件版本
spark版本:spark-1.6.1.tar.gz(源码)
jdk版本:jdk-8u151-linux-x64.tar.gz
maven版本:apache-maven-3.3.9.tar.gz
scala版本:scala-2.10.4.tgz
以上软件都可以到官网下载
本文章约束两个目录
/opt/softwares 安装包
/opt/modules 安装的目录
编译方式:
打包编译make-distribution.sh
一、环境配置
1、将spark、jdk、maven、scala软件包上传到Linux系统指定的目录:/opt/softwares/
2、maven安装与配置
tar -zxvf apache-maven-3.3.9.tar.gz -C /opt/modules
在/etc/profile配置文件中最底部配置以下信息
#MAVEN#
export MAVEN_HOME=/opt/modules/apache-maven-3.3.9
export PATH=$PATH:$MAVEN_HOME/bin
3 、java安装与配置
tar -zxvf jdk-8u151-linux-x64.tar.gz -C /opt/modules
在/etc/profile配置文件中最底部配置以下信息
#JAVA_HOME#
export JAVA_HOME=/opt/modules/jdk1.8.0_151
export CLASSPATH=.:$JAVA_HOME/jre/lib/rt.jar:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar
export PATH=$PATH:$JAVA_HOME/bin
4、scala安装与配置
tar -zxvf scala-2.10.4.tgz -C /opt/modules
在/etc/profile配置文件中最底部配置以下信息
#scala#
export SCALA_HOME=/opt/modules/scala-2.10.4
export PATH=$PATH:$SCALA_HOME/bin
5、maven仓库配置
将repository-1.6.1.zip解压到~/.m2文件夹中
6、解压spark源码包
tar -zxvf spark-1.6.1.tar.gz -C /opt/modules
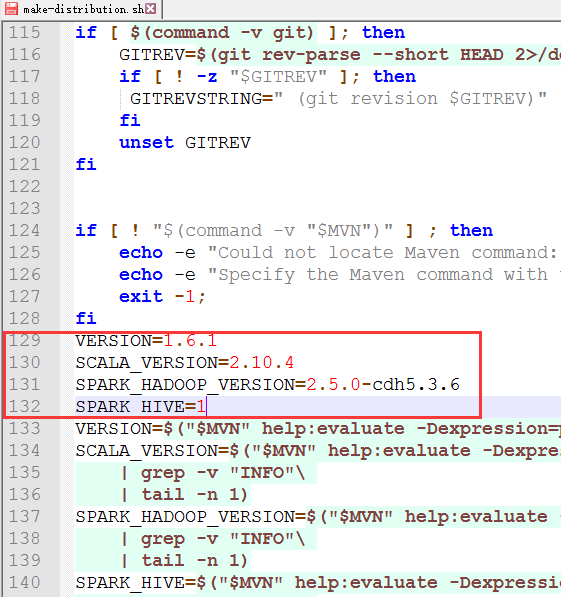
7、修改make-distribution.sh文件内容(在/opt/modules/spark-1.6.1目录中)
在129行添加以下内容
VERSION=1.6.1
SCALA_VERSION=2.10.4
SPARK_HADOOP_VERSION=2.5.0-cdh5.3.6
SPARK_HIVE=1
note:
SCALA_VERSION配置上你的scala的版本, 可能是2.10.x 或者2.11.x
SPARK_HADOOP_VERSION配置上你的hadoop版本
SPARK_HIVE 1表示需要将hive的打包进去, 非1数字表示不打包hive
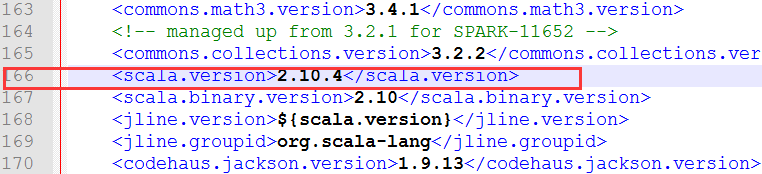
8、修改pom.xml文件 (在/opt/modules/spark-1.6.1目录中)
在166行 scala版本修改成你对应的版本 我这里是修改成 2.10.4
在2522行 scala版本修改成你对应的版本 我这里是修改成 2.10.4

9、添加依赖服务文件
前提:使用的scala版本是2.10.4,pom.xml文件中也进行了修改
复制scala-2.10.4.tgz和zinc-0.3.5.3.tgz到spark根目录的build文件夹中, 并解压
10、编译spark
在spark目录中执行命令
./make-distribution.sh --tgz \
-Phadoop-2.4 \
-Dhadoop.version=2.5.0-cdh5.3.6 \
-Pyarn \
-Phive -Phive-thriftserver
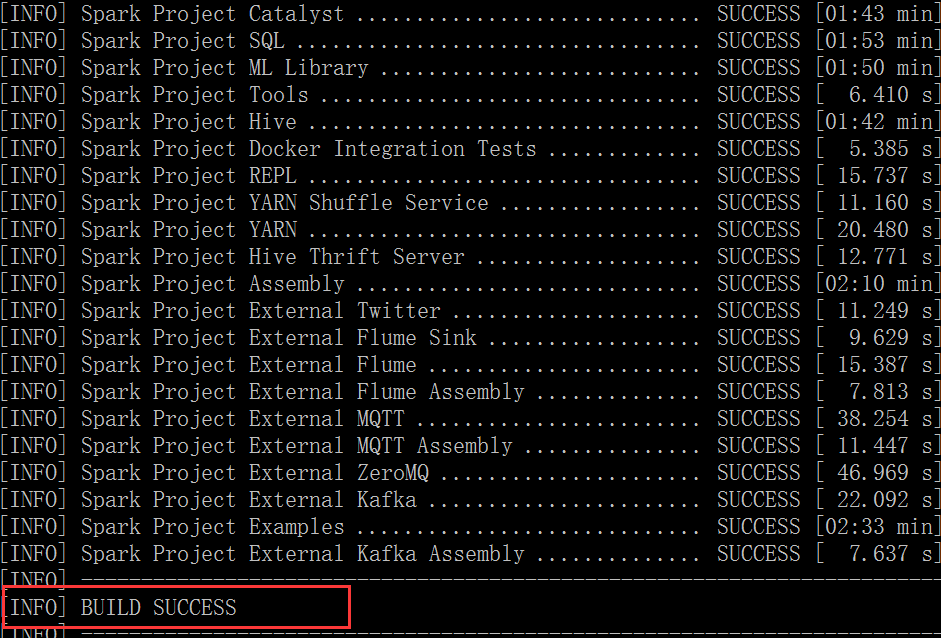
11、最终spark编译成功标志
12、需要注意的几点
1)如果maven不是国内的镜像下载会比较慢 ,建议改成国内镜像
配置镜像(修改settings.xml文件)
<mirror>
<id>aliyun</id>
<mirrorOf>central</mirrorOf>
<name>aliyun repository</name>
<url>http://maven.aliyun.com/nexus/content/groups/public/</url>
</mirror>
<mirror> <!– cdh 版本编译 可选指定-->
<id>cloudera</id>
<mirrorOf>central</mirrorOf>
<name>cloudera repository</name>
<url>https://repository.cloudera.com/artifactory/cloudera-repos/</url>
</mirror>
2)配置域名解析服务器
# vi /etc/resolv.conf
内容:
nameserver 8.8.8.8
nameserver 8.8.4.4
3)编译可能出现的问题
在编译的过程中,可能卡死,然后不进行编译的情况出现,如果超过十分钟没有动静的话,可以考虑是否是编译出现问题。问题出现
原因是:网络不好、机器内存不够、其他原因。解决方案:
1. 关闭编译的进程。直接退出当前会话,然后从新进入在编译。
2. 添加虚拟机内存(最好4G+),重启虚拟机再编译
Spark-1.X编译构建及配置安装的更多相关文章
- wxwidgets编译及环境配置
wxwidgets编译及环境配置 安装步骤: 到www.CodeBlocks.org下载并安装CodeBlocks,最好下载MinGW版本的,可以省掉安装和配置GCC的麻烦. 到www.wxWidge ...
- wxWidgets的安装编译、相关配置、问题分析处理
wxWidgets的安装编译.相关配置.问题分析处理 一.介绍部分 (win7 下的 GUI 效果图见 本篇文章的最后部分截图2张) wxWidgets是一个开源的跨平台的C++构架库(framewo ...
- oozie配置安装与原理
概述 当前开源的hadoop任务工作流管理主要有oozie和Azkaban,本文先介绍oozie的配置安装与基本运行原理. 配置安装 (参考https://segmentfault.com/a/11 ...
- pbuilder编译构建工具分析
1. 简介 pbuilder(personal Debian package builder)是ubuntu环境下维护debian包的专业工具,能够为每个deb包创建纯净的编译构建环境,自动解析和安装 ...
- 《Linux操作系统编译构建指南》
在线阅读地址:http://www.doc88.com/p-5126905896771.html Linux编译构建定制qq群: 521902245 文件夹...0 前言...3 第零章 绪论...5 ...
- Linux 的软件管理及配置 - 安装、卸载、升级、依赖
1. 对比:Windows 和 Linux 上软件的安装与卸载 大部分 Linux 使用者都是从 Windows 转过来的,先对这俩做个对比,有助理解. 就像在 Windows 下,很多软件也有安装版 ...
- 如何在Idea中编译构建Spring Framework 5.x
如何在Idea中编译构建Spring Framework 5.x 安装配置Gradle(略) 下载源码:git clone https://github.com/spring-projects/spr ...
- Spark历险记之编译和远程任务提交
Spark简介 Spark是加州大学伯克利分校AMP实验室(Algorithms, Machines, and People Lab)开发通用内存并行计算框架.Spark在2013年6月进入Apach ...
- 分布式文件系统 - FastDFS 在 CentOS 下配置安装部署
少啰嗦,直接装 看过上一篇分布式文件系统 - FastDFS 简单了解一下的朋友应该知道,本次安装是使用目前余庆老师开源的最新 V5.05 版本,是余庆老师放在 Github 上的,和目前你能在网络上 ...
随机推荐
- python集合深浅copy
一,集合. 集合是无序的,不重复的数据集合,它里面的元素是可哈希的(不可变类型),但是集合本身是不可哈希(所以集合做不了字典的键)的.以下是集合最重要的两点: 去重,把一个列表变成集合,就自动去重了. ...
- mybatis-spring整合
1. 配置jar包 Spring,mybatis,mybatis-spring,mysql等... <properties> <project.build.sourceEncodin ...
- 【Unity3D与23种设计模式】策略模式(Strategy)
GoF中定义: "定义一组算法,并封装每个算法,让它们之间可以彼此交换使用. 策略模式让这些算法在客户端使用它们时能更加独立." 游戏开发过程中 不同的角色会有不同的属性计算方法 ...
- IPFS的竞争对手们(一)
IPFS的竞争对手 IPFS这个项目真的开发很慢,相比其它区块链项目,IPFS的进度可真是让小编捉急,恨铁不成钢啊.然而小编仍然对他们充满信心,来,借用一句盗梦空间里的经典台词: 既然做梦,那就做大点 ...
- C语言的隐式类型转换
看了一篇博文,该文章中有如下描述 #include <stdio.h> int main() { unsigned ; unsigned ; )) //a和b-1的结果-1都被转换为int ...
- 深入剖析Nodejs的异步IO
前言:Nodejs最赖以自豪的优势莫过于"单线程实现异步IO"了,也许你仍然丈二和尚摸不着头脑,Nodejs自我标榜是单线程,还能实现异步IO操作,这两者难道不是相互矛盾的么?葫芦 ...
- 使用pm2躺着实现负载均衡
事实上,pm2 是一个带有负载均衡功能的Node应用的进程管理器,Node实现进程管理的库有很多,forever也是其中一个很强大但是也相对较老的进程管理器. 为什么要使用pm2 对于这个问题,先说说 ...
- 【Windows】 Windows系统小积累
因为用Windows大多都是处理些个人事务,有很多东西搜过用过就忘了,不记住也可惜了还是记录一下 比较好 ■ win键+一个键的快捷打开方式 win键+q是搜索的快捷键,win键+r是运行的快捷键.而 ...
- linux拓展下:批量改扩展名的方法
[root@oldboy oldboy]# ll total 0 -rw-r--r-- 1 root root 0 Nov 13 19:38 stu_102999_1_.jpg -rw-r--r-- ...
- Algorithm --> 十大排序算法
十大排序算法 主要排序法有: 一.冒泡( Bubble)排序—— 相邻交换 二.选择排序 ——每次最小/ 大排在相应的位置 三.插入排序 ——将下一个插入已排好的序列中 四.壳( Shell) ...