
Scalding初探之二:动手来做做小实验
输入文件
Scalding既可以处理HDFS上的数据,也可以很方便地在本地运行处理一些test case便于debug,Source有好多种
1 TextLine(filename)
TextLine(args("input"))或者TextLine("~/data/input.txt")
对每行数据,产生包含'line和'offset两个field的tuple
2 Csv和Tsv
本地文件和HDFS文件都可以用,读时可以指定field名
Tsv(args("input"), ('userid, 'computerguid, 'event, 'json)).read
第一行如果有headers还可以自动处理field名
3 WritableSequenceFile
读取HDFS上的Sequence压缩文件,将每一行解析为(Long, String)
WritableSequenceFile(args("input"), ('serialNo, 'data))
4 IterableSource
由scala的Iterable变量创建pipe
IterableSource(List(4,8,15,16,23,42), 'foo)
创建名为'foo的field
5 NullSource
Scalding有一个隐蔽的优化,如果job中对一个pipe进行变换而最终没有write到任何地方,这段中间代码就不会被执行,如果job中一个write操作就直接抛异常了。
如果分布式计算程序只是为了产生side effect,而不需要将pipe变换的结果,比如说这种场景,仅仅从HDFS读取一些计算结果,然后将进一步计算的数据发送到数据可视化平台,又或者你只是想打印pipe的前几行Csv(input).limit(10).debug,这种优化就是一个坑了。
因此你需要Csv(input).limit(10).debug.write(NullSource)来确保side effect被执行
更多请参考Scalding-Sources, Field rules
reduce和foldLeft的区别
reduce函数必须是associative的,类似combiner,会先在map side做中间结果合并的工作。
foldLeft函数可以不是associative的,而且output的类型可以与input类型不同,结果合并只在reduce side发生。
scald.rb有坑请注意
这个不知道为啥在我这儿不能使,倒腾了几次提示我可以scald.rb --clean看看
于是乎悲剧就发生了,这个操作删除了maven下载的一系列包,对于本月已经流量超了24个G的妹子来说是沉重的打击,龟速更新完之后其他job也跑不了了,悲愤
error: error while loading <root>, error in opening zip file
error: scala.tools.nsc.MissingRequirementError: object scala not found.
一开始看了Stackoverflow上面的讨论
Scala SBT / Maven2 Error on OSX: “Error Opening Zip File” -> MissingRequirementError
然后冲过去把scalac -classpath 后面跟的jar包全都chmode a+rwx了一把,我了个。。。。。。。。。完全没用!而且~/.sbt/boot/scala-2.9.3/这个目录根本就没有蒙谁呢。。。
然后看这个 Running your Scalding jobs in Eclipse
本地写法:
Eclipse runtime configuration:
Main class: com.twitter.scalding.Tool

Program Args: <Fully Qualified Path to Job Class> <Other CLI Args>

Example: org.hokiesuns.scaldingtest.WordCountJob --local --input ./input/input.txt --output ./output.txt

VM Args: -Xmx3072m
Hadoop写法:
hadoop jar scaldingsample-0.0.1-SNAPSHOT.jar org.hokiesuns.scaldingtest.WordCountJob --hdfs --input <some path> --output <some path>
又参考这个Using IntelliJ with Twitter’s Scalding
I am able to do a local or local-hdfs run from the sbt-console:
|
1
2
|
> run-main com.twitter.scalding.Tool com.wordnik.WordCountJob --local --input doc.txt --output /tmp/notice.tsv> run-main com.twitter.scalding.Tool com.wordnik.WordCountJob --hdfs --input doc.txt --output /tmp/NOTICE_JOB |
Note that the syntax is slightly different from the the Ruby scald.rb script — local hdfs mode is indicated with ‘–hdfs’. You’ll probably often want to run sbt with more memory than this.
想着是不是可以像唐大神一样完全抛弃scald.rb自己写个bash脚本运行scalding job啊。。。
各种方法未果决定重新编译scalding,从19:05开始借流量,到22:28Google看到一个link命令scripts/scald.rb --local XXX.scala前加了sudo,试试看之后简直不敢相信,神坑被fix了。。。
scalac -classpath /Users/wei.li/.sbt/boot/scala-2.9.3/lib/scala-library.jar:/Users/wei.li/codes/scalding/scalding-core/target/scala-2.9.3/scalding-core-assembly-0.9.0rc4.jar:/tmp/maven/hadoop-core-1.1.2.jar:/tmp/maven/commons-codec-1.8.jar:/tmp/maven/commons-configuration-1.9.jar:/tmp/maven/jackson-asl-0.9.5.jar:/tmp/maven/jackson-mapper-asl-1.9.13.jar:/tmp/maven/commons-lang-2.6.jar:/tmp/maven/slf4j-log4j12-1.6.6.jar:/tmp/maven/log4j-1.2.15.jar:/tmp/maven/commons-httpclient-3.1.jar:/tmp/maven/commons-cli-1.2.jar:/tmp/maven/commons-logging-1.1.1.jar:/tmp/maven/zookeeper-3.3.4.jar -d /tmp/script-build tutorial/Tutorial1.scala
这些jar包的路径跟以前截然不同!开心得要转圈圈~
不过最后我还是抛弃了scald.rb,在本地跑直接用sbt+Eclipse,在Hadoop上跑直接用sbt+shell script
Tuple里到底发生了什么
下面这个PPT很详细地解释了不同操作对Field的影响(此处应有翻墙)
Scalding大法好,退MR保平安
Scalding将HDFS的输入抽象成一个分布式集合(和数据库中Tuple和Field的概念是一致的),与MR不同,他可以很直观地进行两个表Join的操作。
可以运行的教程
https://github.com/twitter/scalding/tree/master/tutorial
https://github.com/sharethrough/scalding-emr-tutorial
一个更复杂的例子是
Generating Recommendations with MapReduce and Scalding
Movie recommendations and more via MapReduce and Scalding
你会发现Scalding代码真的长得很像Spark
Movie Recommendations and More With Spark
再来对比一下
这个PPT里提到了Scalding可以跑在Spark上,不过除了Summingbird(scalding for hadoop, storm for realtime)里提了下,鲜有这方面实践的资料
SBT让程序跑起来
REPL交互式Shell支持
今天发现其实有个很简单的方式,直接运行
~/codes/scalding/scripts/scald-repl.sh
就可以成功地导入并找到Scalding包啦
scalding> import com.twitter.scalding._
import com.twitter.scalding._
如果遇到一些找不到scala之类的问题,sudo一下试试看
可以在~/.bash_profile中加入
alias scalding="sudo ~/codes/scalding/scripts/scald-repl.sh"
好用得飞起来
如果你想加入第三方包(比如说json解析包)
可以vi scald.rb
参考MVNrepository的写法
libraryDependencies += "org.json4s" % "json4s-jackson_2.10" % "3.2.7"
在第33行"depends" => [ "org.apache.hadoop/hadoop-core/1.1.2", 后面照着它的格式加入你需要的包依赖

然后就可以在REPL里面导入这个包啦
scripts$ sudo scald-repl.sh

可以试着玩玩儿,但还是有坑,IDE里的SpreadSheet其实更方便
添加IDE支持
在项目的project/plugins.sbt中加入
addSbtPlugin("com.typesafe.sbteclipse" % "sbteclipse-plugin" % "2.4.0")
或者
addSbtPlugin("com.github.mpeltonen" % "sbt-idea" % "1.6.0")
在项目的build.sbt中添加Dependency,按照MVNrepository的写法加入依赖
libraryDependencies ++= Seq(
"com.twitter" % "scalding-core_2.10" % "0.9.0rc12" exclude("com.esotericsoftware.minlog", "minlog"),
"org.apache.hadoop" % "hadoop-core" % "1.2.1" % "provided",
"org.json4s" %% "json4s-jackson" % "3.2.8"
)
sbt update
sbt eclipse
或者
sbt gen-idea
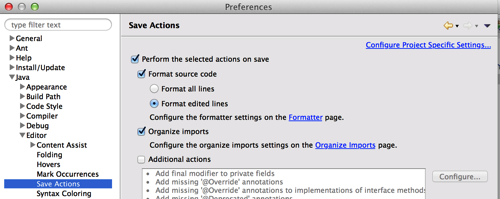
然后重新导入Eclipse就可以啦,我选择Eclipse主要是因为它有集成Scala 2.10支持的版本下载,比配IntelliJ省事儿些,而且可以设置Eclipse在每次保存的时候自动format代码,拯救了我的强迫症,知道在IntelliJ里怎么实现该功能的亲可以教教我哦~
Plugin for sbt to create Eclipse project definitions
Using IntelliJ with Twitter’s Scalding
Scalding初探之二:动手来做做小实验的更多相关文章
- 微信小程序开发入门教程(四)---自己动手做个小程序
前面已将基础知识准备的差不多了,下面实际做一个小程序. 一.目标 用于上传照片和文字. 2个主要页面:我me,设置set 二.开始制作 1.打开微信开发者工具(我用的1.02.1907160 Wind ...
- Codeforces Round #578 (Div. 2) 二维差分 可做模板
题意: 在n*n的矩阵中,你可以选择一个k*k的子矩阵,然后将这个子矩阵中的所有B全部变为W,问你怎么选择这个子矩阵使得最终的矩阵中某一行全是W或者某一列全是W的个数最多 题解:考虑每一行和每一列,对 ...
- VB 共享软件防破解设计技术初探(二)
VB 共享软件防破解设计技术初探(二) ×××××××××××××××××××××××××××××××××××××××××××××× 其他文章快速链接: VB 共享软件防破解设计技术初探(一)http ...
- C#进阶系列——DDD领域驱动设计初探(二):仓储Repository(上)
前言:上篇介绍了DDD设计Demo里面的聚合划分以及实体和聚合根的设计,这章继续来说说DDD里面最具争议的话题之一的仓储Repository,为什么Repository会有这么大的争议,博主认为主要原 ...
- DDD领域驱动设计初探(二):仓储Repository(上)
前言:上篇介绍了DDD设计Demo里面的聚合划分以及实体和聚合根的设计,这章继续来说说DDD里面最具争议的话题之一的仓储Repository,为什么Repository会有这么大的争议,博主认为主要原 ...
- 使用PixiJS做一个小游戏
PixiJS PixiJS使用WebGL,是一个超快的HTML5 2D渲染引擎.作为一个Javascript的2D渲染器,Pixi.js的目标是提供一个快速的.轻量级而且是兼任所有设备的2D库. 官方 ...
- 从零开始学做微信小程序,看这些就够了!
随着正式开放公测,微信小程序再次万众瞩目,越来越多的企业和个人涌入到小程序开发的大军中.小程序究竟是什么?适合做小程序的产品有哪些?做小程序需要提前准备什么?如何零基础学做小程序?此文,将列出OSC上 ...
- 用RecyclerView做一个小清新的Gallery效果
一.简介 RecyclerView现在已经是越来越强大,且不说已经被大家用到滚瓜烂熟的代替ListView的基础功能,现在RecyclerView还可以取代ViewPager实现Banner效果,当然 ...
- 用RecyclerView做一个小清新的Gallery效果 - Ryan Lee的博客
一.简介 RecyclerView现在已经是越来越强大,且不说已经被大家用到滚瓜烂熟的代替ListView的基础功能,现在RecyclerView还可以取代ViewPager实现Banner效果,当然 ...
随机推荐
- JS中的各种类型转换规则(转)
JS中的类型转换非常恶心,大家都懂的,不过该学还是要学. 今天看犀牛书看到了转换规则,总结出来. X转字符串.数字.布尔值 X表示各种类型的值,直接上图: 值 转数字 转字符串 转布尔值 undefi ...
- 深入浅出设计模式——简单工厂模式(Simple Factory)
介绍简单工厂模式不能说是一个设计模式,说它是一种编程习惯可能更恰当些.因为它至少不是Gof23种设计模式之一.但它在实际的编程中经常被用到,而且思想也非常简单,可以说是工厂方法模式的一个引导,所以我想 ...
- js函数、变量提升(hoisting)
其实我只是想复习下变量提升的,然后看到了函数提升,然后再看到了函数声明.函数表达式. 有必要怀着敬仰之心提及园子里的TOM大叔的解密命名函数表达式,不愧是大叔,好好地脑补了下基础知识. 在ECMASc ...
- Oracle_双机备份
1.dataguard http://jingyan.baidu.com/article/f96699bb956ef2894e3c1b39.html http://blog.itpub.net/262 ...
- Linux线程的实现 & LinuxThread vs. NPTL & 用户级内核级线程 & 线程与信号处理
另,线程的资源占用可见:http://www.cnblogs.com/charlesblc/p/6242111.html 进程 & 线程的很多知识可以看这里:http://www.cnblog ...
- SAP无输入历史记录(已在本地数据开启历史记录)解决方法
SAP客户端已开启本地数据的历史记录,但是仍然没有录入记录,重装SAP无法解决问题,没有最近输入记录操作极为不方便,经研究表现出的问题特征如下:1.同一用户在另一台电脑使用SAP就有历史记录,到了本电 ...
- laravel 控制器方法里存get值 和 blade 模板获得闪存值的方法
//get 方式把id传到路由 <a href="/admin/reply/add/{{$comment -> id}}" class="btn btn-bl ...
- SQL Server 用户名密码查看
因为SQL Server是默认使用Windows身份验证的,很多时间就会慢慢忘记掉原来设置的密码,那么怎么重新设置用户名密码呢 这里以SQL Server2013为例,先以windows身份验证登陆进 ...
- 两个TextView控件居中显示
通过一个线性布局将两个TextView控件包装在一起,设置LinearLayout的layout_centerInParent属性为true即可.代码如下 <LinearLayout andro ...
- 使用urllib编写python爬虫
新版python中,urllib和urllib2合并了,统一为urllib (1)简单爬取网页 import urllib content = urllib.request.urlopen(req). ...