
高性能MySQL笔记 第5章 创建高性能的索引
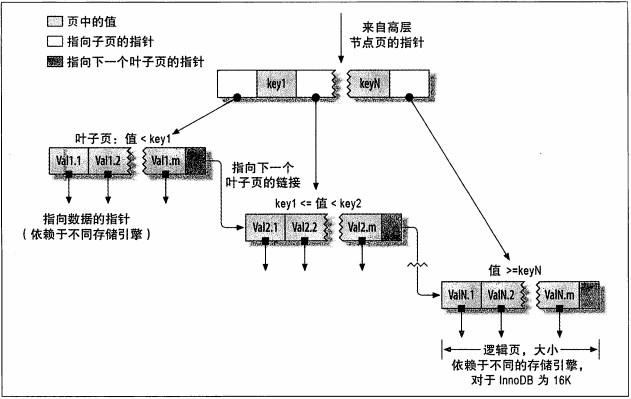
 索引(index),在MySQL中也被叫做键(key),是存储引擎用于快速找到记录的一种数据结构。索引优化是对查询性能优化最有效的手段。
- 全值匹配:是指和索引中的所有列进行匹配。
- 匹配最左前缀:即只使用索引的第一列。
- 匹配列前缀:即只使用索引第一列的开头部分。
- 匹配范围值:只使用了索引的第一列。
- 精确匹配某个列并范围匹配另外一列:即索引第一列全匹配,第二列范围匹配。
- 只访问索引的查询:又被称为“覆盖索引”,B-tree通常支持“只访问索引的查询”,即查询只需要访问索引,而无须访问数据行。如用户名与密码的匹配,手机号与验证码的匹配。
- 如果不是按照索引的最左列开始查找,则无法使用索引。
- 不能跳过索引中的列。
- 如果查询中有某个列的范围查询,则其右边所有列都无法使用索引。
- 索引大大减少了服务器需要扫描的数据量;
- 索引可以帮助服务器避免排序和临时表;
- 索引可以将随机I/O变为顺序I/O;
- 索引相关记录放在一起则获得一星;
- 索引中的数据顺序和查找中的排序顺序一致则获得二星;
- 索引中的列包含了查询中需要的全部列则获取三星;
- 当出现服务器对多个索引做相交操作时(通常有多个and条件),通常意味着需要一个包含所有香港列的多列索引,而不是多个独立的单列索引。
- 当服务器需要对多个索引做联合操作时(通常有多个or条件),通常需要消耗大量CPU和内存资源在算法的缓存、排序和合并操作上。特别是当其中有些索引的选择性不高,需要合并扫描返回的大量数据的时候。
- 更重要的是,优化器不会把这些计算到“查询成本”(cost)中,优化器只关心随机页面读取。这会使得查询的成本被“低估”,还可能会影响查询的并发性,但如果是单独运行这样的查询则往往会忽略对并发性的影响。
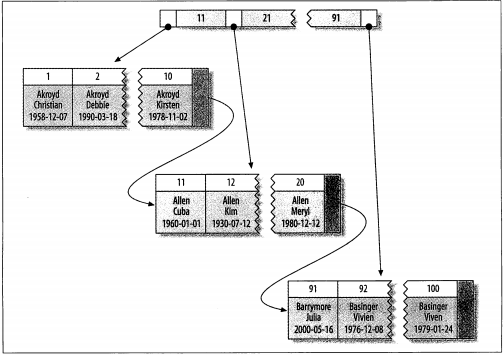

- 可以把相关数据保存在一起。
- 数据访问更快。聚簇索引将索引和数据保存在同一个B-Tree中,因此从聚簇索引中获取数据通常比在非聚簇索引中查找要快。
- 使用覆盖索引扫描的查询可以直接使用叶节点的主键值。
- 聚簇数据最大限度地提高了IO密集型应用的性能。但如果数据全部都放在内存中,则访问的顺序就没那么重要了,聚簇索引也就没了优势。
- 插入速度严重依赖插入顺序,按照主键的顺序是加载数据到InnoDB表中速度最快的方式。但如果不是按照主键顺序加载数据,那么在加载完成后最好使用optimize table命令重新组织一下表。
- 更新聚簇索引列的代价很高,因为会强制InnoDB将每个被更新的行移动到新的位置。
- 基于聚簇索引的表在插入新行,或者主键被更新导致需要移动行的时候,可能面临“页分裂”(page split)的问题。当行的主键值要求必须将这一行插入到某个已满的页中时,存储引擎会将该页分裂成两个页面来容纳该行,这就是一次页分裂操作。页分裂会导致表占用更多的磁盘空间。
- 聚簇索引可能导致全表扫描变慢,尤其是行比较稀疏,或者由于页分裂导致数据存储不连续的时候。
- 二级索引(非聚簇索引)可能比想象的要更大,因为在二级索引的叶子节点包含了引用行的主键列。
- 二次索引访问需要两次索引查找,而不是一次。这是因为二级索引中保存的“行指针”的实质。二级索引叶子节点保存的不是指向行的物理位置的指针,而是行的主键值。通过二级索引查找行,存储引擎需要找到二级索引的叶子节点获得对应的主键值,然后根据这个值取聚簇索引中查找到对应的行。
- 索引条目通常远小于数据行大小,所以如果只需要读取索引,那MySQL就会极大地减少数据访问量。这对缓存的负载非常重要,因为这种情况下响应时间大部分花费在数据拷贝上。覆盖索引对于IO密集型的应用也有帮助,因为索引比数据更小,更容易全部放入内存中。
- 因为索引是按照列值顺序存储的(至少在单个数据页内是如此)所以对于IO密集型的范围查询会比随机从磁盘读取每一行数据的IO要少得多。
- 由于InnoDB的聚簇索引,覆盖索引对InnoDB表特别有用。InnoDB的二级索引在叶子节点中保存了行的主键值,所以如果二级索引能够覆盖查询,则可以比main对主键索引的二次查询。
| 排序 | 是否使用了索引扫描来做排序 |
| ORDER BY a | yes |
| ORDER BY a, b | yes |
| ORDER BY a, b desc | no |
| WHERE a = 1 ORDER BY b | yes |
| WHERE a > 1 ORDER BY a, b | yes |
| WHERE a =1 ORDER BY b, c | no |
| WHERE a > 1 ORDER BY b | no |
- 单行访问是很慢的。特别是在机械硬盘存储中(SSD固态硬盘的随意IO要快很多,不过这一点仍然适用)。如果服务器从存储中读取一个数据块只是为了获取其中一行,那么就浪费了很多工作。最好读取的块中能包含尽可能多所需要的行。使用索引可以创建位置引用以提升效率。
- 按顺序访问范围数据是很快的,这有两个原因。第一,顺序IO不需要多次磁盘寻道,所以比随机IO要快很多。第二,如果服务器能够按需要顺序读取数据,那么就不再需要额外的排序操作,并且GROUP BY 查询也无须再做排序和将行按组进行聚合计算了。
- 索引覆盖查询是很快的。如果一个索引包含了查询需要的所有列,那么存储引擎就不需要再回表查找行。这避免了大量的单行访问。
高性能MySQL笔记 第5章 创建高性能的索引的更多相关文章
- 《高性能MySQL》——第五章创建高性能索引
1.创建索引基本语法格 在MySQL中,在已经存在的表上,可以通过ALTER TABLE语句直接为表上的一个或几个字段创建索引.基本语法格式如下: ALTER TABLE 表名 ADD [UNIQUE ...
- 高性能MySQL笔记 第6章 查询性能优化
6.1 为什么查询速度会慢 查询的生命周期大致可按照顺序来看:从客户端,到服务器,然后在服务器上进行解析,生成执行计划,执行,并返回结果给客户端.其中“执行”可以认为是整个生命周期中最重要的阶段. ...
- 高性能MySQL笔记 第4章 Schema与数据类型优化
4.1 选择优化的数据类型 通用原则 更小的通常更好 前提是要确保没有低估需要存储的值范围:因为它占用更少的磁盘.内存.CPU缓存,并且处理时需要的CPU周期也更少. 简单就好 简 ...
- 高性能MySQL笔记-第1章MySQL Architecture and History-001
1.MySQL架构图 2.事务的隔离性 事务的隔离性是specific rules for which changes are and aren’t visible inside and outsid ...
- 高性能MySQL笔记-第5章Indexing for High Performance-004怎样用索引才高效
一.怎样用索引才高效 1.隔离索引列 MySQL generally can’t use indexes on columns unless the columns are isolated in t ...
- 高性能MySQL笔记-第5章Indexing for High Performance-002Hash indexes
一. 1.什么是hash index A hash index is built on a hash table and is useful only for exact lookups that u ...
- 高性能MySQL笔记-第5章Indexing for High Performance-001B-Tree indexes(B+Tree)
一. 1.什么是B-Tree indexes? The general idea of a B-Tree is that all the values are stored in order, and ...
- 高性能MySQL笔记-第4章Optimizing Schema and Data Types
1.Good schema design is pretty universal, but of course MySQL has special implementation details to ...
- 高性能MySQL笔记-第5章Indexing for High Performance-005聚集索引
一.聚集索引介绍 1.什么是聚集索引? InnoDB’s clustered indexes actually store a B-Tree index and the rows together i ...
随机推荐
- poj-1703-Find them, Catch them
Find them, Catch them Time Limit: 1000MS Memory Limit: 10000K Total Submissions: 41928 Accepted: ...
- 习题:codevs 2822 爱在心中 解题报告
这次的解题报告是有关tarjan算法的一道思维量比较大的题目(真的是原创文章,希望管理员不要再把文章移出首页). 这道题蒟蒻以前做过,但是今天由于要复习tarjan算法,于是就看到codevs分类强联 ...
- ReportingServies——SQLServer报表开发综合实例
如果我们安装了sqlserver2008 R2,将会自动安装一个报表开发工具 不要以为此报表开发工具只适合于sqlserver2008,其实在sqlserver2012中也是支持的,事实上我现在项目中 ...
- mysql memory表性能测试以及使用场景
最近公司计划将风控逻辑移到slave库进行计算,因为考虑到业务表数据会比较大,此时如果还是走nest-loop的话,即使unique进行连接,因为还是需要至少2次以上LIO才能读一条记录,如果达到类似 ...
- c# 学习心得(函数方法类)
函数或者说方法都是写在类下的,我们可以通过函数名来调用它们.首先,我们要弄清楚为什么会有函数或者说方法这种东西?这里,我们使用了与前一篇同样的思维方式,先从它的目的或者实用价值出发.当我们在编写程序的 ...
- Redis学习笔记1-Redis数据类型
Redis数据类型 Redis支持5种数据类型,它们描述如下: Strings - 字符串 字符串是 Redis 最基本的数据类型.Redis 字符串是二进制安全的,也就是说,一个 Redis 字符串 ...
- 【CSS3】 理解CSS3 transform中的Matrix(矩阵)
理解CSS3 transform中的Matrix(矩阵) by zhangxinxu from http://www.zhangxinxu.com 本文地址:http://www.zhangxinxu ...
- Spring(2) ------ 依赖注入
spring框架为我们提供了三种注入方式,分别是set注入,构造方法注入,接口注入. 1.set注入: 采用属性的set方法进行初始化,就成为set注入. 1)给普通字符类型赋值. public cl ...
- javascript --- 事件冒泡与事件捕获
事件冒泡与事件捕获 事件冒泡和事件捕获分别由微软和网景公司提出,这两个概念都是为了解决页面中事件流(事件发生顺序)的问题.考虑下面这段代码,就不写html->head,body之类的代码了,自行 ...
- HTML <base> 标签 为页面上的所有链接规定默认地址或默认目标
定义和用法 <base> 标签为页面上的所有链接规定默认地址或默认目标. 通常情况下,浏览器会从当前文档的 URL 中提取相应的元素来填写相对 URL 中的空白. 使用 <base& ...