
CTPN-自然文本场景检测代码阅读笔记
TensorFlow代码 https://github.com/eragonruan/text-detection-ctpn
CTPN网络结构理解:
知乎链接:https://zhuanlan.zhihu.com/p/34757009
训练 main/train.py
1. utils/prepare/split_label.py
- 缩放图片resize image(长宽 最大1200,最小600)
- label处理 将大矩形框label划分一个个16*16的小矩形
2. 输入
- input_image 原图像 [[1, H, W, 3]]
- bbox(GT) [[x_min, y_min, x_max, y_max, 1], […], …]
- im_info(GT) 图像的高,宽,通道(二维ndarray) [[h,w,c]]
3. 模型 model_train.py -> model()
- 图像去均值: mean_image_subtraction(均值设为means=[123.68, 116.78, 103.94])
- 目的:图像标准化,移除共同部分,凸显个体差异。
- 输入到 VGG16, conv5 -> [N, H/16, W/16, 512]
- conv2d -> [N, H/16, W/16, 512]
- BLSTM -> [N, H/16, W/16, 512]
- FC -> bbox_pred + cls_pred + cls_prob-> [N, H/16, W/16, 410] + [N, H/16, W/16, 2x10] + [N, H/16, W/16, 210]
4. 损失 model_train.py -> loss()
- 生成anchor分类标签和bounding-box回归目标 anchor_target_layer()
- 输入: cls_pred, bbox(GT), im_info(GT)
- 返回: [rpn_labels, rpn_bbox_targets, rpn_bbox_inside_weights, rpn_bbox_outside_weights]
- 方法:
- 生成基本的anchor(10个),每个anchor对应的四个坐标 [x_min, y_min, x_max, y_max] -> heights = [11, 16, 23, 33, 48, 68, 97, 139, 198, 283] widths = [16]
- 生成所有的anchor(H/16xW/16x10): 生成feature-map和真实image上anchor之间的偏移量
- 仅保留那些还在图像内部的anchor,超出图像的都删掉
- rpn_labels 生成标签(>0.7或者最大的为正标签,<0.3的为负标签),限制标签的数量(总共256个) (先给正的上标签还是先给负的上标签?)
- rpn_bbox_targets 根据anchor和gtbox计算得真值(anchor和gtbox之间的偏差)
- 把超出图像范围的anchor再加回来
- 计算分类损失
rpn_cross_entropy_n = tf.nn.sparse_softmax_cross_entropy_with_logits(labels=rpn_label, logits=rpn_cls_score)
rpn_cross_entropy = tf.reduce_mean(rpn_cross_entropy_n)- 计算回归损失
rpn_loss_box_n = tf.reduce_sum(rpn_bbox_outside_weights * smooth_l1_dist(rpn_bbox_inside_weights * (rpn_bbox_pred - rpn_bbox_targets)), reduction_indices=[1])
rpn_loss_box = tf.reduce_sum(rpn_loss_box_n) / (tf.reduce_sum(tf.cast(fg_keep, tf.float32)) + 1)- smooth_L1_Loss层理解
- smooth_L1_Loss是Faster RCNN提出来的计算距离的loss
- 输入四个bottom,分别是predict,target,inside_weight,outside_weight。与论文并不完全一致,代码中实现的是更加general的版本,公式为:
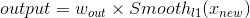

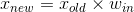
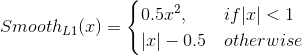
python实现:

def smooth_l1_loss(bbox_pred, bbox_targets, bbox_inside_weights, bbox_outside_weights, sigma=1.0, dim=[1]):

    '''

    bbox_pred   :预测框

    bbox_targets:标签框

    bbox_inside_weights:

    bbox_outside_weights:

    '''

    sigma_2 = sigma ** 2

    box_diff = bbox_pred - bbox_targets

    in_box_diff = bbox_inside_weights * box_diff

    abs_in_box_diff = tf.abs(in_box_diff)

    # tf.less 返回 True or False; a<b,返回True, 否则返回False。

    smoothL1_sign = tf.stop_gradient(tf.to_float(tf.less(abs_in_box_diff, 1. / sigma_2)))

    # 实现公式中的条件分支

    in_loss_box = tf.pow(in_box_diff, 2) * (sigma_2 / 2.) * smoothL1_sign + (abs_in_box_diff - (0.5 / sigma_2)) * (1. - smoothL1_sign)

    out_loss_box = bbox_outside_weights * in_loss_box

    loss_box = tf.reduce_mean(tf.reduce_sum(out_loss_box, axis=dim))

return loss_box- Smooth L1 Loss相比于L2 Loss对于离群点(outliers)更不敏感(Fast R-CNN中的解释:L1 loss that is less sensitive to outliers than the L2 loss used in R-CNN and SPPnet)。更详细的解释是当预测值与目标值相差很大时,L2 Loss的梯度为(x-t),容易产生梯度爆炸,L1 Loss的梯度为常数,通过使用Smooth L1 Loss,在预测值与目标值相差较大时,由L2 Loss转为L1 Loss可以防止梯度爆炸。
- 计算正则损失
- regularization_losses = tf.get_collection(tf.GraphKeys.REGULARIZATION_LOSSES)
- 模型损失
- model_loss = rpn_cross_entropy + rpn_loss_box
- 总损失
- total_loss = tf.add_n(regularization_losses) + model_loss
5. AdamOptimizer() 回归损失
预测 main/demo.py
1. 输入
- input_image [1, H, W, 3]
- input_im_info [[H, W, C]]
2. 缩放图片:600x1200
3. 使用训练好的模型得出 bbox_pred, cls_pred, cls_prob
4. proposal_layer() 生成propsal
- 输入:cls_prob, bbox_pred, im_info
- 返回:textsegs (1 x H x W x A, 5) e.g. [0, x1, y1, x2, y2]
方法:
生成基本的anchor
生成整张图像所有的anchor
根据anchor和bbox_pred,做逆变换,得到box在图像上的真实坐标
将所有的proposal修建一下,超出图像范围的将会被修剪掉
移除高度或宽度小于阈值的proposal
根据分数排序所有的proposal, 进行nms
输出所有proposal以及分数
5. TextDetector() 文本检测
文本线构造算法
- 输入: textsegs, score[:, np.newaxis], im_info[:2]
- 输出: 文本行坐标
- 方法:
- 删除得分较低的proposal, 阈值0.7
- 按得分排序
- 对proposal做nms
- 文本行的构建(两种方式:水平矩形框和有角度的矩形框)
- textdetector = TextDetector(DETECT_MODE=‘O’) # DETECT_MODE可以是’O’或者’H’
- 输出[xmin, ymin, xmax, ymin, xmax, ymax, xmin, ymax, score]
疑问以及代码问题:
2. rpn_bbox_outside_weights和rpn_bbox_inside_weights用来做什么的
CTPN中只需要回归proposal的y, h,而bbox_pred的输出为x, y, w, h,所以设置inside_weights=[0, 1, 0, 1]只计算y和h的损失; outside_weights来控制哪些样本参与计算回归损失
4. 代码中 config.py 中应该为 RPN_BBOX_INSIDE_WEIGHTS = (0.0, 1.0, 0.0, 1.0)
参考转载:https://blog.csdn.net/m0_38007695/article/details/88699219
CTPN-自然文本场景检测代码阅读笔记的更多相关文章
- Linux协议栈代码阅读笔记(二)网络接口的配置
Linux协议栈代码阅读笔记(二)网络接口的配置 (基于linux-2.6.11) (一)用户态通过C库函数ioctl进行网络接口的配置 例如,知名的ifconfig程序,就是通过C库函数sys_io ...
- [置顶] Linux协议栈代码阅读笔记(一)
Linux协议栈代码阅读笔记(一) (基于linux-2.6.21.7) (一)用户态通过诸如下面的C库函数访问协议栈服务 int socket(int domain, int type, int p ...
- [置顶] Linux协议栈代码阅读笔记(二)网络接口的配置
Linux协议栈代码阅读笔记(二)网络接口的配置 (基于linux-2.6.11) (一)用户态通过C库函数ioctl进行网络接口的配置 例如,知名的ifconfig程序,就是通过C库函数sys_io ...
- Linux-3.0.8 input subsystem代码阅读笔记
先乱序记录一下阅读Linux input subsystem代码的笔记. 在input device driver的入口代码部分,需要分配并初始化input device结构,内核提供的API是inp ...
- Typecho 代码阅读笔记(二) - 数据库访问
转载请注明出处:http://blog.csdn.net/jh_zzz 这一块比较复杂,我还没有完全理解为什么要把 SQL 语句的组装搞这么复杂. 从一个普通皮肤页面开始 themes/default ...
- 第一行代码阅读笔记---AndroidMainfest.xml分析
按照这本书的指引,我随作者一样创建了一个安卓应用,开始了安卓开发的启程. 找到AndroidMainfest.xml这个文件,打开后看到了我创建的Activity在这个文件里被成功注册,文件内容如下: ...
- <<梦断代码>>阅读笔记三
看完了这最后三分之一的<梦断代码>,意味着这本软件行业的著作已经被我粗略地过了一遍. 在这最后三分之一的内容中,我深入了解了在大型软件项目的运作过程中存在的困难和艰辛.一个大型软件项目的成 ...
- <<梦断代码>>阅读笔记一
没有想象中的枯燥,甚至有些有趣.这就是我对<梦断代码>这一本书的第一印象.而且,作为一本面向程序员的书籍,作者很有意义地从第0章开始,那我也从第0章开始说.这第一次读书笔记是针对0~2 章 ...
- <<梦断代码>>阅读笔记二
这是第二篇读书笔记,这本书我已经读了有一大半了,感觉书中所描述的人都是疯子,一群有创造力,却又耐得住寂寞的疯子. 我从书中发现几点我比较感兴趣的内容. 第一个,乐高之梦.将程序用乐高积木一样拼接起来. ...
随机推荐
- 手把手教你用Python实现自动特征工程
任何参与过机器学习比赛的人,都能深深体会特征工程在构建机器学习模型中的重要性,它决定了你在比赛排行榜中的位置. 特征工程具有强大的潜力,但是手动操作是个缓慢且艰巨的过程.Prateek Joshi,是 ...
- 洛谷P1310 表达式的值 题解 栈/后缀表达式的应用
题目链接:https://www.luogu.org/problem/P1310 本题涉及算法:栈.前缀表达式转后缀表达式,动态规划思想. 这道题目我思考了好长时间,第一时间让我做的话我也做不出来. ...
- tf.nn.embedding_lookup()的用法
函数: tf.nn.embedding_lookup( params, ids, partition_strategy='mod', name=None, validate_indices=True, ...
- java spring使用Jackson过滤
一.问题的提出. 项目使用Spring MVC框架,并用jackson库处理JSON和POJO的转换.在POJO转化成JSON时,希望动态的过滤掉对象的某些属性.所谓动态,是指的运行时,不同的cont ...
- CF1166E The LCMs Must be Large
CF1166E The LCMs Must be Large 构造趣题 正着推其实很不好推 不妨大力猜结论 如果两两集合都有交,那么一定可以 证明: 1.显然如果两个集合没有交,一定不可以 2.否则给 ...
- 浅谈集合框架二 List、Set常用方法
最近刚学完集合框架,想把自己的一些学习笔记与想法整理一下,所以本篇博客或许会有一些内容写的不严谨或者不正确,还请大神指出.初学者对于本篇博客只建议作为参考,欢迎留言共同学习. 之前有介绍集合框架的体系 ...
- 整理了一下react16.7.0的webpack模板
基本上react需要方法和依赖的库都引配好了.github地址:https://github.com/qianxiaoning/demo-react16.7.0 欢迎大家star或者fork呀~ te ...
- Linux 旗标实现
Linux 内核提供了一个遵守上面语义的旗标实现, 尽管术语有些不同. 为使用旗标, 内核 代码必须包含 <asm/semaphore.h>. 相关的类型是 struct semaphor ...
- 台州学院第十二届校赛记录(B,C,E,H,I,J,L)
传送门:点我 题目很棒,感谢出题验题的大佬们. 细节坑不少,是好事. 还是很菜,继续加油! B: 桃子的生日 时间限制(普通/Java):1000MS/3000MS 内存限制:65536KBy ...
- vue-learning:11 -js-nextTick()
nextTick() 在jQuery中,如果我们要生成一个ul-li的列表元素,我们也不会在循环体中每生成一个li就将它插入到ul中,而是在循环体内拼接每个li,待循环体结束后,再一并添加到ul元素上 ...