
《机器学习实战》之k-近邻算法(示例)
看了这本书的第一个算法—k-近邻算法,这个算法总体构造思想是比较简单的,在ACM当中的话就对应了kd树这种结构。首先需要给定训练集,然后给出测试数据,求出训练集中与测试数据最相近的k个数据,根据这k个数据的属性来确定我们测试数据的属性。
书上的例子是给了四个点以及这四个点的标签,分别是A,A,B,B,现在给定一测试点,需要根据这四个训练集来判断该测试点的标签应该是A还是B。
 from numpy import *

 import operator

 def createDataSet():

     group = array([[1.0,1.1], [1.0,1.0], [0,0], [0,0.1]])

     labels = ['A', 'A', 'B', 'B']

     return group, labels

 def classify0(inX, dataSet, labels, k):

     dataSetSize = dataSet.shape[0]

     diffMat = tile(inX, (dataSetSize,1)) - dataSet  #统一矩阵,实现加减

     sqDiffMat = diffMat**2

     sqDistances = sqDiffMat.sum(axis=1)  #进行累加,axis=0是按列,axis=1是按行

     distances = sqDistances**0.5  #开根号

     sortedDistIndicies = distances.argsort()  #按升序进行排序,返回原下标

     classCount = {}

     for i in range(k):

         voteIlabel = labels[sortedDistIndicies[i]]

         classCount[voteIlabel] = classCount.get(voteIlabel, 0) + 1  #get是字典中的方法,前面是要获得的值,后面是若该值不存在时的默认值

     sortedClassCount = sorted(classCount.items(), key=operator.itemgetter(1), reverse=True)
    #在python3中没有iteritems,key在这里是按照字典的第二个元素来排序,降序排序

     return sortedClassCount[0][0]  #获得字典中第一对映射中的第一个值

 if __name__ == "__main__":

     dataSet, labels = createDataSet()

     inX = [0.2, 0.2]

     print(classify0(inX, dataSet, labels, 2))
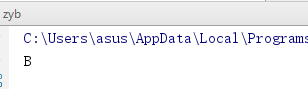
代码详解:
①array
这是numpy库中,它就是用来构造矩阵的:
 from numpy import array

 a = array([[1,1],

            [2,3]])

 b = array([[0,1],

            [3,2]])

 c = a-b

 print(c)
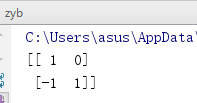
②tile()函数
tile(A,repes)返回shape = repes的矩阵,每个元素是A
 from numpy import tile

 a = [1,2,3]

 b = tile(a,(2,3))

 print(b)
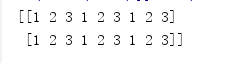
③argsort()
按序排列,返回原始下标
 from numpy import argsort

 a = [4,3,1,2]

 b = argsort(a)

 print(b)
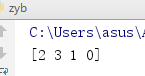
《机器学习实战》之k-近邻算法(示例)的更多相关文章
- 02机器学习实战之K近邻算法
第2章 k-近邻算法 KNN 概述 k-近邻(kNN, k-NearestNeighbor)算法是一种基本分类与回归方法,我们这里只讨论分类问题中的 k-近邻算法. 一句话总结:近朱者赤近墨者黑! k ...
- 机器学习实战笔记--k近邻算法
#encoding:utf-8 from numpy import * import operator import matplotlib import matplotlib.pyplot as pl ...
- 《机器学习实战》-k近邻算法
目录 K-近邻算法 k-近邻算法概述 解析和导入数据 使用 Python 导入数据 实施 kNN 分类算法 测试分类器 使用 k-近邻算法改进约会网站的配对效果 收集数据 准备数据:使用 Python ...
- 《机器学习实战》——K近邻算法
三要素:距离度量.k值选择.分类决策 原理: (1) 输入点A,输入已知分类的数据集data (2) 求A与数据集中每个点的距离,归一化,并排序,选择距离最近的前K个点 (3) K个点进行投票,票数最 ...
- 机器学习实战python3 K近邻(KNN)算法实现
台大机器技法跟基石都看完了,但是没有编程一直,现在打算结合周志华的<机器学习>,撸一遍机器学习实战, 原书是python2 的,但是本人感觉python3更好用一些,所以打算用python ...
- 机器学习03:K近邻算法
本文来自同步博客. P.S. 不知道怎么显示数学公式以及排版文章.所以如果觉得文章下面格式乱的话请自行跳转到上述链接.后续我将不再对数学公式进行截图,毕竟行内公式截图的话排版会很乱.看原博客地址会有更 ...
- 机器学习随笔01 - k近邻算法
算法名称: k近邻算法 (kNN: k-Nearest Neighbor) 问题提出: 根据已有对象的归类数据,给新对象(事物)归类. 核心思想: 将对象分解为特征,因为对象的特征决定了事对象的分类. ...
- 机器学习 Python实践-K近邻算法
机器学习K近邻算法的实现主要是参考<机器学习实战>这本书. 一.K近邻(KNN)算法 K最近邻(k-Nearest Neighbour,KNN)分类算法,理解的思路是:如果一个样本在特征空 ...
- 机器学习:1.K近邻算法
1.简单案例:预测男女,根据身高,体重,鞋码 import numpy as np import matplotlib import sklearn from skleran.neighbors im ...
- 机器学习实战笔记-2-kNN近邻算法
# k-近邻算法(kNN) 本质是(提取样本集中特征最相似数据(最近邻)的k个分类标签). K-近邻算法的优缺点 例 优点:精度高,对异常值不敏感,无数据输入假定: 缺点:计算复杂度高,空间复杂度高: ...
随机推荐
- python内置函数zip
zip() 函数用于将可迭代的对象作为参数,将对象中对应的元素打包成一个个元组,然后返回由这些元组组成的列表. 如果各个迭代器的元素个数不一致,则返回列表长度与最短的对象相同,利用 * 号操作符,可以 ...
- mybatis源码解析6---MappedStatement解析
MappedStatement类位于mybatis包的org.apache.ibatis.mapping目录下,是一个final类型也就是说实例化之后就不允许改变 MappedStatement对象对 ...
- echart中间显示固定的字
- POSIX rename语义
POSIX对rename行为的定义如下(http://www.opengroup.org/onlinepubs/009695399/functions/rename.html): 将一个文件重命名为一 ...
- (2018干货系列四)最新Python学习路线整合
怎么学Python Python是一种面向对象的解释型计算机程序设计语言,纯粹的自由软件,常被昵称为胶水语言,能够把用其他语言制作的各种模块(尤其是C/C++)很轻松地联结在一起. Python初级开 ...
- flask框架----数据库连接池
数据库连接池 flask中是没有ORM的,如果在flask里面连接数据库有两种方式 一:pymysql 二:SQLAlchemy 是python 操作数据库的一个库.能够进行 orm 映射官方文档 s ...
- to refactor for refactor
v1.1 if all algorithm are in one function, it will expand. so each operate type should be separated. ...
- vs变量监视提示-VAR-CREATE: UNABLE TO CREATE VARIABLE OBJECT解决方法
昨天有个linux应用在使用vs 远程debug的时候,debug可以正常进行,但是监视变量的时候提示-VAR-CREATE: UNABLE TO CREATE VARIABLE OBJECT,经测试 ...
- 深入理解 Vue 组件
深入理解 Vue 组件 组件使用中的细节点 使用 is 属性,解决组件使用中的bug问题 <!DOCTYPE html> <html lang="en"> ...
- Android - Resource 之 String 小结
简单的string: <?xml version="1.0" encoding="utf-8"?> <resources> <st ...