
Hadoop 历史服务配置启动查看
历史服务配置启动查看
1)配置mapred-site.xml
|
<property> <name>mapreduce.jobhistory.address</name> <value>hadoop-001:10020</value> </property> <property> <name>mapreduce.jobhistory.webapp.address</name> <value>hadoop-001:19888</value> </property> |
2)查看启动历史服务器文件目录:
[hadoop@hadoop-001 hadoop-2.7.2]# ls sbin/ |grep mr
mr-jobhistory-daemon.sh
3)启动历史服务器
sbin/mr-jobhistory-daemon.sh start historyserver
4)查看历史服务器是否启动
jps
5)查看jobhistory
http://hadoop-001:19888/jobhistory
日志的聚集
日志聚集概念:应用运行完成以后,将日志信息上传到HDFS系统上
开启日志聚集功能步骤:
(1)配置yarn-site.xml
|
<!-- 日志聚集功能使能 --> <property> <name>yarn.log-aggregation-enable</name> <value>true</value> </property> <!-- 日志保留时间设置7天 --> <property> <name>yarn.log-aggregation.retain-seconds</name> <value>604800</value> </property> |
(2)关闭nodemanager 、resourcemanager和historymanager
sbin/yarn-daemon.sh stop resourcemanager
sbin/yarn-daemon.sh stop nodemanager
sbin/mr-jobhistory-daemon.sh stop historyserver
(3)启动nodemanager 、resourcemanager和historymanager
sbin/yarn-daemon.sh start resourcemanager
sbin/yarn-daemon.sh start nodemanager
sbin/mr-jobhistory-daemon.sh start historyserver
(4)删除hdfs上已经存在的hdfs文件
bin/hdfs dfs -rm -R /gec/mapreduce/wordcount/output
(5)执行wordcount程序
hadoop jar share/hadoop/mapreduce/hadoop-mapreduce-examples-2.7.2.jar wordcount /gec/mapreduce/wordcount/input /gec/mapreduce/wordcount/output
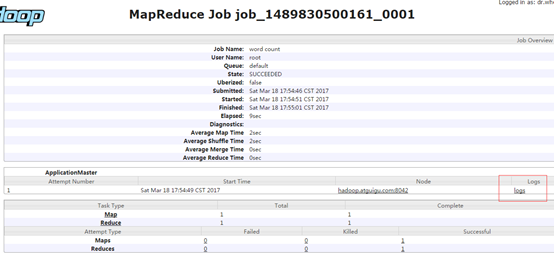
(6)查看日志
http://hadoop-001:19888/jobhistory


Hadoop 历史服务配置启动查看的更多相关文章
- Mapreduce 历史服务 配置启动查看
如果没有进行配置的话,那个History是不可以进行点击的,点击进去就会报错!所以需要进行配置一下 使用命令启动HistoryServer 就可以查看任务执行的进度了 命令: sbin/mr-jobh ...
- hadoop历史服务的启动与停止
a.配置项(在分布式环境中配置) 1.RPC访问地址 mapreduce.jobhistory.address 2.HTTP访问地址 mapreduce.jobhistory.webapp.addre ...
- 配置spark历史服务(spark二)
1. 编辑spark-defaults.conf位置文件 添加spark.eventLog.enabled和spark.eventLog.dir的配置修改spark.eventLog.dir为我们之前 ...
- 【转载】Hadoop历史服务器详解
免责声明: 本文转自网络文章,转载此文章仅为个人收藏,分享知识,如有侵权,请联系博主进行删除. 原文作者:过往记忆(http://www.iteblog.com/) 原文地址: ...
- 初识Hadoop一,配置及启动服务
一.Hadoop简介: Hadoop是由Apache基金会所开发的分布式系统基础架构,实现了一个分布式文件系统(Hadoop Distributed File System),简称HDFS:Hadoo ...
- hadoop配置历史服务器&&配置日志聚集
配置历史服务器 1.在mapred-site.xml中写入一下配置 <property> <name>mapreduce.jobhistory.address</name ...
- linux服务创建及jq配置服务列表查看
1.应用背景 随着业务需求,后台处理服务不断增多,对于这些服务或后台程序的查看.更新操作越来越凌乱,所以我们首先需要一个服务列表查看工具,方便查看各 服务的端口.运行状态.jar包路径等等. 2.创建 ...
- 马士兵hadoop第四课:Yarn和Map/Reduce配置启动和原理讲解
马士兵hadoop第一课:虚拟机搭建和安装hadoop及启动 马士兵hadoop第二课:hdfs集群集中管理和hadoop文件操作 马士兵hadoop第三课:java开发hdfs 马士兵hadoop第 ...
- 马士兵hadoop第四课:Yarn和Map/Reduce配置启动和原理讲解(转)
马士兵hadoop第一课:虚拟机搭建和安装hadoop及启动 马士兵hadoop第二课:hdfs集群集中管理和hadoop文件操作 马士兵hadoop第三课:java开发hdfs 马士兵hadoop第 ...
随机推荐
- phpstom pojie
https://blog.csdn.net/gu_wen_jie/article/details/79136475
- python之pandas用法大全
python之pandas用法大全 更新时间:2018年03月13日 15:02:28 投稿:wdc 我要评论 本文讲解了python的pandas基本用法,大家可以参考下 一.生成数据表1.首先导入 ...
- Python用户交互
print("开始") # 赋值,把等号右边的内容赋值给左边 s = input() #input("这里是input")# input输入,让用户输入一些内容 ...
- 简短而有效的python queue队列解释
Queue.qsize() 返回队列的大小 Queue.empty() 如果队列为空,返回True,反之False Queue.full() 如果队列满了,返回True,反之False Queue ...
- 2016ICPC-大连 To begin or not to begin (简单思维)
A box contains black balls and a single red ball. Alice and Bob draw balls from this box without rep ...
- prototype和_proto_
__proto__(隐式原型)与prototype(显式原型) 显式原型 explicit prototype property:用来实现基于原型的继承与属性的共享. 每一个函数在创建之后都会拥有一个 ...
- 微信小程序中时间转化为时间戳(安卓和苹果兼容性)
在IOS中时间显示NAN,后来才知道是由于安卓和IOS时间解析时间的时间格式不一致: 在安卓机中2018-06-21 16:00:21 IOS识别的格式是 2018/06/21: 所以在处理IOS机器 ...
- Samsung_tiny4412(驱动笔记05)----Makefile,open,read,write,lseek,poll,ioctl,fasync
/*********************************************************************************** * * Makefile,op ...
- [opencvjichu]cv::Mat::type() 返回值
opencv opencv中Mat存在各种类型,其中mat有一个type()的函数可以返回该Mat的类型.类型表示了矩阵中元素的类型以及矩阵的通道个数,它是一系列的预定义的常量,其命名规则为CV_(位 ...
- 【转】【计算机视觉】opencv靶标相机姿态解算2 根据四个特征点估计相机姿态 及 实时位姿估计与三维重建相机姿态
https://blog.csdn.net/kyjl888/article/details/71305149