
【Hadoop学习之三】Hadoop全分布式安装
环境
虚拟机:VMware 10
Linux版本:CentOS-6.5-x86_64
客户端:Xshell4
FTP:Xftp4
jdk8
hadoop3.1.1
全分布式就是集群,注意配置主机名。
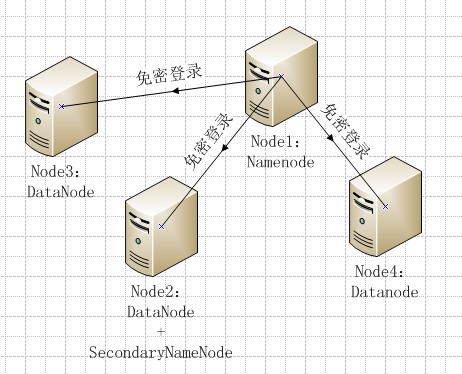
一、平台和软件
1、安装JDK和免密登录参考:【Hadoop学习之二】Hadoop伪分布式安装
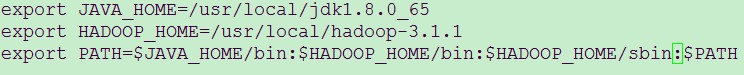
2、设置环境变量
[root@node1 /]# vi /etc/profile
[root@node1 /]# source /etc/profile
#注意pwd 是打印当前路径  意思是要拷贝到远程主机统一目录下

[root@node1 etc]# scp /etc/profile node2:`pwd`

profile                                                                                %      .9KB/s   :

[root@node1 etc]# scp /etc/profile node3:`pwd`

profile                                                                                %      .9KB/s   :

[root@node1 etc]# scp /etc/profile node4:`pwd`

profile                                                                                %      .9KB/s   :
3、node1-node4设置主机名 后重启
[root@node1 /]# vi /etc/hosts
127.0.0.1 localhost localhost.localdomain localhost4 localhost4.localdomain4

:: localhost localhost.localdomain localhost6 localhost6.localdomain6

192.168.230.11 node1

192.168.230.12 node2

192.168.230.13 node3

192.168.230.14 node4
分发到另外三个节点
[root@node1 etc]# scp /etc/hosts node2:`pwd`

hosts                                                                                  %       .2KB/s   :

[root@node1 etc]# scp /etc/hosts node3:`pwd`

hosts                                                                                  %       .2KB/s   :

[root@node1 etc]# scp /etc/hosts node4:`pwd`

hosts                                                                                  %       .2KB/s   :
第一次配置hosts 需要重启生效
[root@node1 /]# reboot
二、配置
1、修改/usr/local/hadoop-3.1.1/etc/hadoop/hadoop-env.sh 设置JAVA环境变量、角色用户
在最后添加如下设置:
export JAVA_HOME=/usr/local/jdk1..0_65

export HDFS_NAMENODE_USER=root

export HDFS_DATANODE_USER=root

export HDFS_SECONDARYNAMENODE_USER=root
2、修改/usr/local/hadoop-3.1.1/etc/hadoop/core-site.xml 配置主节点相关信息
(1)fs.defaultFS 主节点通讯信息 (hadoop3默认端口改为9820)
(2)hadoop.tmp.dir 设置namenode元数据和datanode block数据的目录
<configuration>

    <property>

        <name>fs.defaultFS</name>

        <value>hdfs://node1:9820</value>

    </property>

    <property>

        <name>hadoop.tmp.dir</name>

        <value>/data/hadoopfull</value>

    </property>

</configuration>
3、修改/usr/local/hadoop-3.1.1/etc/hadoop/hdfs-site.xml 配置从节点相关信息
(1)dfs.replication 副本数
(2)dfs.namenode.secondary.http-address 二级namenode (hadoop默认端口改为9868)
<property>

    <name>dfs.replication</name>

    <value></value>

</property>

<property>

    <name>dfs.namenode.secondary.http-address</name>

    <value>node2:9868</value>

</property>
4、修改workers(hadoop2.X叫slave)配置从节点(DATANODE)信息
配置:
node2

node3

node4
5、分发hadoop到node2、node3、node4 依赖免密登录 注意拷贝时的目录 (注意:jdk也可以采用这种方式分发)
[root@node2 local]# scp -r /usr/local/hadoop-3.1. node2:`pwd`
[root@node2 local]# scp -r /usr/local/hadoop-3.1. node3:`pwd`
[root@node2 local]# scp -r /usr/local/hadoop-3.1. node4:`pwd`
三、启动
首次启动,需要主节点进行格式化
[root@node1 /]# hdfs namenode -format
启动:node1作为namenode主节点,要在主节点上启动
[root@node1 /]# start-dfs.sh
关闭:
[root@node1 /]# stop-dfs.sh
可以使用jps命令,在node2、node3、node4上查看启动情况
【Hadoop学习之三】Hadoop全分布式安装的更多相关文章
- Centos 6.5 hadoop 2.2.0 全分布式安装
hadoop 2.2.0 cluster setup 环境: 操作系统:Centos 6.5 jdk:jdk1.7.0_51 hadoop版本:2.2.0 hostname ip master ...
- Hadoop生态圈-hbase介绍-伪分布式安装
Hadoop生态圈-hbase介绍-伪分布式安装 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.HBase简介 HBase是一个分布式的,持久的,强一致性的存储系统,具有近似最 ...
- hadoop 2.7.3伪分布式安装
hadoop 2.7.3伪分布式安装 hadoop集群的伪分布式部署由于只需要一台服务器,在测试,开发过程中还是很方便实用的,有必要将搭建伪分布式的过程记录下来,好记性不如烂笔头. hadoop 2. ...
- centos 7下Hadoop 2.7.2 伪分布式安装
centos 7 下Hadoop 2.7.2 伪分布式安装,安装jdk,免密匙登录,配置mapreduce,配置YARN.详细步骤如下: 1.0 安装JDK 1.1 查看是否安装了openjdk [l ...
- hadoop学习之hadoop完全分布式集群安装
注:本文的主要目的是为了记录自己的学习过程,也方便与大家做交流.转载请注明来自: http://blog.csdn.net/ab198604/article/details/8250461 要想深入的 ...
- [大数据] hadoop全分布式安装
一.准备工作 在伪分布式的搭建基础上修改配置,搭建全分布式hadoop环境,伪分布式安装参照 hadoop伪分布式安装. 首先准备4台虚拟机,信息如下: 192.168.1.11 namenode1 ...
- hadoop学习笔记——基础知识及安装
1.核心 HDFS 分布式文件系统 主从结构,一个namenoe和多个datanode, 分别对应独立的物理机器 1) NameNode是主服务器,管理文件系统的命名空间和客户端对文件的访问操 ...
- Hadoop + Hive + HBase + Kylin伪分布式安装
问题导读 1. Centos7如何安装配置? 2. linux网络配置如何进行? 3. linux环境下java 如何安装? 4. linux环境下SSH免密码登录如何配置? 5. linux环境下H ...
- Hadoop开发第4期---分布式安装
一.复制虚拟机 由于Hadoop的集群安装需要多台机器,由于条件有限,我是用虚拟机通过克隆来模拟多台机器,克隆方式如下图所示
随机推荐
- 洛谷P2633 Count on a tree 主席树
传送门:主席树 解题报告: 传送门! umm这题我还麻油开始做 所以 先瞎扯一波我的想法,如果错了我就当反面教材解释这种典型错误,对了我就不管了QwQ 就直接dfs,在dfs的过程中建树 然后就直接查 ...
- 只读事务@Transactional(readOnly = true)
定义 从设置的时间点(时间点beta)开始到事务结束的过程中,该事务将看不见其他事务所提交的数据,即查询中不会出现别人在beta之后提交的数据. 应用场合 对于一个函数,如果执行的只是 ...
- linux 内核启动流程分析,移植
分析 linux-2.6.22.6 内核启动流程 移植 linux-3.4.2 到 JZ2440 开发板 Linux内核源码百度云链接: https://pan.baidu.com/s/1m1ymGl ...
- js阻止默认事件,如a标签跳转和事件冒泡
禁止a标签点击跳转 <a href="http://baidu.com" onclick="return false">点我啊</a> ...
- 43.1-CAN通讯
43-CAN通讯 1.CAN 协议简介 CAN是控制器局域网络(Controller Area Network)的简称,它是由研发和生产汽车电子 产品著称的德国 BOSCH 公司开发的,并最终成为国际 ...
- Maven中groupId和artifactId的含义
groupId和artifactId被统称为“坐标”是为了保证项目唯一性而提出的,如果你要把你项目弄到maven仓库去,你想要找到你的项目就必须根据这两个id去查找.groupId是项目组织唯一的标识 ...
- SQL SERVER 2016研究四
SQL Server 2016 白皮书 内容:内存优化表 问题? -----内存优化表在2014版本推出,主要是如何作用?如何使用?目前有何变化? 内存优化表是可以将表放入内存中,能提升操作性能. - ...
- sap 申请 新系统用户
1:打开sap logon, 进入到以下界面,connection上面 ,右键>add new entry 2: 搜索自己需要的系统名称. 3:一直next,直到完成 4: 双击该系统,进入以 ...
- 关于SimpleDateFormat时间转换总是显示1970年的问题
今天遇到了一个奇怪的问题, long time = 1488606363; Date date = new Date(time); java.text.SimpleDateFormat sDateFo ...
- 常用 shell 命令
watch watch -n 1 -d "ps -ef | grep php" 功能:监控 PHP 进程的变化 原理: 重复的执行后面的命令,默认时间间隔是2秒 参数解释 -d 高 ...