
5.Python使用最新爬虫工具requests-html
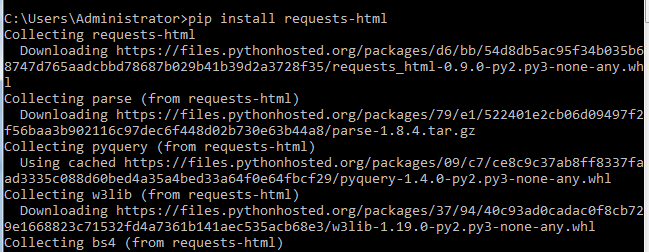
1.安装,在命令行输入:pip install requests-html,安装成功后,在Pycharm引入即可。
2.代码如下所示:
from requests_html import HTMLSession

import requests

session = HTMLSession()

r = session.get('http://www.win4000.com/wallpaper_2358_0_10_1.html')

images = r.html.find('ul.clearfix > li > a')        #获取到网页上所有a标签url

def save_Image(url,title):                          #定义一个函数,用于保存图片到指定目录下(E盘下需手动新建bg文件夹)

    html_response = requests.get(url)

    with open('E:/bg/'+title+'.jpg','wb') as file:

        file.write(html_response.content)

#查找页面中背景图,找到链接,访问查看大图,并获取大图地址

for image in  images:

    image_url = image.attrs['href']  #获取到每张图片属性值为href的url

    if '/wallpaper_detail' in image_url:

        r = session.get(image_url)

        item_url = r.html.find('img.pic-large',first=True)    #获取到href下的src的url

        url = item_url.attrs['src']

        title = item_url.attrs['title']

        print(url+title)

        save_Image(url,title)
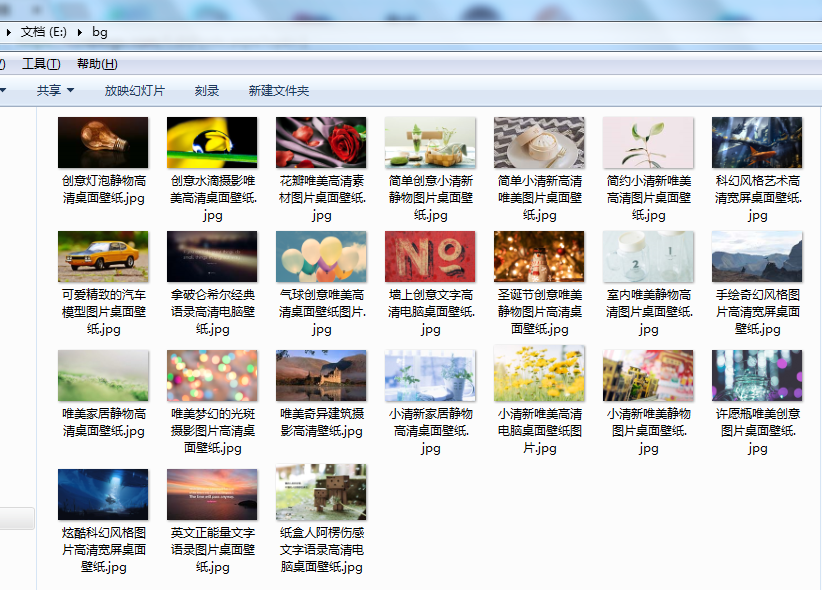
3.在指定目录即可查看到爬下来的图片
5.Python使用最新爬虫工具requests-html的更多相关文章
- python动态网站爬虫实战(requests+xpath+demjson+redis)
目录 前言 一.主要思路 1.观察网站 2.编写爬虫代码 二.爬虫实战 1.登陆获取cookie 2.请求资源列表页面,定位获得左侧目录每一章的跳转url(难点) 3.请求每个跳转url,定位右侧下载 ...
- python写的爬虫工具,抓取行政村的信息并写入到hbase里
python的版本是2.7.10,使用了两个第三方模块bs4和happybase,可以通过pip直接安装. 1.logger利用python自带的logging模块配置了一个简单的日志输出 2.get ...
- python爬虫工具集合
python爬虫工具集合 大家一起来整理吧!强烈建议PR.这是初稿,总是有很多问题,而且考虑不全面,希望大家支持! 源文件 主要针对python3 常用库 urllib Urllib是python提供 ...
- 常见Python爬虫工具总结
常见Python爬虫工具总结 前言 以前写爬虫都是用requests包,虽然很好用,不过还是要封装一些header啊什么的,也没有用过无头浏览器,今天偶然接触了一下. 原因是在处理一个错误的时候,用到 ...
- python 3.x 爬虫基础---常用第三方库(requests,BeautifulSoup4,selenium,lxml )
python 3.x 爬虫基础 python 3.x 爬虫基础---http headers详解 python 3.x 爬虫基础---Urllib详解 python 3.x 爬虫基础---常用第三方库 ...
- python爬虫工具
一直都听说python写爬虫工具非常方便,为了获取数据,我也要写点爬虫,但是python太灵活了,不知道python爬虫要哪些框架,要了解,比如beatiful soup,scrapy, 爬虫的额主要 ...
- Python爬虫之requests
爬虫之requests 库的基本用法 基本请求: requests库提供了http所有的基本请求方式.例如 r = requests.post("http://httpbin.org/pos ...
- 孤荷凌寒自学python第六十七天初步了解Python爬虫初识requests模块
孤荷凌寒自学python第六十七天初步了解Python爬虫初识requests模块 (完整学习过程屏幕记录视频地址在文末) 从今天起开始正式学习Python的爬虫. 今天已经初步了解了两个主要的模块: ...
- Python爬虫练习(requests模块)
Python爬虫练习(requests模块) 关注公众号"轻松学编程"了解更多. 一.使用正则表达式解析页面和提取数据 1.爬取动态数据(js格式) 爬取http://fund.e ...
随机推荐
- Mysql之select
SELECT {*|<字段列表>} [ FROM <表1>,<表2>,…,<表n> WHERE <表达式> GROUP BY ...
- 内网 LAN IPv6 环境配置 H3C S5500 Huawei S5700
# 使能IPv6报文转发功能. <Sysname> system-view [Sysname] ipv6 # 使能DHCPv6服务器功能. <Sysname> system-v ...
- 【Python】高阶函数介绍
其实函数可以作为变量,之前学过C++,对于这种用法并不奇怪.无非就是函数充当变量,可以传入函数而已. 下面分别介绍 Python 中常见的高阶函数:map/reduce, filter, sorted ...
- tkinter模块常用参数
tkinter模块常用参数 1.使用tkinter.Tk() 生成主窗口(root=tkinter.Tk()):root.title('标题名') 修改框体的名字,也可在创建时使用class ...
- vue打包体积优化之旅
webpack 与 vue 在使用vue开发时,遇到打包后单个文件太大,因而需要分包,不然加载时间太久.虽然尽可能减少请求次数,但是单个包太大也不是好事 思路 组件按需加载 vue-router 的懒 ...
- Quartz教程四:Trigger
原文链接 | 译文链接 | 翻译:nkcoder 本系列教程由quartz-2.2.x官方文档翻译.整理而来,希望给同样对quartz感兴趣的朋友一些参考和帮助,有任何不当或错误之处,欢迎指正:有兴趣 ...
- Docker的大坑小洼(一)
Docker的大坑小洼 Posted on March 2, 2015March 2, 2015 by 孙宏亮 Docker成为云计算领域的新宠儿已经是不争的事实,作为高速发展的开源项目,难免存在这样 ...
- nodejs编译sass模块包 node-compass,与gulp包gulp-sass使用方法
简介:node express或者就是node项目中,要自动编译sass方法很多,比如gulp 比如考拉,比如今天我想说的这个包node-compass. 编译sass的三种方法: 前提条件: 都需要 ...
- 利用国内镜像下载Android源码,并编译生成image镜像文件
为了编译安卓源码,首先需要一个Linux,本次采用Ubuntu Kylin14.04,内核版本3.13.装在四核.4G内存.1T硬盘的虚拟机上查看内核版本号:$uname -all清华镜像地址清华镜像 ...
- 20165202 2017-2018-2 《Java程序设计》第6周学习总结
教材学习内容总结 Ch8 String类: 程序可以直接使用,String类不能有子类 - 构造String对象 使用String类声明并创建对象 String s = new String(&quo ...