
Spark的job调优(1)
本文翻译之cloudera的博客,本系列有两篇,第二篇看心情了
概论
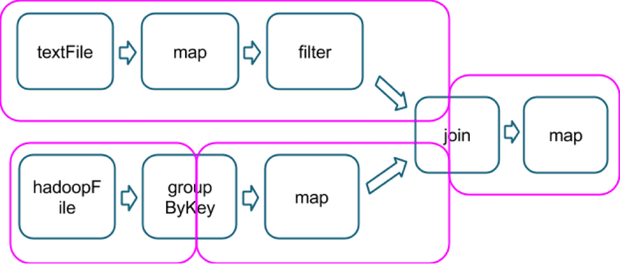
Spark如何执行应用
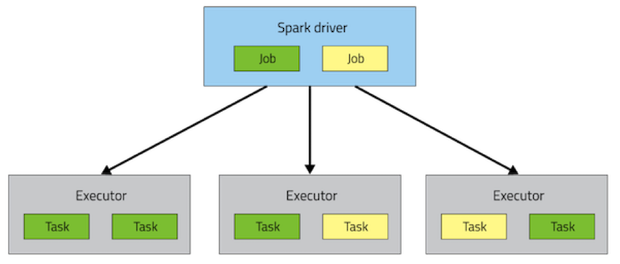
sc.textFile("someFile.txt").map(mapFunc).flatMap(flatMapFunc).filter(filterFunc).count()
val tokenized = sc.textFile(args(0)).flatMap(_.split(' '))val wordCounts = tokenized.map((_,1)).reduceByKey(_ + _)val filtered = wordCounts.filter(_._2 >=1000)val charCounts = filtered.flatMap(_._1.toCharArray).map((_,1)).reduceByKey(_ + _)charCounts.collect()
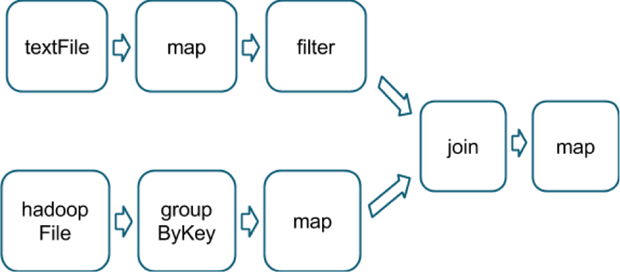
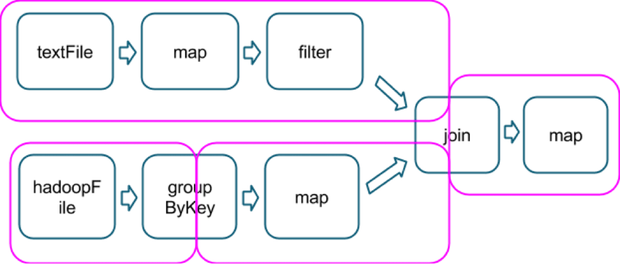
选择正确的操作
- 当执行一个associative reductive 操作时不要使用groupbykey,例如。 rdd.groupbykey().mapValues(_.sum)和rdd.reduceBykey(_+_)的结果一样,但是前面的操作会导致所有的数据进行网络传输,后者只会先在本地计算每个patition相同key的和,然后通过shuffler合并所有本地计算的和(都会有shuffle,但是传输的数据减少了很多)
- 当输入和输出的类型不一样时不要使用reduceByKey,例如
当写一个transformation用来找到每一个key对应唯一的一个字符串是,一种方式如下:rdd.map(kv => (kv._1, new Set[String]() + kv._2)).reduceByKey(_ ++ _),该操作会导致大量的不必要的set对象,每个key都会创建一个,这里最好使用aggregateBykey,它会执行map端的聚集更有效val zero =new collection.mutable.Set[String]()rdd.aggregateByKey(zero)((set, v)=> set += v,(set1, set2)=> set1 ++= set2)
什么时候shuffle不会发生
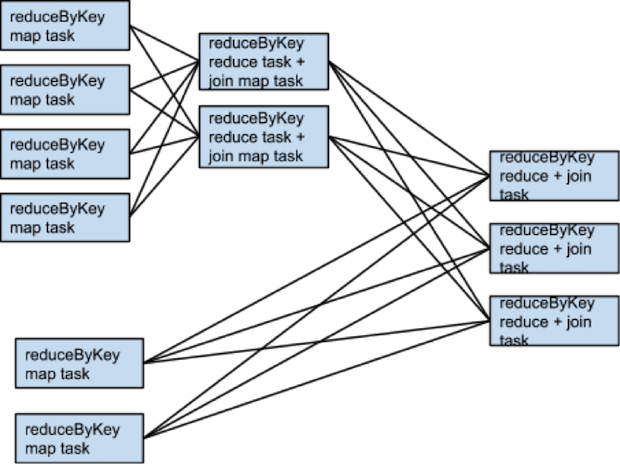
rdd1 = someRdd.reduceByKey(...)rdd2 = someOtherRdd.reduceByKey(...)rdd3 = rdd1.join(rdd2)
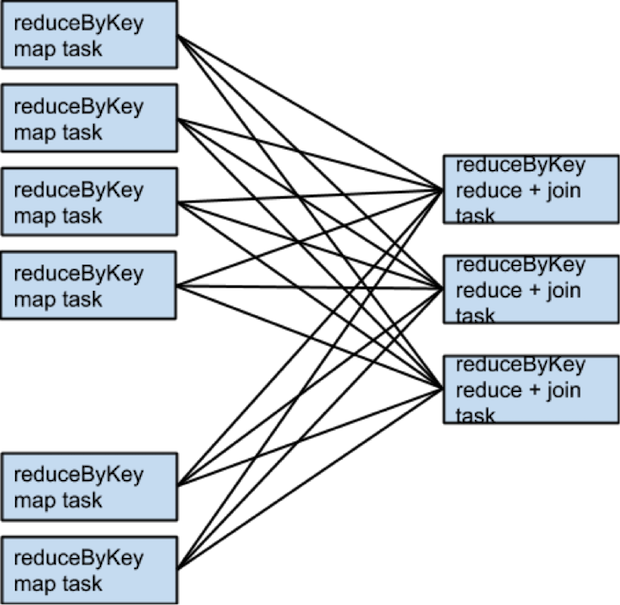
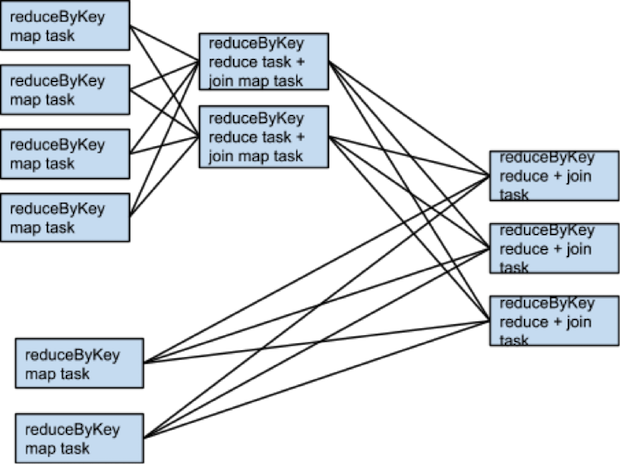
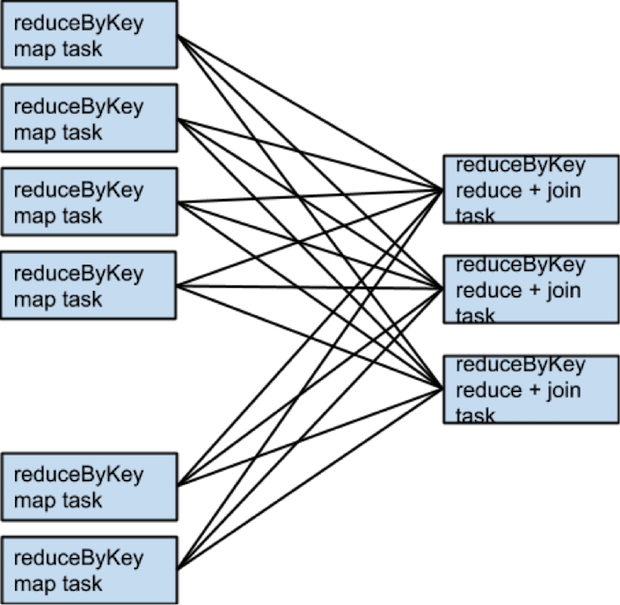
什么时候需要更多的shuffle
二次排序
Spark的job调优(1)的更多相关文章
- Spark:性能调优
来自:http://blog.csdn.net/u012102306/article/details/51637366 资源参数调优 了解完了Spark作业运行的基本原理之后,对资源相关的参数就容易理 ...
- Spark的性能调优杂谈
下面这些关于Spark的性能调优项,有的是来自官方的,有的是来自别的的工程师,有的则是我自己总结的. 基本概念和原则 <1> 每一台host上面可以并行N个worker,每一个worke ...
- spark submit参数调优
在开发完Spark作业之后,就该为作业配置合适的资源了.Spark的资源参数,基本都可以在spark-submit命令中作为参数设置.很多Spark初学者,通常不知道该设置哪些必要的参数,以及如何设置 ...
- Spark Streaming性能调优详解
Spark Streaming性能调优详解 Spark 2015-04-28 7:43:05 7896℃ 0评论 分享到微博 下载为PDF 2014 Spark亚太峰会会议资料下载.< ...
- spark 资源参数调优
资源参数调优 了解完了Spark作业运行的基本原理之后,对资源相关的参数就容易理解了.所谓的Spark资源参数调优,其实主要就是对Spark运行过程中各个使用资源的地方,通过调节各种参数,来优化资源使 ...
- Spark(九)Spark之Shuffle调优
一.概述 大多数Spark作业的性能主要就是消耗在了shuffle环节,因为该环节包含了大量的磁盘IO.序列化.网络数据传输等操作.因此,如果要让作业的性能更上一层楼,就有必要对shuffle过程进行 ...
- Spark(六)Spark之开发调优以及资源调优
Spark调优主要分为开发调优.资源调优.数据倾斜调优.shuffle调优几个部分.开发调优和资源调优是所有Spark作业都需要注意和遵循的一些基本原则,是高性能Spark作业的基础:数据倾斜调优,主 ...
- Spark的性能调优
下面这些关于Spark的性能调优项,有的是来自官方的,有的是来自别的的工程师,有的则是我自己总结的. Data Serialization,默认使用的是Java Serialization,这个程序员 ...
- Spark Streaming性能调优详解(转)
原文链接:Spark Streaming性能调优详解 Spark Streaming提供了高效便捷的流式处理模式,但是在有些场景下,使用默认的配置达不到最优,甚至无法实时处理来自外部的数据,这时候我们 ...
- Spark Streaming性能调优
数据接收并行度调优(一) 通过网络接收数据时(比如Kafka.Flume),会将数据反序列化,并存储在Spark的内存中.如果数据接收称为系统的瓶颈,那么可以考虑并行化数据接收.每一个输入DStrea ...
随机推荐
- Kernel,Shell,Bash 的关系
Kernel (内核) Kernel 操作系统内核 操作系统内核是指大多数操作系统的核心部分.它由操作系统中用于管理存储器.文件.外设和系统资源的那些部分组成.操作系统内核通常运行进程,并提供进程间的 ...
- Anaconda 使用conda常用命令
1.首先在所在系统中安装Anaconda.可以打开命令行输入conda -V检验是否安装以及当前conda的版本. 2.conda常用的命令. 1)conda list 查看安装了哪些包. 2)con ...
- 使用.NET Remoting开发分布式应用——配置文件篇
我们已经知道可以通过编码的方式配置服务器通道和远程客户机,除此之外,还可以使用配置文件对服务器通道和远程客户机进行配置.使用远程客户机和服务器对象的配置文件的优点在于,用户无需修改任何一行代码,也无需 ...
- the road of test
1.firefox打印兼容问题: <HTML> <HEAD> <TITLE>JavaScript利用IE内置打印控件IEWebBrowser进行打印/打印页面设置/ ...
- ubutun
地址:http://www.cnblogs.com/dutlei/archive/2012/11/20/2778327.html
- 关于bc 的scale .
linux下的bc命令可以设置结果的位数,通过 scale. 比如: $ echo "scale=4; 1.2323293128 / 1.1" | bc -l1.1202 但是sc ...
- html5移动开发的几大特性
html5移动开发的出现让移动平台的竞争由系统平台转向了浏览器之间:移动端的IE.Chrome.FireFox.Safari,亦或是新出现的浏览器,谁能达到在移动端对HTML5更好的支持,谁就能在以后 ...
- 屏蔽sql server 2008的智能提示
1. 去掉这个勾 2. 如果你安装了Sql complete, 接着下面的
- SizeGripStyle 枚举
成员名称 说明 Auto 需要时会自动显示大小调整的箭头图标 Hide 大小调整的箭头图标被隐藏. (SizeGripStyle=Hide,禁用拖动窗体右下角可以改变大小的功能) Sho ...
- JSP搭建
Tomcat7已经发布多时,Tomcat7增加了对Servlet 3.0,JSP 2.2和JSP-EL 2.2的支持.支持web application内存泄露的检测和防护等很多新功能.本片教程主要介 ...