
Solr6 +mmseg4j+IK-Analyzer + SQLserver +DIH 完全配置
如今做任何一个系统都有搜索,而搜索界有著名的三剑客: solr/elasticsearch/sphinx
solr/elasticsearch 为同一类的,都是基于lucene开发的产品,本人也早在几年前用过solr做过类似中关村的产品搜索,faceting功能非常好用.
近期手头上又有个项目要搭建搜索,由于几年没摸过Solr,如今再次打开官网已觉得很陌生,不仅主页换漂亮了,版本更是到了6.1 ,还有了 solr cloud的概念!!
废话不多说,首先来介绍下环境配置:
1. 去 http://www.apache.org/dyn/closer.lua/lucene/solr/6.1.0 下载zip,解压放到你想放的位置, 我放到了E盘根目录
2. 设置环境变量PATH: E:\solr-6.1.0\bin , 这是为了方便在命令行里面可以直接找到 solr 命令
3. 任意位置创建一个目录,该目录包含以下内容
1). IK+mmseg4j的字典
2).sqlserver jdbc 驱动
3).最新版的 ik+mmseg4j 的 jar包
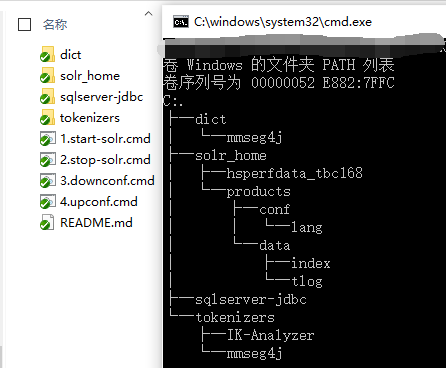
然后在目录下创建一个 1.start-solr.cmd (你喜欢的名字),内容如下:
solr start -h localhost -p 58983 -m 1g -s "%~dp0solr_home" -noprompt -V
双击运行(如果目录是需要管理员权限的, 有可能需要管理方式运行)
下面来说说具体配置
solrconfig.xml (\solr_home\products\conf\solrconfig.xml)
该配置文件是放到core里面的,我新建一个products的core
把所有依赖的jar包配置进去
<lib dir="${solr.install.dir:../../../..}/dist/" regex="solr-dataimporthandler-.*\.jar" />

 <!--同时兼容mmseg4j+ik中文分词器-->

  <lib dir="${solr.solr.home}/../tokenizers/mmseg4j" regex=".*\.jar" />

  <lib dir="${solr.solr.home}/../tokenizers/IK-Analyzer" regex=".*\.jar" />

  <lib dir="${solr.solr.home}/../sqlserver-jdbc" regex=".*\.jar" />
启用DIH,这里要注意这个功能依赖上面的 solr-dataimporthandler-xx.jar 配置
<!--启用DIH数据导入-->

  <requestHandler name="/dataimport" class="solr.DataImportHandler">

    <lst name="defaults">

      <str name="config">db-data-config.xml</str>

    </lst>

  </requestHandler>
以下是solr6里面,如果要手动修改schame.xml配置时要替换的,详见注释链接
<!-- 这里需要配置这个,https://cwiki.apache.org/confluence/display/solr/Schema+Factory+Definition+in+SolrConfig -->

<schemaFactory class="ClassicIndexSchemaFactory"/>
schema.xml 配置
<!--以下定义中文分词器及各自的词典配置-->

  <fieldtype name="mmseg4jComplex" class="solr.TextField" positionIncrementGap="100">

    <analyzer>

      <tokenizer class="com.chenlb.mmseg4j.solr.MMSegTokenizerFactory" mode="complex"  dicPath="${solr.solr.home:}/../dict/mmseg4j" />

    </analyzer>

  </fieldtype>

  <fieldtype name="mmseg4jMaxWord" class="solr.TextField" positionIncrementGap="100">

    <analyzer>

      <tokenizer class="com.chenlb.mmseg4j.solr.MMSegTokenizerFactory" mode="max-word"  dicPath="${solr.solr.home:}/../dict/mmseg4j"  />

    </analyzer>

  </fieldtype>

  <fieldtype name="mmseg4jSimple" class="solr.TextField" positionIncrementGap="100">

    <analyzer>

      <tokenizer class="com.chenlb.mmseg4j.solr.MMSegTokenizerFactory" mode="simple"  dicPath="${solr.solr.home:}/../dict/mmseg4j" />

    </analyzer>

  </fieldtype>

  <fieldType name="text_ik" class="solr.TextField">

    <!--索引时候的分词器-->

    <analyzer type="index">

      <tokenizer class="org.wltea.analyzer.util.IKTokenizerFactory" useSmart="true"/>

    </analyzer>

    <!--查询时候的分词器-->

    <analyzer type="query">

      <tokenizer class="org.wltea.analyzer.util.IKTokenizerFactory" useSmart="false"/>

    </analyzer>

  </fieldType>
db-data-config.xml
<dataConfig>

  <dataSource type="JdbcDataSource"

          driver="com.microsoft.sqlserver.jdbc.SQLServerDriver"

          url="jdbc:sqlserver://127.0.0.1:1433;databaseName=xxdb;"

          user="dev"

          password="111111"

          batchSize="100" />

  <document>

    <entity name="product" query="select [id],[name],[brief],[description] from [products]"

            deltaQuery="select id from [products] where [lastmodificationtime] > '${dataimporter.last_index_time}'">

      <field column="name" name="name" />

      <field column="brief" name="brief" />

      <field column="description" name="description" />

    </entity>

  </document>

</dataConfig>
以上配置内包含的路径均没有写死, 使用的占位符, 可用的占位符可以在 solr admin ui 的 dashboard JVM 栏看到

!!!!!!!!!!!!!!!!!前方高能!!!!!!附件说明!!!!!!!!!!
(一定要先配置PATH环境变量后再双击)

Solr6 +mmseg4j+IK-Analyzer + SQLserver +DIH 完全配置的更多相关文章
- 转:solr6.0配置中文分词器IK Analyzer
solr6.0中进行中文分词器IK Analyzer的配置和solr低版本中最大不同点在于IK Analyzer中jar包的引用.一般的IK分词jar包都是不能用的,因为IK分词中传统的jar不支持s ...
- 我与solr(六)--solr6.0配置中文分词器IK Analyzer
转自:http://blog.csdn.net/linzhiqiang0316/article/details/51554217,表示感谢. 由于前面没有设置分词器,以至于查询的结果出入比较大,并且无 ...
- 安装elasticsearch及中文IK和近义词配置
安装elasticsearch及中文IK和近义词配置 安装java环境 java环境是elasticsearch安装必须的 yum install java-1.8.0-openjdk 安装elast ...
- Solr学习(2) Solr4.2.0+IK Analyzer 2012
Solr学习(二) Solr4.2.0+IK Analyzer 2012 开场白: 本章简单讲述如何在solr中配置著名的 IK Analyzer 分词器. 本章建立在 Solr学习(一) 基础上进 ...
- Lucene全文搜索之分词器:使用IK Analyzer中文分词器(修改IK Analyzer源码使其支持lucene5.5.x)
注意:基于lucene5.5.x版本 一.简单介绍下IK Analyzer IK Analyzer是linliangyi2007的作品,再此表示感谢,他的博客地址:http://linliangyi2 ...
- 安装elasticsearch-1.7.1及中文IK和近义词配置
安装elasticsearch及中文IK和近义词配置 https://www.cnblogs.com/yjf512/p/4789239.html 安装elasticsearch及中文IK和近义词配置 ...
- ElasticSearch7.3学习(十五)----中文分词器(IK Analyzer)及自定义词库
1. 中文分词器 1.1 默认分词器 先来看看ElasticSearch中默认的standard 分词器,对英文比较友好,但是对于中文来说就是按照字符拆分,不是那么友好. GET /_analyze ...
- SharePoint 2013+ Sqlserver 2014 Kerberos 配置传奇, 最终的解决方案 验证。
SharePoint 2013+ Sqlserver 2014 Kerberos 配置传奇. 1,安装数据库,我就不多说安装,客户一定要注意. 我将参照以下实施例和账户. 2,建立DNS,假设没有DN ...
- Win7下Solr4.10.1和IK Analyzer中文分词
1.下载IK中文分词压缩包IK Analyzer 2012FF_hf1,并解压到D:\IK Analyzer 2012FF_hf1: 2.将D:\IK Analyzer 2012FF_hf1\IKAn ...
随机推荐
- CSS垂直居中小结
1.设置子元素: { ... position :absolute; margin:auto; top:; right:; bottom:; left:; } 2.设置子元素:(height必须是固定 ...
- java.sql.Date和java.util.Date的不同和相互转换方式
一:前言 这是我在新的公司写的第一份博客吧,来了又一个星期了吧,但是在来的那几天我真的很迷茫的感觉这里是很不适合我的样子,而且我又是来实习的,我很不愿意啊,自己做的又是java web,最原始的ser ...
- jsp中路径的问题。。。
刚刚学jsp的时候都是从看别人的代码,模仿着做,但是这样也有看不懂的地方,这个相对路径和绝对路径就让我纠结了好久..所以我自己弄了一个demo实验了一下,试验出结果了,但是不明白原理,纠结了一天,终于 ...
- GET和POST本质上有什么区别,这才是标准答案
不知道各位读者在面试的时候,有没有被问过这个问题:"请说一下GET和POST两者的本质区别".基本上做过WEB开发的,对这个问题,都可以回答出一堆的区别. 比如: 最直接的区别,G ...
- hive向表格中插入数据并分析语句
1,---导入mds_imei_month_info ; //最大的动态分区表 set hive.support.concurrency=false; //是否支持并发 ; //each mapper ...
- 文本区 JTextArea 的使用
文本区JTextArea是对多行文本进行编辑的组件,用空字符来控制文本的格式.eg:"\n"为换行,"\t"为插入一个Tab字符. 文本去JTextArea的常 ...
- 关于dlib人脸对比,人脸识别
人脸检测 人脸特征点提取 人脸对比,等于两张人脸对比,识别 封装的所有识别函数,直接看下面调用就好了. # coding:utf-8 ''' 本本次封装,我主要是做两张人脸对比. 就只人脸识别部分,简 ...
- 用 C# 代码如何实现让你的电脑关机,重启,注销,锁定,休眠,睡眠
简介 本文讲述了用 C# 代码如何实现让你的电脑关机,重启,注销,锁定,休眠,睡眠. 如何实现 首先,使用 using 语句添加我们需要的命名空间: using System.Diagnostics; ...
- MySQL 查询语句练习2
创建表 /* Navicat MySQL Data Transfer Source Server : localhost_3306 Source Server Version : 50719 Sour ...
- 在opensuse 中安装视频解码器
最近由于需要32位的linux系统使用,很多版本的linux都不再发布32的安装镜像了,有一些又不是很熟悉,我熟悉的manjaro发布的32镜像又不是kde桌面,最后发现opensuse的滚动版本,即 ...