
Python——requests的安装及入门-贴吧爬虫
一.windows平台下requests的安装
1.win+R,输入cmd,打开命令行窗口,输入命令:pip install requests ,即可自动安装库成功
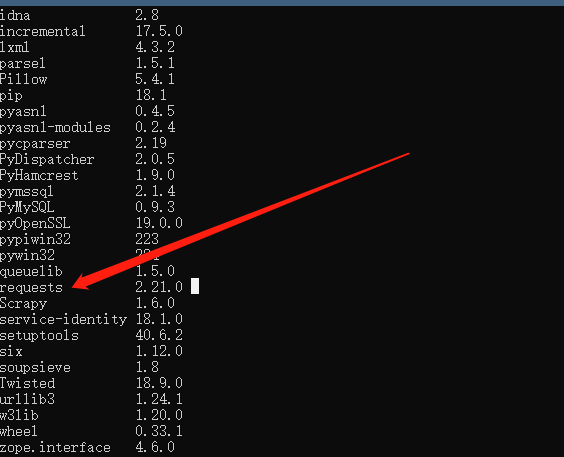
2.输入命令:pip list,即可查看所有已安装的模块,可以看到requests已成功安装
二.利用Requests写一个贴吧爬虫
1.首先导入模块:import requesets
2.写一个类,__init__方法需要一个参数tieba_name,来表示要爬取的贴吧名字,同时为该类的对象设置属性self.url_temp和self.hearders,他们分别表示,要爬取的贴吧网站和请求头
3.方法说明:
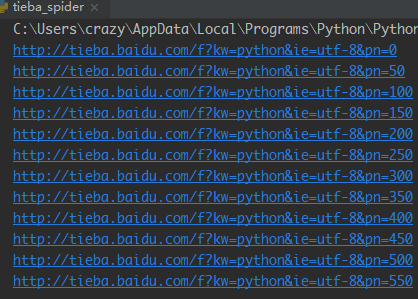
get_url_list(self):该方法生成要爬取的贴吧的每一页的网站列表,因为贴吧每增加一页,网页参数pn加50(第一页为0),因此用列表推导式
[self.url_temp.format(i * 50) for i in range(1000)]生成列表;
parse_url(self, url):传入一个要爬去的网页,获取其数据流并解码,使用requests.get()方法,该方法用于请求一个网页,这里传递给它两个参数,一个是要爬去的网站,另一个是请求头;
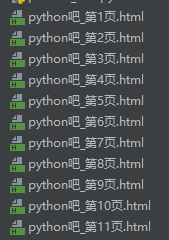
save_html(self, html_str, page_num):用于保存页面内容;
run(self):运行该爬虫对象;
4.测试:以下代码中 创建了一个 爬取Python吧的对象,并爬取页面内容。运行结果如下
 import requests

 class Tiebaspider:

     # 构造方法,需要一个参数tieba_name

     def __init__(self, tieba_name):

         self.tieba_name = tieba_name

         self.url_temp = 'http://tieba.baidu.com/f?kw=' + tieba_name + '&ie=utf-8&pn={}'

         self.hearders = {

             'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36'}

     # 构造url列表

     def get_url_list(self):

         return [self.url_temp.format(i * 50) for i in range(1000)]

     # 发送请求,并返回请求的内容。decode()默认用utf-8解码

     def parse_url(self, url):

         print(url)

         response = requests.get(url, headers=self.hearders)

         return response.content.decode()

     # 保存内容

     def save_html(self, html_str, page_num):

         file_path = '{}吧_第{}页.html'.format(self.tieba_name, page_num)

         # 注意给encodeing传递编码参数,否则会产生无法编码的异常

         with open(file_path, "w", encoding='utf-8') as f_obj:

             f_obj.write(html_str)

     #

     def run(self):

         #  1.构造url列表

         url_list = self.get_url_list()

         #  2.遍历,发送请求,

         for url in url_list:

             page_num = url_list.index(url) + 1  # 页码数

             html_str = self.parse_url(url)  # 发送请求,返回内容

             self.save_html(html_str, page_num)  # 保存内容

 if __name__ == '__main__':

     tieba_spider = Tiebaspider('python')

     tieba_spider.run()
Python——requests的安装及入门-贴吧爬虫的更多相关文章
- (转)python requests的安装与简单运用
requests是python的一个HTTP客户端库,跟urllib,urllib2类似,那为什么要用requests而不用urllib2呢?官方文档中是这样说明的: python的标准库urllib ...
- python requests的安装与简单运用
requests是python的一个HTTP客户端库,跟urllib,urllib2类似,那为什么要用requests而不用urllib2呢?官方文档中是这样说明的: python的标准库urllib ...
- 转: python requests的安装与简单运用
requests是Python的一个HTTP客户端库,跟urllib,urllib2类似,那为什么要用requests而不用urllib2呢? 官方文档中是这样说明的: python的标准库urlli ...
- 【Python高级工程师之路】入门+进阶+实战+爬虫+数据分析整套教程
点击了解更多Python课程>>> 全网最新最全python高级工程师全套视频教程学完月薪平均2万 什么是Python? Python是一门面向对象的编程语言,它相对于其他语言,更加 ...
- 「Python」python-nmap安装与入门
1.安装namp https://nmap.org/download.html 下载链接 PS:windows安装似乎麻烦一些,需要多下载npcap,官网有链接 2.python安装 注意,注意,注意 ...
- OpenCV:Python下OpenCV安装和入门最强详细攻略
一.关于OpenCV简介 OpenCV是一个基于BSD许可(开源)发行的跨平台计算机视觉库,可以运行在Linux.Windows.Android和Mac OS操作系统上.它轻量级而且高效— ...
- python requests的安装与简单运用(转)
http://www.cnblogs.com/fightformylife/p/4134986.html http://cn.python-requests.org/zh_CN/latest/ htt ...
- 转:Python requests 快速入门
迫不及待了吗?本页内容为如何入门Requests提供了很好的指引.其假设你已经安装了Requests.如果还没有, 去 安装 一节看看吧. 首先,确认一下: ·Requests 已安装 ·Reques ...
- Python Requests快速入门
迫不及待了吗?本页内容为如何入门Requests提供了很好的指引.其假设你已经安装了Requests.如果还没有, 去 安装 一节看看吧. 首先,确认一下: Requests 已安装 Requests ...
随机推荐
- HTML篇
要内容 web标准 浏览器介绍 开发工具介绍 HTML介绍 HTML颜色介绍 HTML规范 HTML结构详解 一.web标准 web准备介绍: w3c:万维网联盟组织,用来制定web标准的机构(组织) ...
- Axure RP的基础使用
Axure RP是一个专业的快速原型设计工具. 在上面可以直接设计软件的原型而且不涉及代码,例如设计软件的流程和界面之类的.简单的说,就是可以在上面编写界面,让人看起来像一个完整的软件一样. 设置完成 ...
- 监控Mongo慢查询
监控Mongo慢查询 1. 使用mongostat监控MongoDB全局情况 mongostat是mongdb自带的状态检测工具,在命令行下使用.它会间隔固定时间获取MongoDB的当前运行状态,并输 ...
- 新浪微博logo已经去掉了“新浪”二字
如果有一天我能做出一个产品,它的命名就以我所在的行业命名该多好啊,可惜那只是一个梦.但这样的梦新浪微博却实现了,今天我登陆新浪微博的时候发 现logo已经去掉了“新浪”二字,我开始还以为我自己的电脑网 ...
- Android模拟器出现emulator-5554 disconnected! Cancelling activity launch !的解决办法
关于 emulator-5554 disconnected! Cancelling 'xxx activity launch'!的问题,解决方法: d: cd D:/Program Files/and ...
- 10个强大的Javascript表单验证插件推荐
创建一个JavaScript表单验证插件,可以说是一个繁琐的过程,涉及到初期设计.开发与测试等等环节.实际上一个优秀的程序员不仅是技术高手,也应该是善假于外物的.本文介绍了10个不错的JavaScri ...
- FutureTask子任务取消执行的状态判断
示例代码可以从github上获取 https://github.com/git-simm/simm-framework.git 一.业务场景: 系统中存在多种场景并发操作事务执行时互锁的情况,导致任务 ...
- linux内存监控 free
free 命令详解: 执行命令后总共四行. 第一行: 列头 第二行: total 内存总数: 32881776 used 已经使用的内存数: 8324796 free 空闲的内存数: 24556980 ...
- (转)jquery仿天猫商城左侧导航菜单
原文地址:http://www.cnblogs.com/WinKi/p/3398824.html 之前看到有博友写了一个仿天猫商城左侧导航菜单,可惜不提供免费下载,也没有代码.以前自己也写过类似的效果 ...
- Word文件乱码XML
文章介绍 一个朋友写的文档因为异常关机,导致全部文件变成了xml的乱码,正好帮他解决了,感觉这些或许有些帮助,就先记录下来了. 破损文件介绍 文件破坏之后,打开全是xml格式的文档,结构如下. 恢复过 ...