
大数据-业务数据采集-FlinkCDC
CDC
CDC 是 Change Data Capture(变更数据获取)的简称。核心思想是,监测并捕获数据库的变动(包括数据或数据表的插入、更新以及删除等),将这些变更按发生的顺序完整记录下来,写入到消息中间件中以供其他服务进行订阅及消费。
CDC 的种类
CDC 主要分为基于查询和基于 Binlog 两种方式,我们主要了解一下这两种之间的区别:
| 基于查询的 CDC | 基于 Binlog 的 CDC | |
|---|---|---|
| 开源产品 | Sqoop、Kafka JDBC Source | Canal、Maxwell、Debezium |
| 执行模式 | Batch | Streaming |
| 是否可以捕获所有数据变化 | 否 | 是 |
| 延迟性 | 高延迟 | 低延迟 |
| 是否增加数据库压力 | 是 | 否 |
FlinkCDC
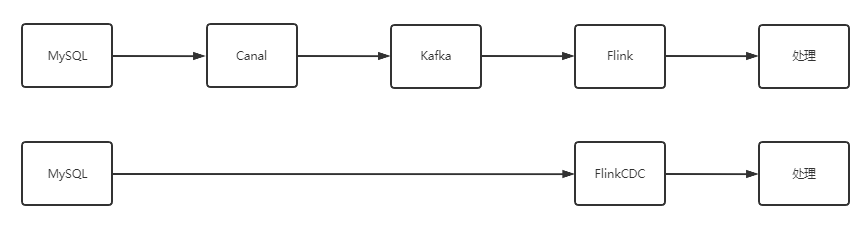
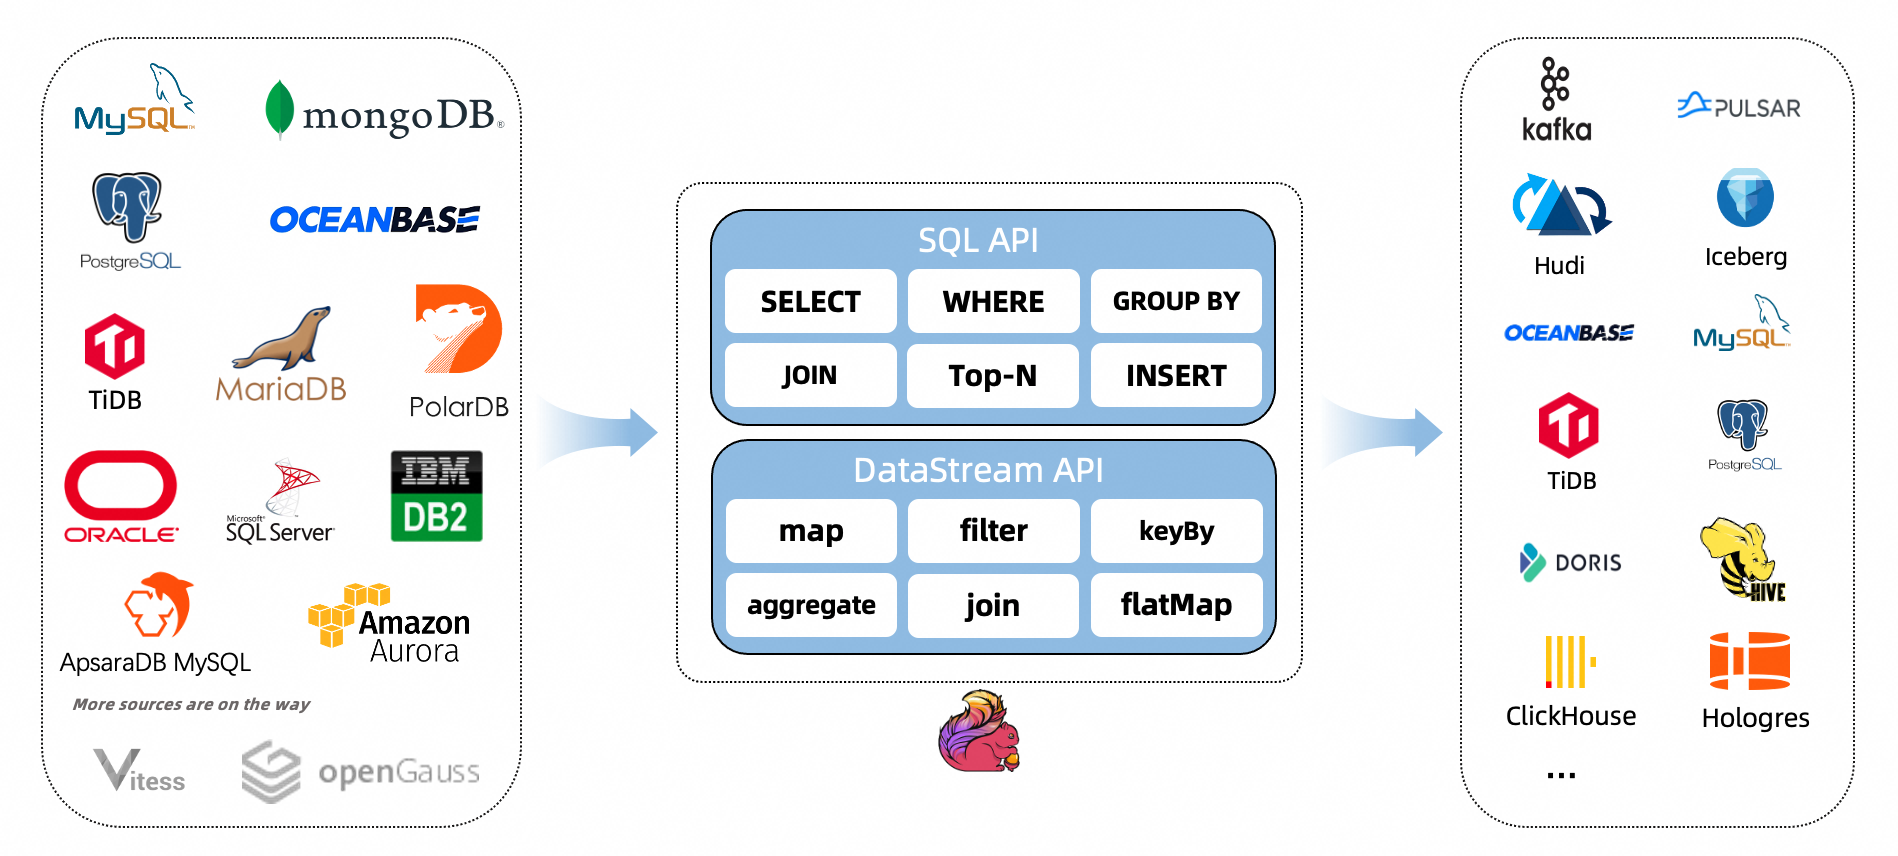
Flink 社区开发了 flink-cdc-connectors 组件,这是一个可以直接从 MySQL、PostgreSQL 等数据库直接读取【全量数据】和【增量变更数据】的 source 组件。而不需要使用类似 Kafka 之类的中间件中转数据
目前也已开源,开源地址:https://github.com/ververica/flink-cdc-connectors
| Connector | Database | Driver |
|---|---|---|
| mongodb-cdc | MongoDB: 3.6, 4.x, 5.0 | MongoDB Driver: 4.3.1 |
| mysql-cdc | MySQL: 5.6, 5.7, 8.0.x RDS MySQL: 5.6, 5.7, 8.0.x PolarDB MySQL: 5.6, 5.7, 8.0.x Aurora MySQL: 5.6, 5.7, 8.0.x MariaDB: 10.x PolarDB X: 2.0.1 |
JDBC Driver: 8.0.27 |
| oceanbase-cdc | OceanBase CE: 3.1.x OceanBase EE (MySQL mode): 2.x, 3.x |
JDBC Driver: 5.1.4x |
| oracle-cdc | Oracle: 11, 12, 19 | Oracle Driver: 19.3.0.0 |
| postgres-cdc | PostgreSQL: 9.6, 10, 11, 12 | JDBC Driver: 42.2.12 |
| sqlserver-cdc | Sqlserver: 2012, 2014, 2016, 2017, 2019 | JDBC Driver: 7.2.2.jre8 |
| tidb-cdc | TiDB: 5.1.x, 5.2.x, 5.3.x, 5.4.x, 6.0.0 | JDBC Driver: 8.0.27 |
| db2-cdc | Db2: 11.5 | DB2 Driver: 11.5.0.0 |
DataStream:
- 优点: 多库多表
- 缺点: 需要自定义反序列化器(但灵活)
FlinkSQL: - 优点: 不需要自定义反序列化器
- 缺点: 单表
Demo
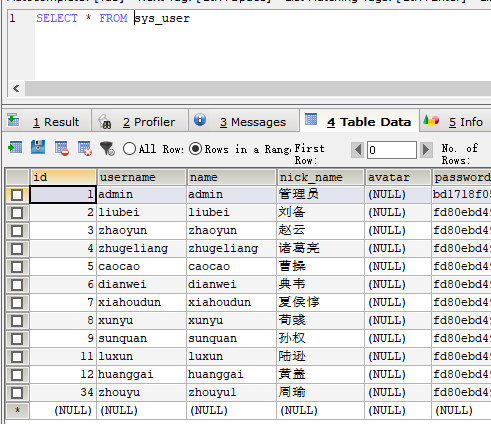
注意开启 binlog_format=ROW
my.ini
log-bin=mysql-bin

#binlog_format="STATEMENT"

binlog_format="ROW"

#binlog_format="MIXED"

#service-id=1
POM
  <dependencies>

        <dependency>

            <groupId>org.apache.flink</groupId>

            <artifactId>flink-java</artifactId>

            <version>1.12.0</version>

        </dependency>

        <dependency>

            <groupId>org.apache.flink</groupId>

            <artifactId>flink-streaming-java_2.12</artifactId>

            <version>1.12.0</version>

        </dependency>

        <dependency>

            <groupId>org.apache.flink</groupId>

            <artifactId>flink-clients_2.12</artifactId>

            <version>1.12.0</version>

        </dependency>

        <dependency>

            <groupId>org.apache.hadoop</groupId>

            <artifactId>hadoop-client</artifactId>

            <version>3.1.3</version>

        </dependency>

        <dependency>

            <groupId>mysql</groupId>

            <artifactId>mysql-connector-java</artifactId>

            <version>5.1.49</version>

        </dependency>

        <dependency>

            <groupId>com.alibaba.ververica</groupId>

            <artifactId>flink-connector-mysql-cdc</artifactId>

            <version>1.2.0</version>

        </dependency>

        <dependency>

            <groupId>com.alibaba</groupId>

            <artifactId>fastjson</artifactId>

            <version>1.2.75</version>

        </dependency>

        <dependency>

            <groupId>org.apache.flink</groupId>

            <artifactId>flink-table-planner-blink_2.12</artifactId>

            <version>1.12.0</version>

        </dependency>

    </dependencies>
基于 DataStream
CustomerDeserialization.java
package com.vipsoft;

import com.alibaba.fastjson.JSONObject;

import com.alibaba.ververica.cdc.debezium.DebeziumDeserializationSchema;

import io.debezium.data.Envelope;

import org.apache.flink.api.common.typeinfo.BasicTypeInfo;

import org.apache.flink.api.common.typeinfo.TypeInformation;

import org.apache.flink.util.Collector;

import org.apache.kafka.connect.data.Field;

import org.apache.kafka.connect.data.Schema;

import org.apache.kafka.connect.data.Struct;

import org.apache.kafka.connect.source.SourceRecord;

import java.util.List;

public class CustomerDeserialization implements DebeziumDeserializationSchema<String> {

    /**

     * 封装的数据格式

     * {

     * "database":"",

     * "tableName":"",

     * "before":{"id":"","tm_name":""....},

     * "after":{"id":"","tm_name":""....},

     * "type":"c u d",

     * //"ts":156456135615

     * }

     */

    @Override

    public void deserialize(SourceRecord sourceRecord, Collector<String> collector) throws Exception {

        //1.创建JSON对象用于存储最终数据

        JSONObject result = new JSONObject();

        //2.获取库名&表名

        String topic = sourceRecord.topic();

        String[] fields = topic.split("\\.");

        String database = fields[1];

        String tableName = fields[2];

        Struct value = (Struct) sourceRecord.value();

        //3.获取"before"数据

        Struct before = value.getStruct("before");

        JSONObject beforeJson = new JSONObject();

        if (before != null) {

            Schema beforeSchema = before.schema();

            List<Field> beforeFields = beforeSchema.fields();

            for (Field field : beforeFields) {

                Object beforeValue = before.get(field);

                beforeJson.put(field.name(), beforeValue);

            }

        }

        //4.获取"after"数据

        Struct after = value.getStruct("after");

        JSONObject afterJson = new JSONObject();

        if (after != null) {

            Schema afterSchema = after.schema();

            List<Field> afterFields = afterSchema.fields();

            for (Field field : afterFields) {

                Object afterValue = after.get(field);

                afterJson.put(field.name(), afterValue);

            }

        }

        //5.获取操作类型  CREATE UPDATE DELETE

        Envelope.Operation operation = Envelope.operationFor(sourceRecord);

        String type = operation.toString().toLowerCase();

        if ("create".equals(type)) {

            type = "insert";

        }

        //6.将字段写入JSON对象

        result.put("database", database);

        result.put("tableName", tableName);

        result.put("before", beforeJson);

        result.put("after", afterJson);

        result.put("type", type);

        //7.输出数据

        collector.collect(result.toJSONString());

    }

    @Override

    public TypeInformation<String> getProducedType() {

        return BasicTypeInfo.STRING_TYPE_INFO;

    }

}
FlinkCDC.java
package com.vipsoft;

import com.alibaba.ververica.cdc.connectors.mysql.MySQLSource;

import com.alibaba.ververica.cdc.connectors.mysql.table.StartupOptions;

import com.alibaba.ververica.cdc.debezium.DebeziumSourceFunction;

import com.alibaba.ververica.cdc.debezium.StringDebeziumDeserializationSchema;

import org.apache.flink.streaming.api.datastream.DataStreamSource;

import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class FlinkCDC {

    public static void main(String[] args) throws Exception {

        //1.获取执行环境

        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

        env.setParallelism(1);

        //2.通过FlinkCDC构建SourceFunction并读取数据

        DebeziumSourceFunction<String> sourceFunction = MySQLSource.<String>builder()

                .hostname("localhost")

                .serverTimeZone("GMT+8")  //时区报错增加这个设置

                .port(3306)

                .username("root")

                .password("110")

                .databaseList("springboot")

                .tableList("springboot.sys_user")   //如果不添加该参数,则消费指定数据库中所有表的数据.如果指定,指定方式为db.table

                //.deserializer(new StringDebeziumDeserializationSchema())

                .deserializer(new CustomerDeserialization()) //使用自定义反序列化器

                .startupOptions(StartupOptions.initial())

                .build();

        DataStreamSource<String> streamSource = env.addSource(sourceFunction);

        //3.打印数据

        streamSource.print();

        //4.启动任务

        env.execute("FlinkCDC");

    }

}
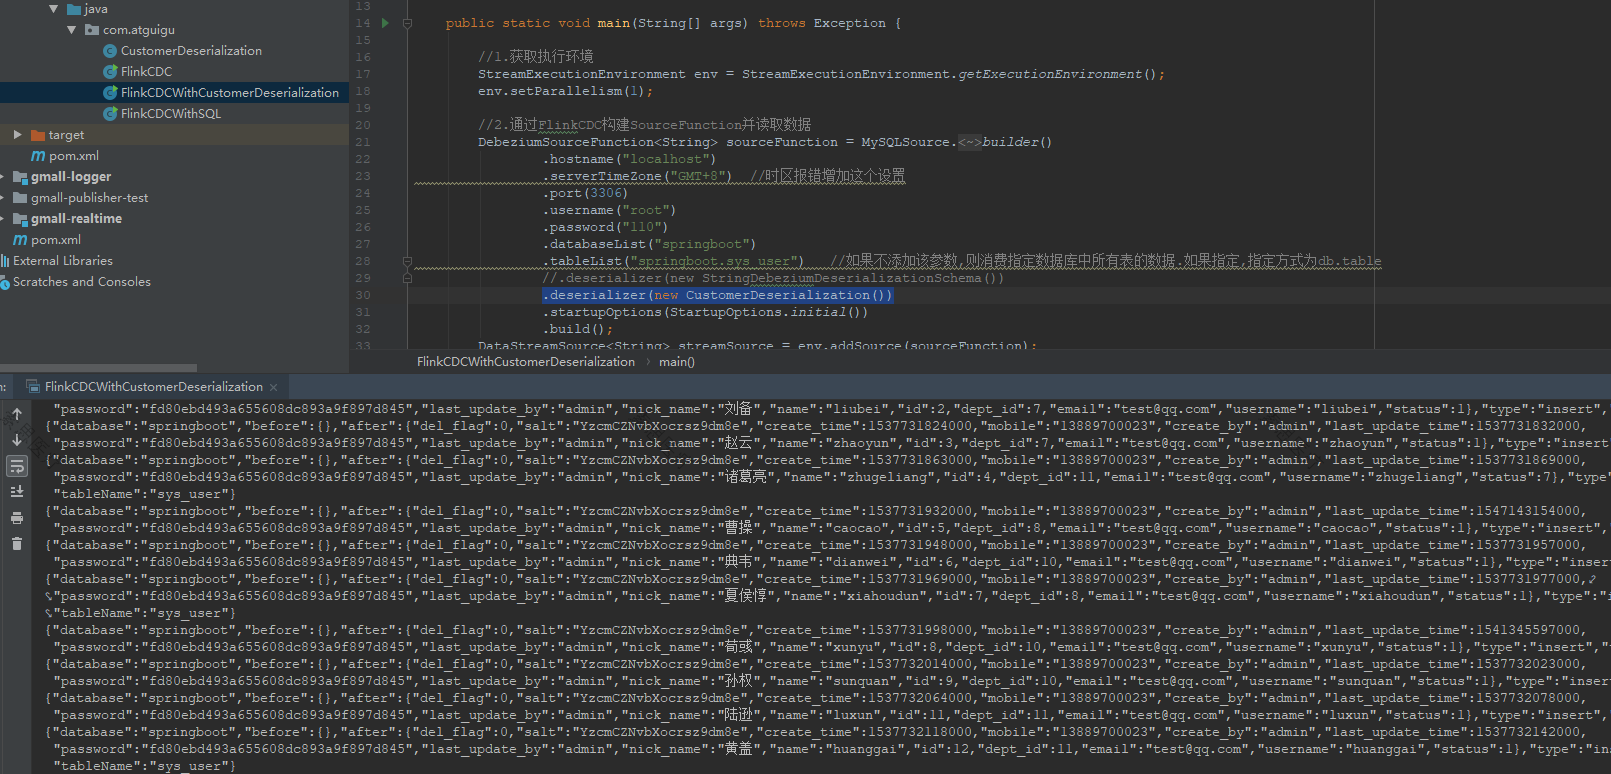
运行效果
- 默认 StringDebeziumDeserializationSchema

- 自定义反序列化器
FlinkSQL
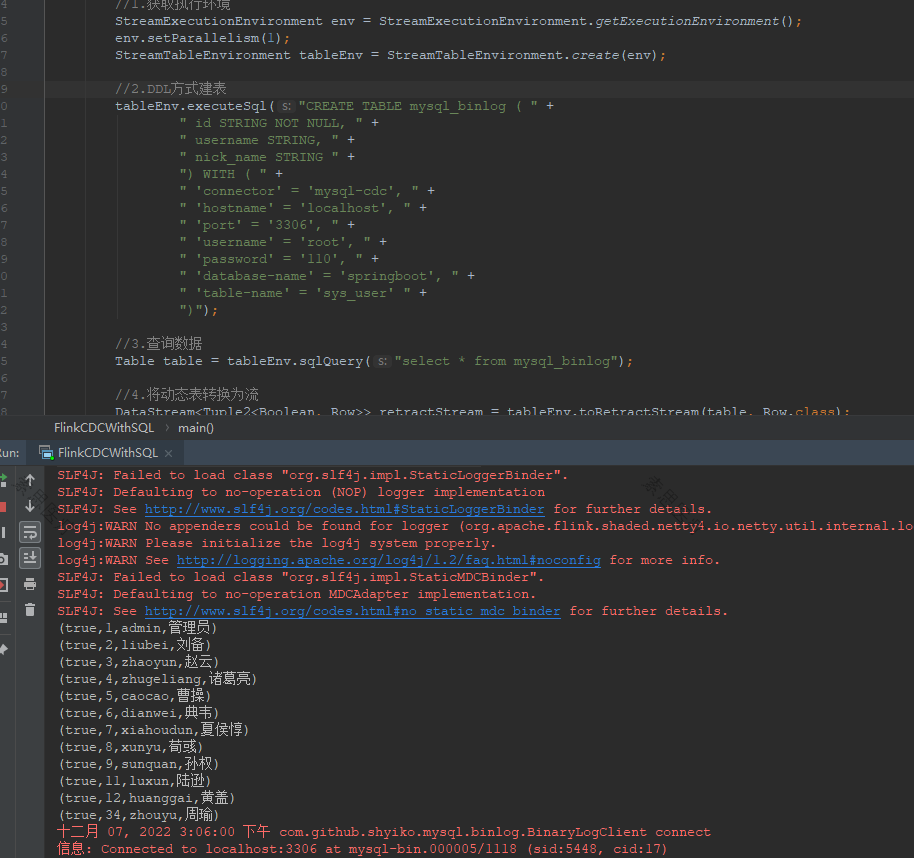
package com.vipsoft;

import org.apache.flink.api.java.tuple.Tuple2;

import org.apache.flink.streaming.api.datastream.DataStream;

import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

import org.apache.flink.table.api.Table;

import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;

import org.apache.flink.types.Row;

public class FlinkCDCWithSQL {

    public static void main(String[] args) throws Exception {

        //1.获取执行环境

        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

        env.setParallelism(1);

        StreamTableEnvironment tableEnv = StreamTableEnvironment.create(env);

        //2.DDL方式建表

        tableEnv.executeSql("CREATE TABLE mysql_binlog ( " +

                " id STRING NOT NULL, " +

                " username STRING, " +

                " nick_name STRING " +

                ") WITH ( " +

                " 'connector' = 'mysql-cdc', " +

                " 'hostname' = 'localhost', " +

                " 'port' = '3306', " +

                " 'username' = 'root', " +

                " 'password' = '110', " +

                " 'database-name' = 'springboot', " +

                " 'table-name' = 'sys_user' " +

                ")");

        //3.查询数据

        Table table = tableEnv.sqlQuery("select * from mysql_binlog");

        //4.将动态表转换为流

        DataStream<Tuple2<Boolean, Row>> retractStream = tableEnv.toRetractStream(table, Row.class);

        retractStream.print();

        //5.启动任务

        env.execute("FlinkCDCWithSQL");

    }

}
运行效果
对比
通过对比,FlinkCDC 最舒服
| FlinkCDC | Maxwell | Canal | |
|---|---|---|---|
| 断点续传 | CK | MySQL | 本地磁盘 |
| SQL -> 数据 | 无 | 无 | 一对一(炸开处理) |
| 初始化功能 | 有(多库多表) | 有(单表) | 无(单独查询历史数据) |
| 封装格式 | 自定义 | JSON | JSON(c/s自定义) |
| 高可用 | 运行集群高可用 | 无 | 集群(ZK) |
插入对比
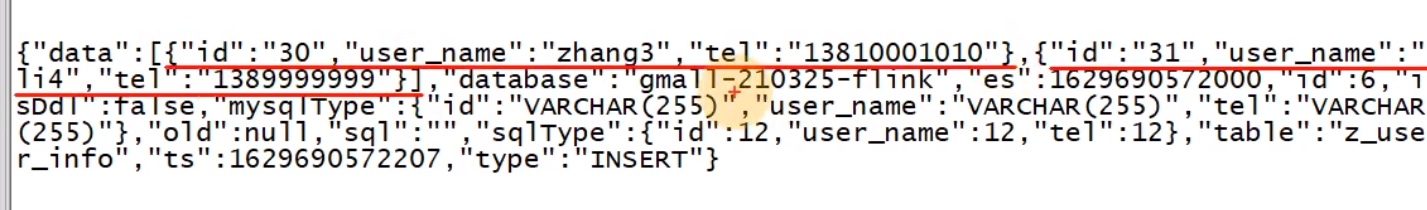
插入两条数据
INSER INTO z_user_info VALUES(30,'zhang3','13800000000'),(31,'li4','13999999999')
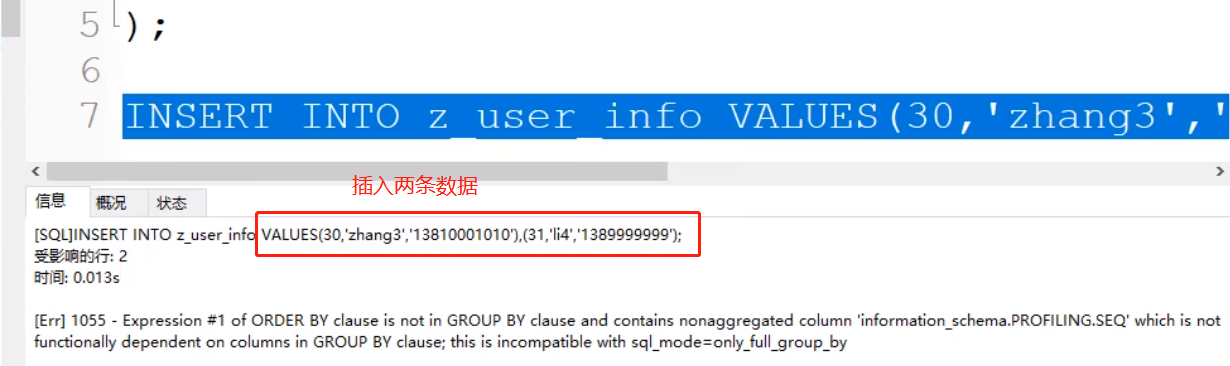
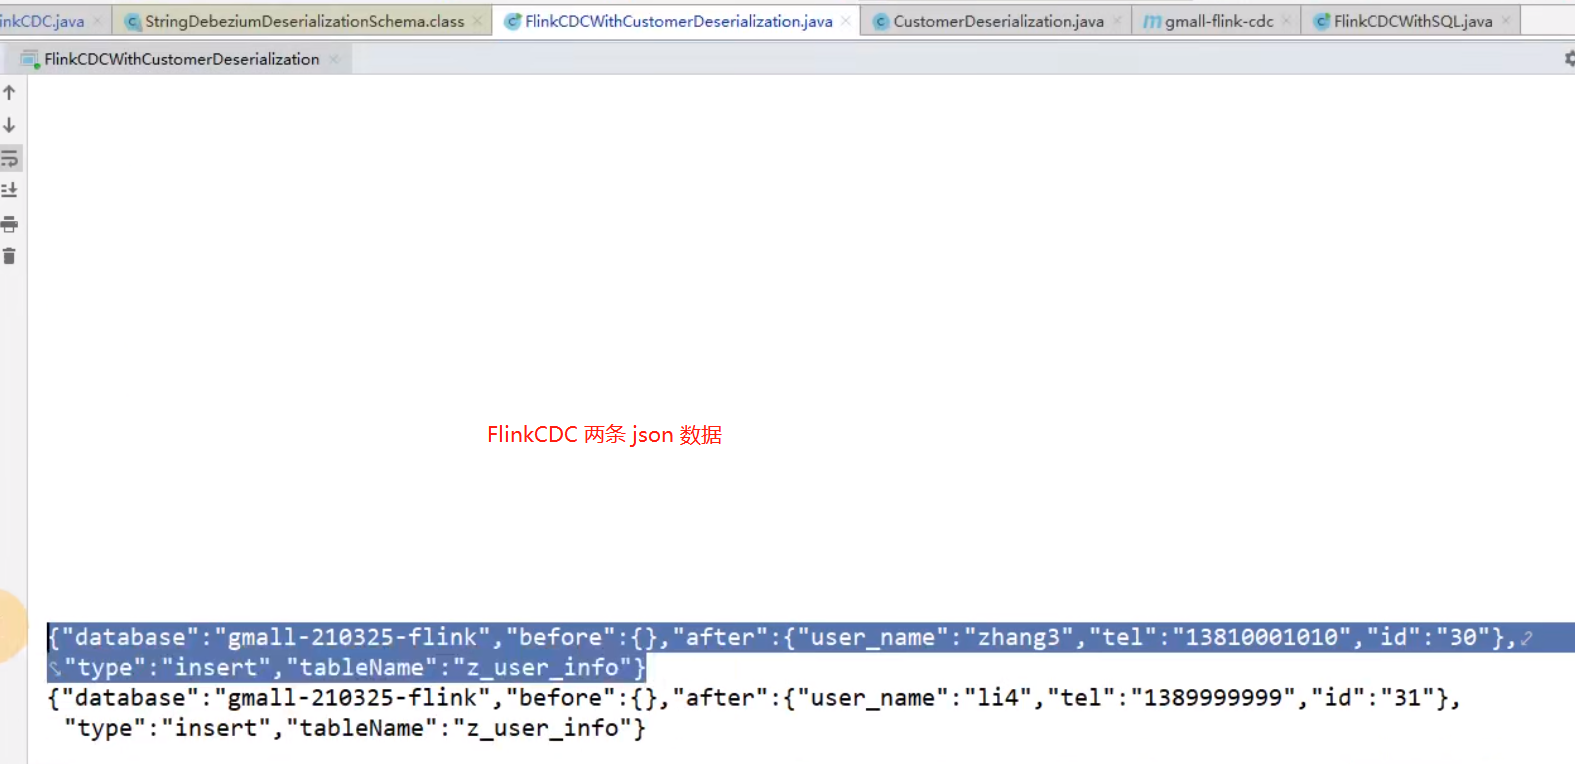
FlinkCDC 每条变化都会产生一条 json
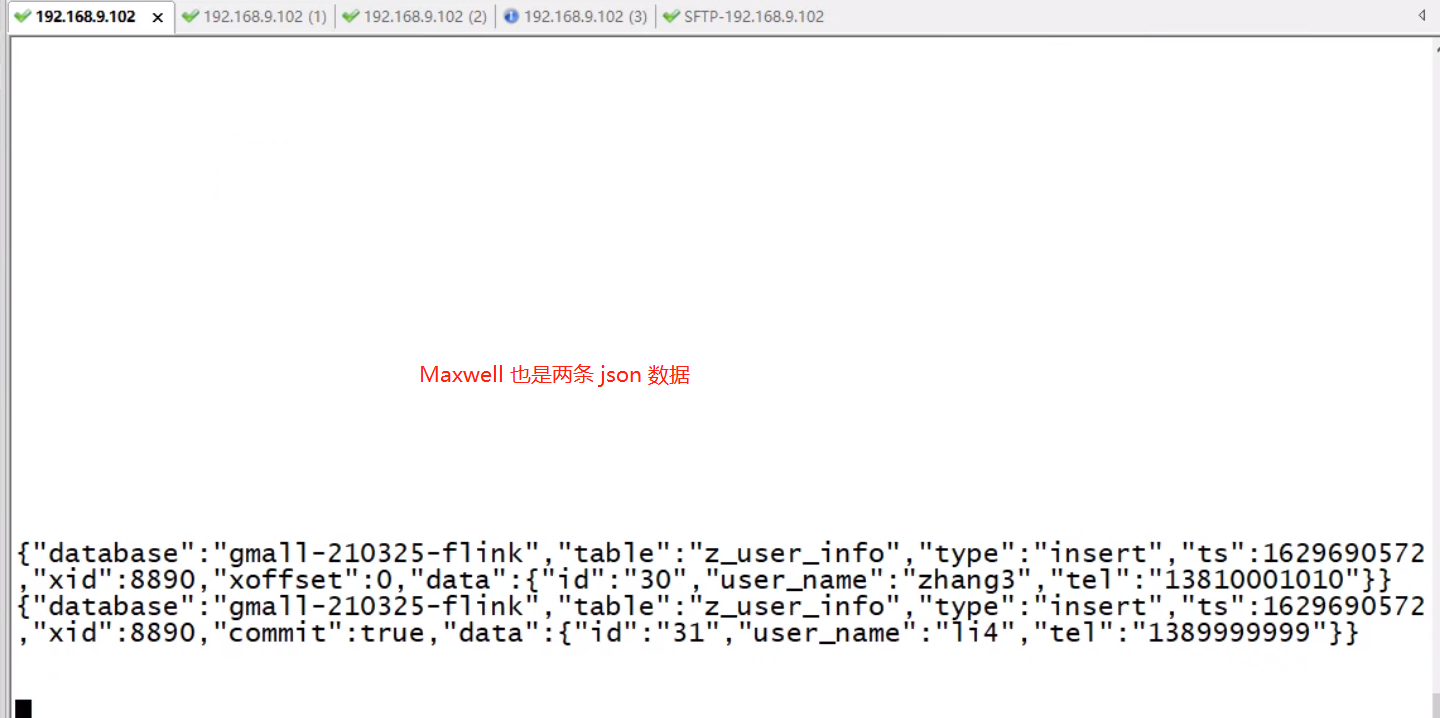
Maxwell 每条变化都会产生一条 json
Canal 一次性执行的SQL,会产生一条JSON(两条数据组合在一起)【不方便,需要炸开解析】
更新对比
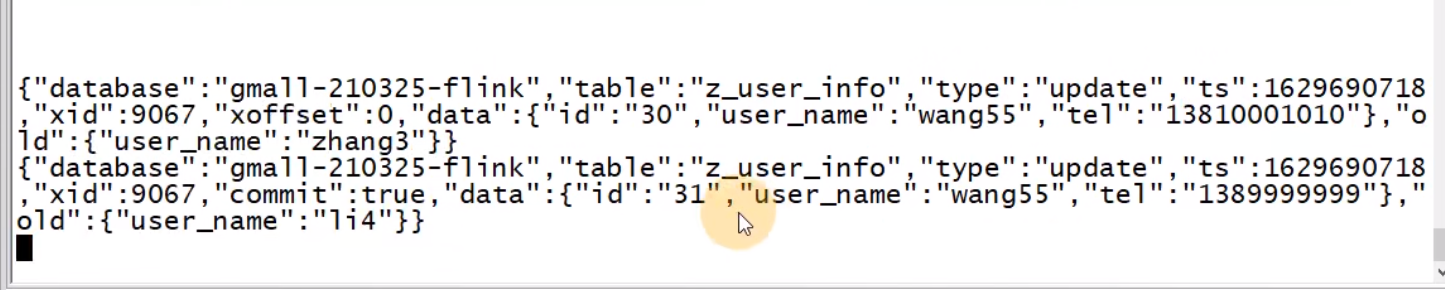
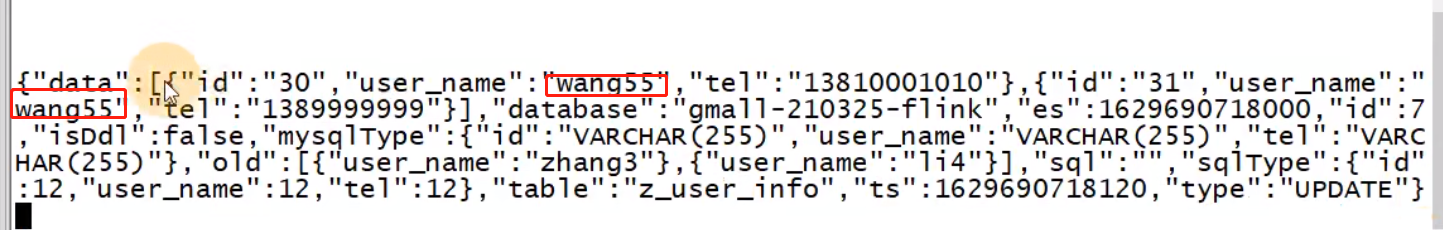
UPDATE z_user_info SET user_name='wang5' WHERE id IN(30,31)
FlinkCDC 包括了修改前的 before 数据

Maxwell 不包括修改前的数据
Canal 仍然是一条json
删除对比
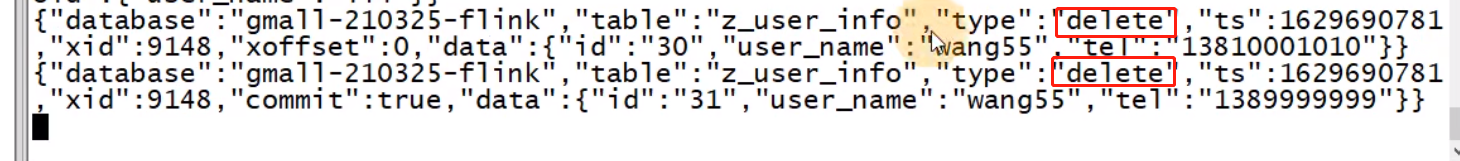
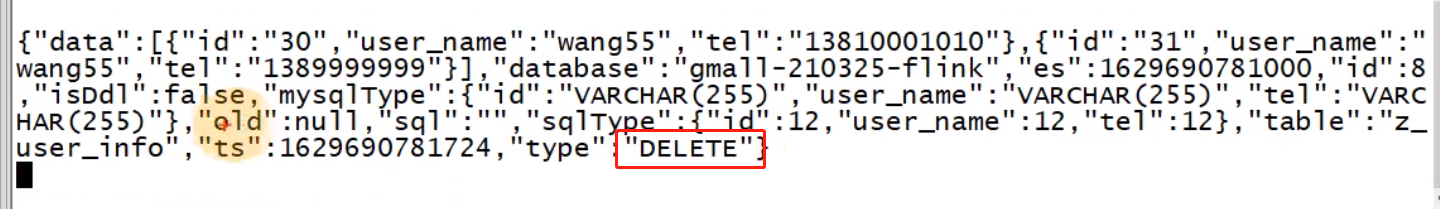
DELETE FROM z_user_info WHERE id IN(30,31)
FlinkCDC 两条删除的 json 数据

Maxwell
Canal
大数据-业务数据采集-FlinkCDC的更多相关文章
- GooseFS助力大数据业务数倍提升计算能力
前言 GooseFS是由腾讯云推出的一款分布式缓存方案,主要针对包括需要缓存加速的数据湖业务场景,提供基于对象存储COS服务的近计算端数据加速层. GooseFS 基于开源大数据缓存方案 Alluxi ...
- Spark大型项目实战:电商用户行为分析大数据平台
本项目主要讲解了一套应用于互联网电商企业中,使用Java.Spark等技术开发的大数据统计分析平台,对电商网站的各种用户行为(访问行为.页面跳转行为.购物行为.广告点击行为等)进行复杂的分析.用统计分 ...
- Flume 在有赞大数据的实践
https://mp.weixin.qq.com/s/gd0KMAt7z0WbrJL0RkMEtA 原创: 有赞技术 有赞coder 今天 文 | hujiahua on 大数据 一.前言 Flume ...
- 大数据技术体系 && NoSQL数据库的基本原理
1.NoSQL产生的原因 目前关系型数据库难以应对日益增多的海量数据,横向的分布式扩展能力比较弱,因此构建出非关系型数据库(所谓的NoSQL),其目的是为了构建一种结构简单.分布式.易扩展.效率高且使 ...
- 分析 BAT 互联网巨头在大数据方向布局及大数据未来发展趋势
> 风起云涌的大数据战场上,早已迎百花齐放繁荣盛景,各大企业加速跑向"大数据时代".而我们作为大数据的践行者,在这个"多智时代"如何才能跟上大数据的潮流, ...
- Hadoop! | 大数据百科 | 数据观 | 中国大数据产业观察_大数据门户
你正在使用过时的浏览器,Amaze UI 暂不支持. 请 升级浏览器 以获得更好的体验! 深度好文丨读完此文,就知道Hadoop了! 来源:BiThink 时间:2016-04-12 15:1 ...
- 《大数据Spark企业级实战 》
基本信息 作者: Spark亚太研究院 王家林 丛书名:决胜大数据时代Spark全系列书籍 出版社:电子工业出版社 ISBN:9787121247446 上架时间:2015-1-6 出版日期:20 ...
- 大数据和BI商业智能有何区别?有何相关?
大数据 ≠BI商业智能,大数据也不是传统商业智能的简单升级. 1.大数据和BI两者的区别 BI(BusinessIntelligence)即商业智能,它是企业数据化管理的一整套的方案,用来将企业中现有 ...
- [大数据面试题]hadoop核心知识点
* 面试答案为LZ所写,如需转载请注明出处,谢谢. * 这里不涉及HiveSQL和HBase操作的笔试题,这些东西另有总结. 1.MR意义. MR是一个用于处理大数据的分布式离线计算框架,它采用”分而 ...
- 为什么说LAXCUS颠覆了我的大数据使用体验
切入正题前,先做个自我介绍. 本人是从业三年的大数据小码农一枚,在帝都一家有点名气的广告公司工作,同时兼着大数据管理员的职责. 平时主要的工作是配合业务部门,做各种广告大数据计算分析工作,然后制成各种 ...
随机推荐
- 7.nexus版本升级
nexus-3.14.0升级到3.15.2 首先来看下原来的服务目录: nexus-3.14.0-04 sonatype-work 注意:nexus-3.14.0-04是应用程序包,sonatype- ...
- 分布式存储系统之Ceph基础
Ceph基础概述 Ceph是一个对象式存储系统,所谓对象式存储是指它把每一个待管理的数据流(比如一个文件)切分成一到多个固定大小的对象数据,并以其为原子单元完成数据的存取:对象数据的底层存储服务由多个 ...
- acwing349 黑暗城堡 (最短路径生成树)
求出最短树,用乘法原理统计答案就行了(模拟prim过程). 不知道说什么了,直接上代码: 1 #include<cstring> 2 #include<iostream> 3 ...
- Pytest进阶使用
fixture 特点: 命令灵活:对于setup,teardown可以省略 数据共享:在conftest.py配置里写方法可以实现数据共享,不需要import导入,可以跨文件共享 scope的层次及神 ...
- 【C++】GoogleTest进阶之gMock
gMock是什么 当我们去写测试时,有些测试对象很单纯简单,例如一个函数完全不依赖于其他的对象,那么就只需要验证其输入输出是否符合预期即可. 但是如果测试对象很复杂或者依赖于其他的对象呢?例如一个函数 ...
- 网络工程知识(二)VLAN的基础和配置:802.1q帧;Access、Trunk、Hybrid接口工作模式过程与配置;VLANIF的小实验
介绍-VLAN VLAN(Virtual Local Area Network)即虚拟局域网,工作在数据链路层. 交换机将通过:接口.MAC.基于子网.协议划分(IPv4和IPv6).基于策略的方式划 ...
- golang中的errgroup
0.1.索引 https://waterflow.link/articles/1665239900004 1.串行执行 假如我们需要查询一个课件列表,其中有课件的信息,还有课件创建者的信息,和课件的缩 ...
- JavaScript进阶(Learning Records)
背景:对JavaScript的深入学习 参考:<JavaScript高级程序设计><冴羽 JavaScript 深入> 从原型到原型链 prototype prototype是 ...
- Codeforces Round #826 (Div. 3) A-E
比赛链接 A 题解 知识点:模拟. 时间复杂度 \(O(n)\) 空间复杂度 \(O(n)\) 代码 #include <bits/stdc++.h> #define ll long lo ...
- python uiautomator
电脑连接上一个手机或多个手机, 确保adb已经添加到环境变量中,执行下面的命令会自动安装本库所需要的设备端程序:uiautomator-server .atx-agent.openstf/minica ...