
Hive学习之路 (二十)Hive 执行过程实例分析
一、Hive 执行过程概述
1、概述
(1) Hive 将 HQL 转换成一组操作符(Operator),比如 GroupByOperator, JoinOperator 等
(2)操作符 Operator 是 Hive 的最小处理单元
(3)每个操作符代表一个 HDFS 操作或者 MapReduce 作业
(4)Hive 通过 ExecMapper 和 ExecReducer 执行 MapReduce 程序,执行模式有本地模式和分 布式两种模式
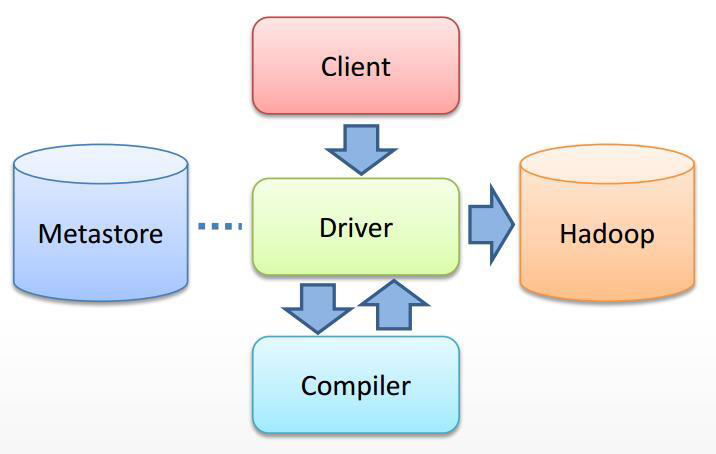
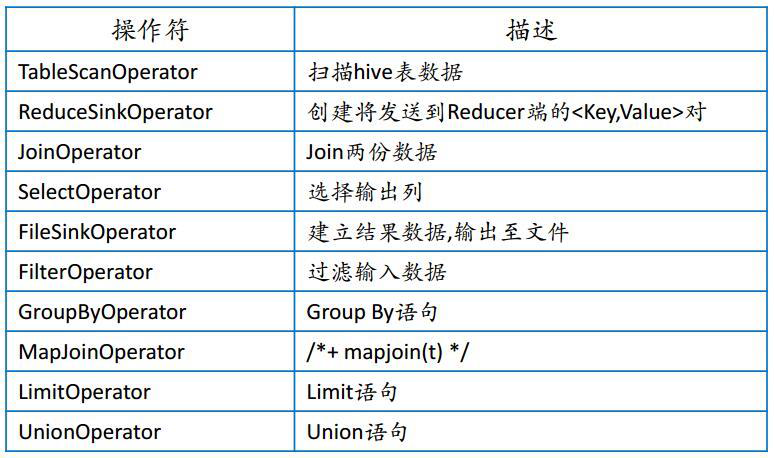
2、Hive 操作符列表
3、Hive 编译器的工作职责
(1)Parser:将 HQL 语句转换成抽象语法树(AST:Abstract Syntax Tree)
(2)Semantic Analyzer:将抽象语法树转换成查询块
(3)Logic Plan Generator:将查询块转换成逻辑查询计划
(4)Logic Optimizer:重写逻辑查询计划,优化逻辑执行计划
(5)Physical Plan Gernerator:将逻辑计划转化成物理计划(MapReduce Jobs)
(6)Physical Optimizer:选择最佳的 Join 策略,优化物理执行计划
4、优化器类型
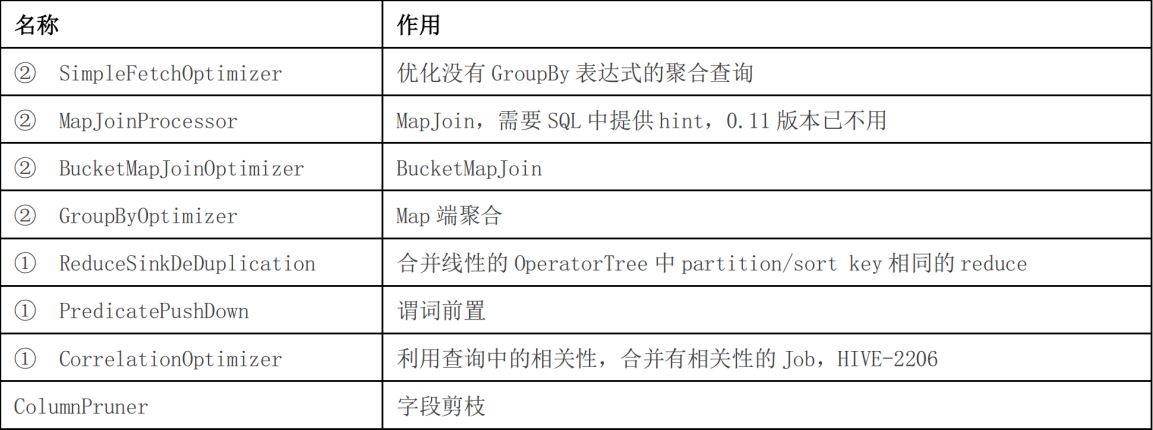
上表中带①符号的,优化目的都是尽量将任务合并到一个 Job 中,以减少 Job 数量,带②的 优化目的是尽量减少 shuffle 数据量
二、join
1、对于 join 操作
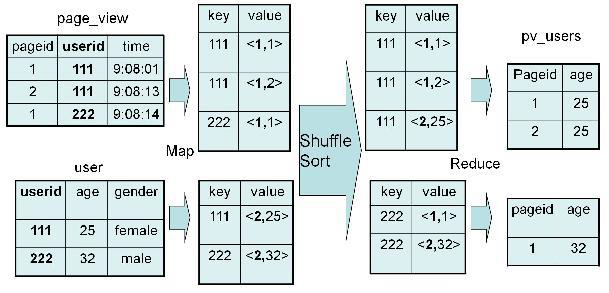
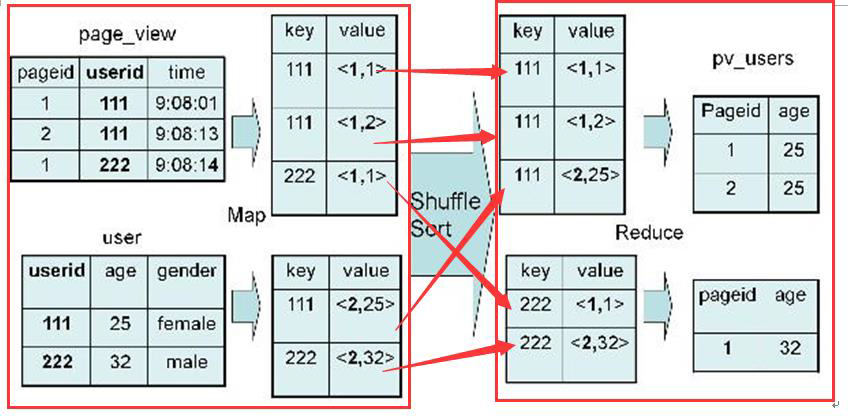
SELECT pv.pageid, u.age FROM page_view pv JOIN user u ON pv.userid = u.userid;
2、实现过程
Map:
1、以 JOIN ON 条件中的列作为 Key,如果有多个列,则 Key 是这些列的组合
2、以 JOIN 之后所关心的列作为 Value,当有多个列时,Value 是这些列的组合。在 Value 中还会包含表的 Tag 信息,用于标明此 Value 对应于哪个表
3、按照 Key 进行排序
Shuffle:
1、根据 Key 的值进行 Hash,并将 Key/Value 对按照 Hash 值推至不同对 Reduce 中
Reduce:
1、 Reducer 根据 Key 值进行 Join 操作,并且通过 Tag 来识别不同的表中的数据
3、具体实现过程
三、Group By
1、对于 group by操作
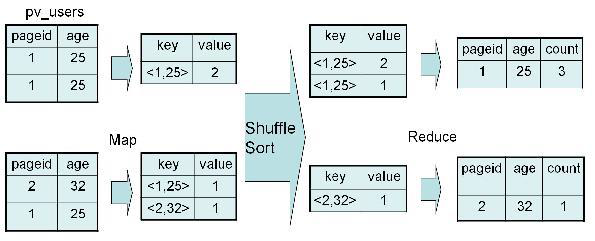
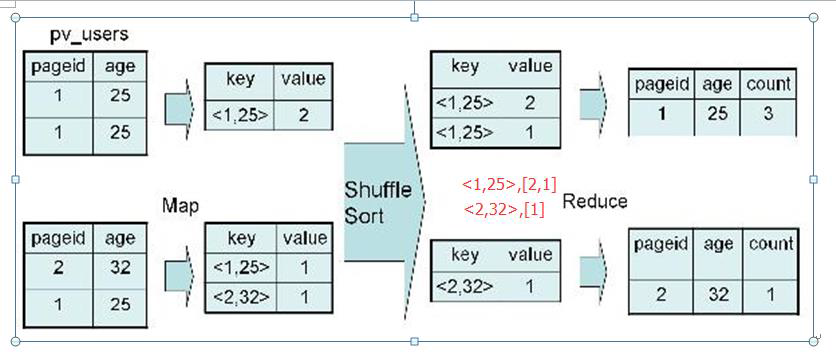
SELECT pageid, age, count(1) FROM pv_users GROUP BY pageid, age;
2、实现过程
四、Distinct
1、对于 distinct的操作
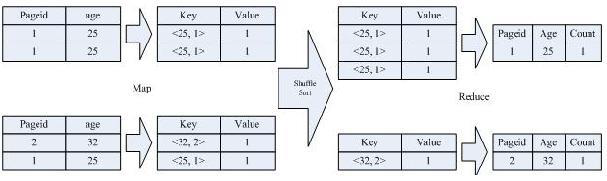
按照 age 分组,然后统计每个分组里面的不重复的 pageid 有多少个
SELECT age, count(distinct pageid) FROM pv_users GROUP BY age;
2、实现过程
3、详细过程解释
该 SQL 语句会按照 age 和 pageid 预先分组,进行 distinct 操作。然后会再按 照 age 进行分组,再进行一次 distinct 操作
Hive学习之路 (二十)Hive 执行过程实例分析的更多相关文章
- Hive(六)hive执行过程实例分析与hive优化策略
一.Hive 执行过程实例分析 1.join 对于 join 操作:SELECT pv.pageid, u.age FROM page_view pv JOIN user u ON (pv.useri ...
- Hive学习之路 (十八)Hive的Shell操作
一.Hive的命令行 1.Hive支持的一些命令 Command Description quit Use quit or exit to leave the interactive shell. s ...
- Hive(九)Hive 执行过程实例分析
一.Hive 执行过程概述 1.概述 (1) Hive 将 HQL 转换成一组操作符(Operator),比如 GroupByOperator, JoinOperator 等 (2)操作符 Opera ...
- Hadoop MapReduce执行过程实例分析
1.MapReduce是如何执行任务的?2.Mapper任务是怎样的一个过程?3.Reduce是如何执行任务的?4.键值对是如何编号的?5.实例,如何计算没见最高气温? 分析MapReduce执行过程 ...
- Hive学习之路 (十二)Hive SQL练习之影评案例
案例说明 现有如此三份数据:1.users.dat 数据格式为: 2::M::56::16::70072, 共有6040条数据对应字段为:UserID BigInt, Gender String, A ...
- Hive学习之路 (十四)Hive分析窗口函数(二) NTILE,ROW_NUMBER,RANK,DENSE_RANK
概述 本文中介绍前几个序列函数,NTILE,ROW_NUMBER,RANK,DENSE_RANK,下面会一一解释各自的用途. 注意: 序列函数不支持WINDOW子句.(ROWS BETWEEN) 数据 ...
- Hive学习之路 (十)Hive的高级操作
一.负责数据类型 1.array 现有数据如下: 1 huangbo guangzhou,xianggang,shenzhen a1:30,a2:20,a3:100 beijing,112233,13 ...
- Hive学习之路 (十九)Hive的数据倾斜
1.什么是数据倾斜? 由于数据分布不均匀,造成数据大量的集中到一点,造成数据热点 2.Hadoop 框架的特性 A.不怕数据大,怕数据倾斜 B.Jobs 数比较多的作业运行效率相对比较低,如子查询比较 ...
- Hive学习之路 (十六)Hive分析窗口函数(四) LAG、LEAD、FIRST_VALUE和LAST_VALUE
数据准备 数据格式 cookie4.txt cookie1, ::,url2 cookie1, ::,url1 cookie1, ::,1url3 cookie1, ::,url6 cookie1, ...
随机推荐
- 招新系统(jsp+servlet,实现简略前端网页注册登录+后台增删改查,分学生和管理员,Java语言,mysql数据库连接,tomcat服务器)
生活不只是眼前的苟且,还有诗和远方. 架构说明: 要求是采用MVC模式,所以分了下面的几个包,但是由于是第一次写,可能分的也不是很清楚: 这个是后台部分的架构: 这个是前端的的展示: (那个StuLo ...
- 撩课-Web大前端每天5道面试题-Day22
1.mvvm和mvc区别?它和其它框架(jquery)的区别是什么?哪些场景适合? mvc和mvvm其实区别并不大. 都是一种设计思想. 主要就是mvc中Controller演变成mvvm中的view ...
- UNIX 系统调用:dup,dup2实现重定向
重定向一般在命令行里就是把原本输出到屏幕的数据转而输出到一个指定的文件当中.如 $ pwd > workdir.txt 此时workdir.txt内就存储了pwd命令的输出,当前所在的工作目录 ...
- 算警示吧——此文来自张鑫旭(说说CSS学习中的瓶颈)
by zhangxinxu from http://www.zhangxinxu.com本文地址:http://www.zhangxinxu.com/wordpress/?p=2523 虽已数年,但未 ...
- 自定义TableViewCell 的方式实现自定义TableView(带源码)
转载于:http://www.cnblogs.com/macroxu-1982/archive/2012/08/30/2664121.html 实现的效果 实现过程 Step One 创建 自定义Ta ...
- css points
<style type="text/css" rel="stylesheet">.a{ width:500px; height:400px;对放置图 ...
- 百度 echarts K线图使用
看个效果图先 首先在需要插入图例的HTML中嵌入 <div id="main" style="height:400px"></div> ...
- Modernizing Business Process with Cloud and AI
The world is awash with digital transformation. Every customer and partner that I talk to, across ev ...
- CRM 安装过程 AD+SQL+CRM
AD: 通过服务器管理器添加域服务,配置域服务器域名为crm5.lab. 注意:使用高级模式安装. 说明:服务器是windows server 2003 那么就选windows server 2003 ...
- linux中文字体
◆ 背景说明 报表,在windows下,展现.导出都正常,在linux下,字体变大了.比如,单元格的大小设计好后,里面的字当好能一行显示完,将报表放到linux下后,字变大了,一行显示不完了,变 ...