
Storm集群部署及单词技术
1、 集群部署的基本流程
集群部署的流程:下载安装包、解压安装包、修改配置文件、分发安装包、启动集群
注意:
所有的集群上都需要配置hosts
vi /etc/hosts
192.168.239.128 storm01 zk01 hadoop01
192.168.239.129 storm02 zk02 hadoop02
192.168.239.130 storm03 zk03 hadoop03
1、 集群部署的基础环境准备
安装前的准备工作(zk集群已经部署完毕)
l 关闭防火墙
chkconfig iptables off && setenforce 0
l 创建用户
groupadd realtime && useradd realtime && usermod -a -G realtime realtime
l 创建工作目录并赋权
mkdir /export
mkdir /export/servers
chmod 755 -R /export
l 切换到realtime用户下
su realtime
3、Storm集群部署
3.1、下载安装包
3.2、解压安装包
tar -zxvf apache-storm-0.9.5.tar.gz -C /export/servers/
cd /export/servers/
ln -s apache-storm-0.9.5 storm
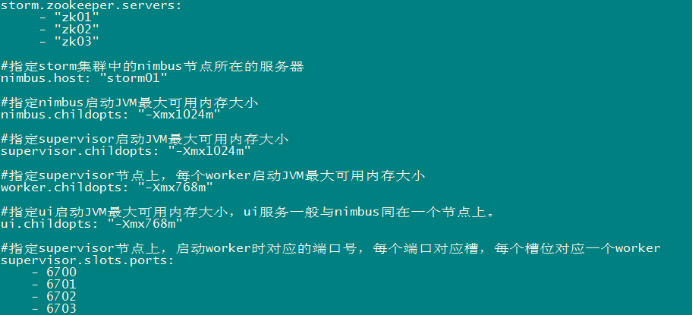
3.3、修改配置文件
mv /export/servers/storm/conf/storm.yaml /export/servers/storm/conf/storm.yaml.bak
vi /export/servers/storm/conf/storm.yaml
输入以下内容:
3.4、分发安装包
scp -r /export/servers/apache-storm-0.9.5 storm02:/export/servers
然后分别在各机器上创建软连接
cd /export/servers/
ln -s apache-storm-0.9.5 storm
3.5、启动集群
l 在nimbus.host所属的机器上启动 nimbus服务
cd /export/servers/storm/bin/
nohup ./storm nimbus &
l 在nimbus.host所属的机器上启动ui服务
cd /export/servers/storm/bin/
nohup ./storm ui &
l 在其它个点击上启动supervisor服务
cd /export/servers/storm/bin/
nohup ./storm supervisor &
3.6、查看集群
访问nimbus.host:/8080,即可看到storm的ui界面。

4、Storm常用操作命令
有许多简单且有用的命令可以用来管理拓扑,它们可以提交、杀死、禁用、再平衡拓扑。
l 提交任务命令格式:storm jar 【jar路径】 【拓扑包名.拓扑类名】 【拓扑名称】
bin/storm jar examples/storm-starter/storm-starter-topologies-0.9.6.jar storm.starter.WordCountTopology wordcount
l 杀死任务命令格式:storm kill 【拓扑名称】 -w 10(执行kill命令时可以通过-w [等待秒数]指定拓扑停用以后的等待时间)
storm kill topology-name -w 10
l 停用任务命令格式:storm deactivte 【拓扑名称】
storm deactivte topology-name
我们能够挂起或停用运行中的拓扑。当停用拓扑时,所有已分发的元组都会得到处理,但是spouts的nextTuple方法不会被调用。销毁一个拓扑,可以使用kill命令。它会以一种安全的方式销毁一个拓扑,首先停用拓扑,在等待拓扑消息的时间段内允许拓扑完成当前的数据流。
l 启用任务命令格式:storm activate【拓扑名称】
storm activate topology-name
l 重新部署任务命令格式:storm rebalance 【拓扑名称】
storm rebalance topology-name
再平衡使你重分配集群任务。这是个很强大的命令。比如,你向一个运行中的集群增加了节点。再平衡命令将会停用拓扑,然后在相应超时时间之后重分配工人,并重启拓扑。
5、Storm集群的进程及日志熟悉
5.1、部署成功之后,启动storm集群。
依次启动集群的各种角色
5.2、查看nimbus的日志信息
在nimbus的服务器上
cd /export/servers/storm/logs
tail -100f /export/servers/storm/logs/nimbus.log
5.3、查看ui运行日志信息
在ui的服务器上,一般和nimbus一个服务器
cd /export/servers/storm/logs
tail -100f /export/servers/storm/logs/ui.log
5.4、查看supervisor运行日志信息
在supervisor服务上
cd /export/servers/storm/logs
tail -100f /export/servers/storm/logs/supervisor.log
5.5、查看supervisor上worker运行日志信息
在supervisor服务上
cd /export/servers/storm/logs
tail -100f /export/servers/storm/logs/worker-6702.log
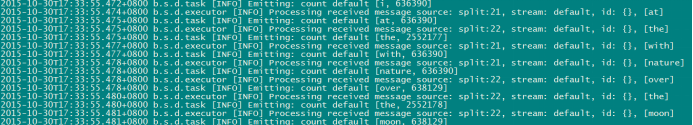 (该worker正在运行wordcount程序)
6、Storm源码下载及目录熟悉
6.1、在Storm官方网站上寻找源码地址
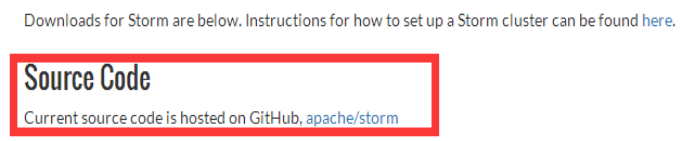
6.2、点击文字标签进入github
点击Apache/storm文字标签,进入github
https://github.com/apache/storm
6.3、拷贝storm源码地址
在网页右侧,拷贝storm源码地址

6.4、使用Subversion客户端下载
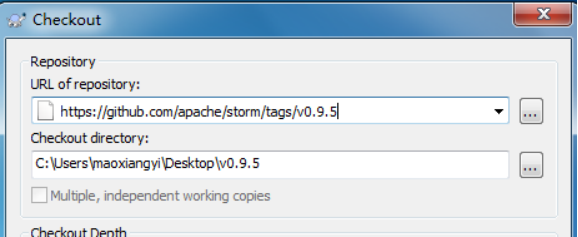
6.5、Storm源码目录分析(重要)
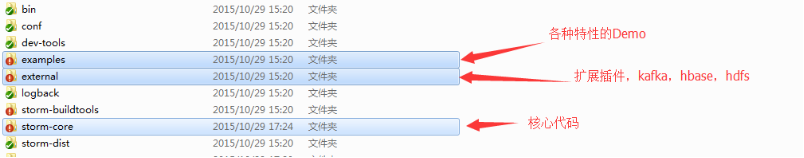
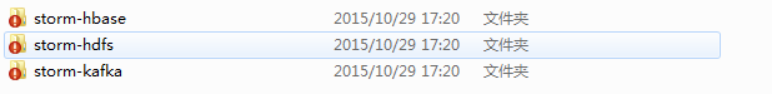
扩展包中的三个项目,使storm能与hbase、hdfs、kafka交互
7、Storm单词技术案例(重点掌握)
7.1、功能说明
设计一个topology,来实现对文档里面的单词出现的频率进行统计。
整个topology分为三个部分:
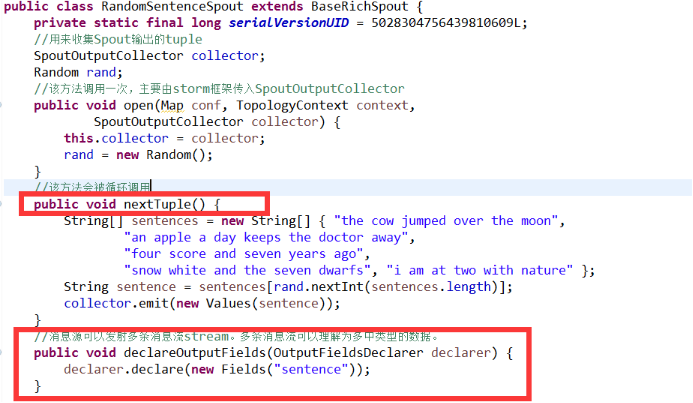
l RandomSentenceSpout:数据源,在已知的英文句子中,随机发送一条句子出去。
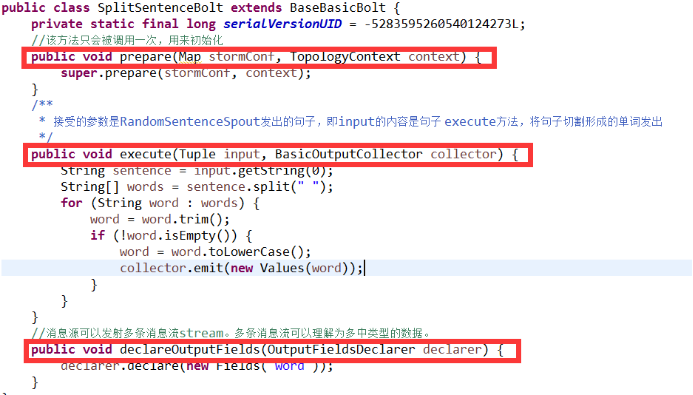
l SplitSentenceBolt:负责将单行文本记录(句子)切分成单词
l WordCountBolt:负责对单词的频率进行累加
7.2、项目主要流程

7.3、RandomSentenceSpout的实现及生命周期
7.4、SplitSentenceBolt的实现及生命周期
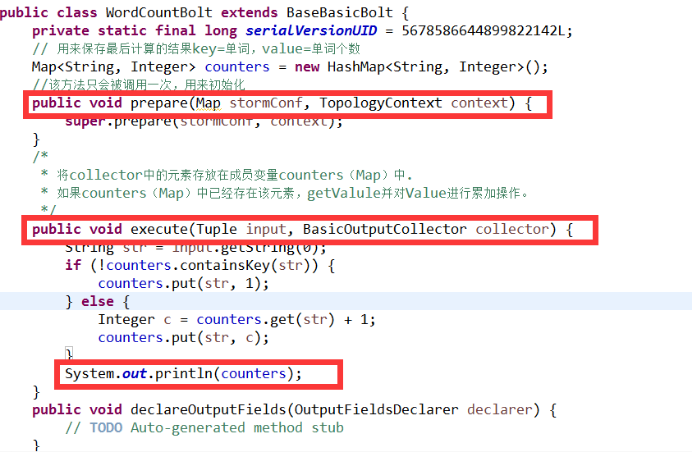
7.5、WordCountBolt的实现及生命周期
7.6、Stream Grouping详解
Storm里面有7种类型的stream grouping
l Shuffle Grouping: 随机分组, 随机派发stream里面的tuple,保证每个bolt接收到的tuple数目大致相同。
l Fields Grouping:按字段分组,比如按userid来分组,具有同样userid的tuple会被分到相同的Bolts里的一个task,而不同的userid则会被分配到不同的bolts里的task。
l All Grouping:广播发送,对于每一个tuple,所有的bolts都会收到。
l Global Grouping:全局分组, 这个tuple被分配到storm中的一个bolt的其中一个task。再具体一点就是分配给id值最低的那个task。
l Non Grouping:不分组,这stream grouping个分组的意思是说stream不关心到底谁会收到它的tuple。目前这种分组和Shuffle grouping是一样的效果, 有一点不同的是storm会把这个bolt放到这个bolt的订阅者同一个线程里面去执行。
l Direct Grouping: 直接分组, 这是一种比较特别的分组方法,用这种分组意味着消息的发送者指定由消息接收者的哪个task处理这个消息。只有被声明为Direct Stream的消息流可以声明这种分组方法。而且这种消息tuple必须使用emitDirect方法来发射。消息处理者可以通过TopologyContext来获取处理它的消息的task的id (OutputCollector.emit方法也会返回task的id)。
l Local or shuffle grouping:如果目标bolt有一个或者多个task在同一个工作进程中,tuple将会被随机发生给这些tasks。否则,和普通的Shuffle Grouping行为一致。
Storm集群部署及单词技术的更多相关文章
- 2.Storm集群部署及单词统计案例
1.集群部署的基本流程 2.集群部署的基础环境准备 3.Storm集群部署 4.Storm集群的进程及日志熟悉 5.Storm集群的常用操作命令 6.Storm源码下载及目录熟悉 7.Storm 单词 ...
- Storm 系列(三)Storm 集群部署和配置
Storm 系列(二)Storm 集群部署和配置 本章中主要介绍了 Storm 的部署过程以及相关的配置信息.通过本章内容,帮助读者从零开始搭建一个 Storm 集群. 一.Storm 的依赖组件 1 ...
- storm集群部署和配置过程详解
先整体介绍一下搭建storm集群的步骤: 设置zookeeper集群 安装依赖到所有nimbus和worker节点 下载并解压storm发布版本到所有nimbus和worker节点 配置storm ...
- Storm集群部署
一. 说明 Storm是一个分布式实时计算系统,Storm对于实时计算的意义就相当于Hadoop对于批量计算的意义.对于实时性较高的系统Storm是不错的选择.Hadoop提供了map, reduce ...
- Storm1.0.3集群部署
Storm集群部署 所有集群部署的基本流程都差不多:下载安装包并上传.解压安装包并配置环境变量.修改配置文件.分发安装包.启动集群.查看集群是否部署成功. 1.所有的集群上都要配置hosts vi ...
- 02_Storm集群部署
1. 部署前的硬件及软件检查 硬件要求 1)storm集群部署包括zookeeper部署,而zookeeper集群最小为3台机器2)storm的计算过程都在内存中完成,因此内存要尽量大3)storm少 ...
- Storm集群安装部署步骤【详细版】
作者: 大圆那些事 | 文章可以转载,请以超链接形式标明文章原始出处和作者信息 网址: http://www.cnblogs.com/panfeng412/archive/2012/11/30/how ...
- Storm入门教程 第三章Storm集群安装部署步骤、storm开发环境
一. Storm集群组件 Storm集群中包含两类节点:主控节点(Master Node)和工作节点(Work Node).其分别对应的角色如下: 主控节点(Master Node)上运行一个被称为N ...
- Storm集群安装部署步骤
本文以Twitter Storm官方Wiki为基础,详细描述如何快速搭建一个Storm集群,其中,项目实践中遇到的问题及经验总结,在相应章节以"注意事项"的形式给出. 1. Sto ...
随机推荐
- mongodb分片介绍—— 基于范围(数值型)的分片 或者 基于哈希的分片
数据分区 MongoDB中数据的分片是以集合为基本单位的,集合中的数据通过 片键 被分成多部分. 片键 对集合进行分片时,你需要选择一个 片键 , shard key 是每条记录都必须包含的,且建立了 ...
- opencv:基本图形绘制
可以使用opencv绘制 直线.圆.方形.椭圆等基本图形. 示例代码: #include <opencv.hpp> using namespace cv; int main() { // ...
- hibernate 延迟加载和抓取策略
一.延迟加载 1.简单查询get,load 针对对象本身延迟或即时 当使用load方法来得到一个对象时,此时hibernate会使用延迟加载的机制来加载这个对象,即:当我们使用session.load ...
- 条款16:成对使用new以及delete的时候应该采取相同的形式
首先思考下面的代码: ]; ... delete stringArray; 这是最常见的错误之一了,new与delete不配对,但是仔细想想new与delete为什么一定要配对呢? 可以想到一种可能就 ...
- 《锋利的jQuery》读书笔记(动画)
1.show()和hide() 实质就是改变当前DOM对象的display为block.none或inline-block(取决于之前的display),如下: $("element&quo ...
- CSS3盒模型display:box简述
display:box;box-flex是css3新添加的盒子模型属性,它的出现可以解决我们通过N多结构.css实现的布局方式.经典的一个布局应用就是布局的垂直等高.水平均分.按比例划分. box-f ...
- Django cookie与session
cookie与session关系 cookie 是保存在客户端浏览器的键值对,浏览器发送请求时候会自动携带. session 1.生成随机字符串 2.回给浏览器,让它写到cookie # {" ...
- 我所常用的git命令
说明公司向用git来管理项目的代码,我以前只是在eclipse中使用菜单来操作git,现在,学习一下命令,这样也不用安装各种git客户端软件了.git安装在官网上下载git,安装完成之后,在命令行中输 ...
- SQLite3的运用
1.导入库文件:libsqlite3. 2..m文件的代码: // // ViewController.m // SQLite3的运用 // // Created by PengYunjing on ...
- Spring IOC容器的初始化-(三)BeanDefinition的注册
---恢复内容开始--- 前言 在上一篇中有一处代码是BeanDefiniton注册的入口,我们回顾一下. 1.BeanDefiniton在IOC容器注册 首先我们回顾两点,1. 发起注册的地方:2. ...