
【转】Python——读取html的table内容
Python——python读取html实战,作业7(python programming)

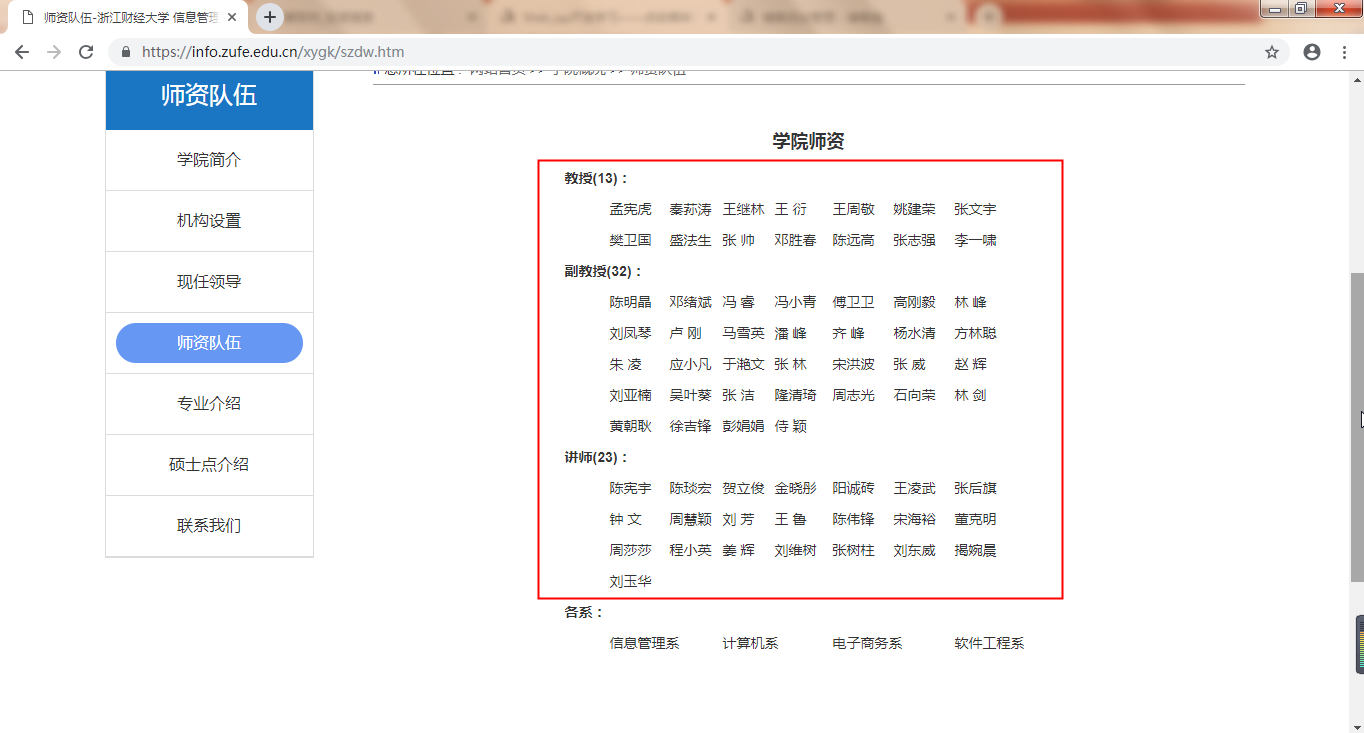
查看源码,观察html结构


# -*- coding: utf-8 -*-

from lxml.html import parse

from urllib.request import urlopen

import pandas as pd

# 可能爬的这个网页比较特殊,需要写下面两句话

import ssl

ssl._create_default_https_context = ssl._create_unverified_context

# 根据链接获得整个html放到doc中

parsed = parse(urlopen('https://info.zufe.edu.cn/xygk/szdw.htm'))

doc = parsed.getroot()

#读取html中的table

# 用列表来存老师名字

all_teachers=[]

# 用字典保存主页链接

link_dic={}

# 用字典保存职称

zhicheng={}

# 找到html中有<table></table>的所有table,以列表的形式返回给tables

tables = doc.findall('.//table')

# 我们要的是第一个table

content=tables[0].text_content()

tds = tables[0].findall('.//td')

# 一条条遍历所有td里的内容

for td in tds:

    # 判断当前属于哪个职称,再给zc赋值

    zhi=td.findall('.//strong')

    if len(zhi)!=0:

        print(zhi[0].text_content())

        zc=zhi[0].text_content()

    print(td.text_content())

    link=td.findall('.//a')

    if len(link)!=0:

        print("link",link[0].get('href'))

        # td.text_content()存的就是姓名

        # 保存链接

        link_dic[td.text_content()]=link[0].get('href')

        # 保存老师姓名

        all_teachers.append(str(td.text_content()))

        # 保存职称

        zhicheng[td.text_content()]=zc

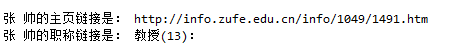
print("张 帅的主页链接是:",link_dic["张 帅"])

print("张 帅的职称链接是:",zhicheng["张 帅"])

# 后面的各系不属于老师去掉

all_teachers=all_teachers[:68]

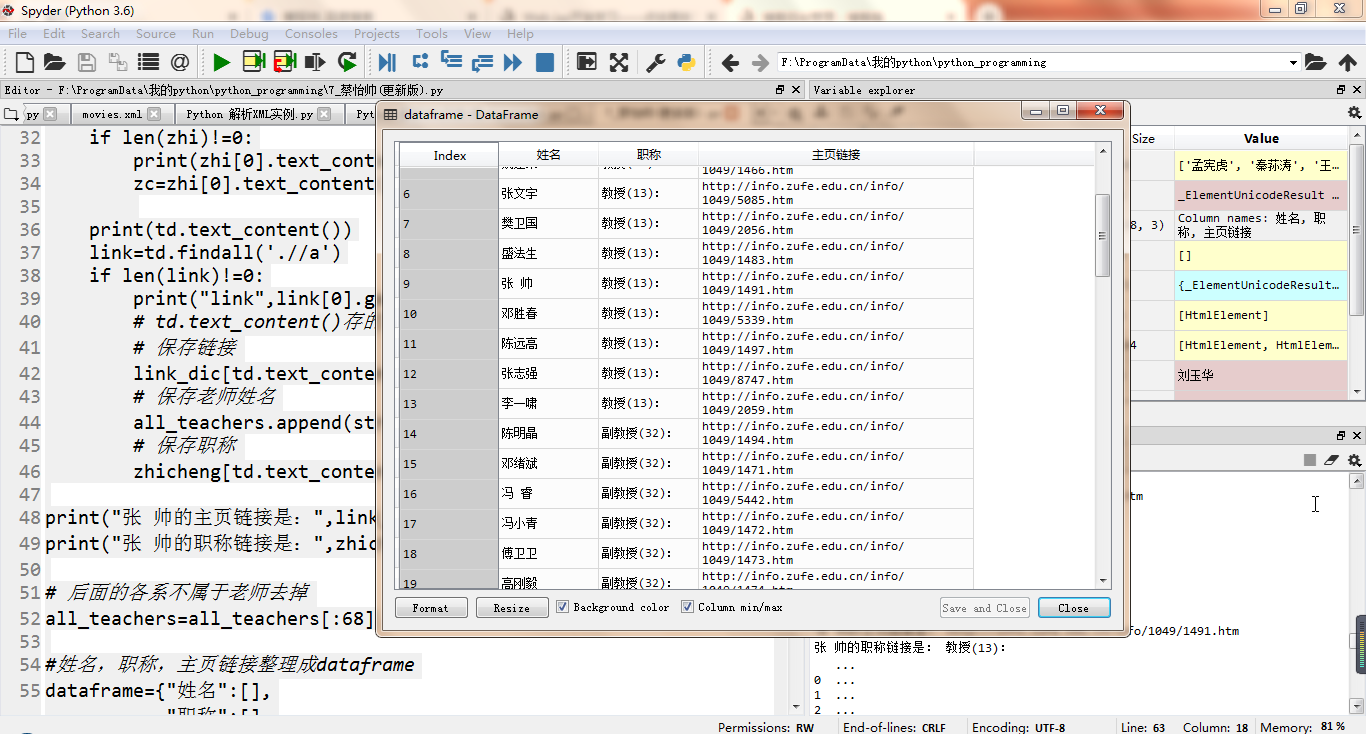
#姓名,职称,主页链接整理成dataframe

dataframe={"姓名":[],

           "职称":[],

           "主页链接":[]}

for teacher in all_teachers:

    dataframe["姓名"].append(teacher)

    dataframe["职称"].append(zhicheng[teacher])

    dataframe["主页链接"].append(link_dic[teacher])

dataframe=pd.DataFrame(dataframe)

print(dataframe)
【转】Python——读取html的table内容的更多相关文章
- Python读取文件编码及内容
Python读取文件编码及内容 最近做一个项目,需要读取文件内容,但是文件的编码方式有可能都不一样.有的使用GBK,有的使用UTF8.所以在不正确读取的时候会出现如下错误: UnicodeDecode ...
- python读取文件指定行内容
python读取文件指定行内容 import linecache text=linecache.getline(r'C:\Users\Administrator\Desktop\SourceCodeo ...
- Python读取word文档内容
1,利用python读取纯文字的word文档,读取段落和段落里的文字. 先读取段落,代码如下: 1 ''' 2 #利用python读取word文档,先读取段落 3 ''' 4 #导入所需库 5 fro ...
- python 读取指定div的内容
# -*- coding:utf-8 -*- from bs4 import BeautifulSoup import urllib.request import re # 如果是网址,可以用这个办法 ...
- Python读取本地文档内容并发送邮件
当需要将本地某个路径下的文档内容读取后并作为邮件正文发送的时候可以参考该文,使用到的模块包括smtplib,email. #! /usr/bin/env python3 # -*- coding:ut ...
- Python 读取文件下所有内容、获取文件名、截取字符、写回文件
# coding=gbk import os import os.path #读取目录下的所有文件,包括嵌套的文件夹 def GetFileList(dir, fileList): newDir ...
- python读取指定内存的内容
import ctypes as ct t = ct.string_at(0x211000, 20) # (addr, size) print t 最好不要用解释性语言来开发底层,一般用C.
- Python读取文件内容与存储
Python读取与存储文件内容 一..csv文件 读取: import pandas as pd souce_data = pd.read_csv(File_Path) 其中File_path是文件的 ...
- python读取excel中单元格的内容返回的5种类型
(1) 读取单个sheetname的内容. 此部分转自:https://www.cnblogs.com/xxiong1031/p/7069006.html python读取excel中单元格的内容返回 ...
随机推荐
- Navicat 连接VMware中Ubuntu 下的mysql5.7遇到的坑
1.用Navicat连接虚拟机下的mysql出现问题: 2003- Can't connect MySQL Server on '192.168.*.*'(10038). 解决方案: 方法:直接授权( ...
- npm link & unlink
npm link & unlink https://dev.to/erinbush/npm-linking-and-unlinking-2h1g
- BZOJ5507 GXOI/GZOI2019旧词 (树链剖分+线段树)
https://www.cnblogs.com/Gloid/p/9412357.html差分一下是一样的问题.感觉几年没写过树剖了. #include<iostream> #include ...
- VMware虚拟机里Centos7的IP地址查看方法
电脑的虚拟机里面安装了一个Cetos 7 ,想用Xshell链接进行操作,发现没有IP显示,需要IP地址,我才能进行连接,用命令ip addr查看下: 发现ens33 没有inet 这个属性,那么就没 ...
- Educational Codeforces Round 63 (Rated for Div. 2) B. Game with Telephone Numbers 博弈思维+模拟+贪心思维
题意:博弈题面 给出一个数字序列 (>=11) 有两个人任意删除数字 直到 数字只剩下11位 如果删除后的数字串开头是8那么就是第一个赢 否则就是第二个人赢 第一个人先手 数字序列一定是奇 ...
- crontab计划任务实例
使用实例 实例1:每1分钟执行一次command 命令: * * * * * command 实例2:每小时的第3和第15分钟执行 命令: 3,15 * * * * command 实例3:在上午8点 ...
- Python基础7:字符串方法
1 * 重复输出字符串 print('helo '*4) 2 [],[:] 通过索引获取字符串中的字符,这里和列表中的切片操作是相同的,具体内容见列表 print('hello word'[2:]) ...
- maven settings.xml--需要保存到用户/.m2文件夹下
<?xml version="1.0" encoding="UTF-8"?> <!-- Licensed to the Apache Soft ...
- python第九天
复习内容: 文件处理 1. 操作文件的三步骤: ---打开文件:硬盘的空间被操作系统持有 | 文件对象被应用程序持有 ---操作文件:读写操作 ---释放文件:释放操作系统对硬盘空间的持有 2. ...
- linux date -s
修改linux的时间可以使用date指令 修改日期: 时间设定成2009年5月10日的命令如下: #date -s 05/10/2009 修改时间: 将系统时间设定成上午10点18分0秒的命令如下. ...