
MapReduce 入门之一步步自实现词频统计功能
原创播客,如需转载请注明出处。原文地址:http://www.cnblogs.com/crawl/p/7687120.html
----------------------------------------------------------------------------------------------------------------------------------------------------------
笔记中提供了大量的代码示例,需要说明的是,大部分代码示例都是本人所敲代码并进行测试,不足之处,请大家指正~
本博客中所有言论仅代表博主本人观点,若有疑惑或者需要本系列分享中的资料工具,敬请联系 qingqing_crawl@163.com
-----------------------------------------------------------------------------------------------------------------------------------------------------------
前言:这一个月实在是抽不出空来写博客了,最近在为学校开发网上办事大厅,平时还要上课,做任务,很忙,压力也很大,终于在本月的最后一天抽出了点时间。其实,这一篇播客一直在我的草稿箱中,楼主本来想先仔细写一写 Hadoop 伪分布式的部署安装,然后介绍一些 HDFS 的内容再来介绍 MapReduce,是在是没有抽出空,今天就简单入门一下 MapReduce 吧。
一、MapReduce 概述
1.MapReduce 是一种分布式计算模型,由Google提出,主要用于搜索领域,解决海量数据的计算问题.
2.MapReduce 由两个阶段组成:Map和Reduce,用户只需要实现map()和reduce()两个函数,即可实现分布式计算
二、具体实现
1.先来看一下 Eclipse 中此应用的包结构
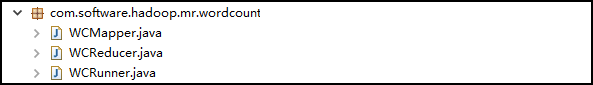
2.创建 map 的任务处理类:WCMapper
/*

 * 1.Mapper 类的四个泛型中,前两个指定 mapper 输入数据的类型,后两个指定 mapper 输出数据的类型

 *   KEYIN 是输入的 key 的类型,VALUEIN 是输入的 value 的类型

 *   KEYOUT 是输出的 key 的类型,VALUEOUT 是输出的 value 的类型

 * 2.map 和 reduce 的数据的输入输出都是以 key-value 对的形式封装的

 * 3.默认情况下,框架传递给我们的 mapper 的输入数据中,key 是要处理的文本中一行的起始偏移量,为 Long 类型,

 * 这一行的内容为 value,为 String 类型的

 * 4.后两个泛型的赋值需要我们结合实际情况

 * 5.为了在网络中传输时序列化更高效,Hadoop 把 Java 中的 Long 封装为 LongWritable, 把 String 封装为 Text

 */

public class WCMapper extends Mapper<LongWritable, Text, Text, LongWritable> {

    //重写 Mapper 中的 map 方法,MapReduce 框架每读一行数据就调用一次此方法

    @Override

    protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {

        //书写具体的业务逻辑,业务要处理的数据已经被框架传递进来,就是方法的参数中的 key 和 value

        //key 是这一行数据的起始偏移量,value 是这一行的文本内容

        //1.将 Text 类型的一行的内容转为 String 类型

        String line = value.toString();

        //2.使用 StringUtils 以空格切分字符串,返回 String[]

        String[] words = StringUtils.split(line, " ");

        //3.循环遍历 String[],调用 context 的 writer()方法,输出为 key-value 对的形式

        //key:单词   value:1

        for(String word : words) {

            context.write(new Text(word), new LongWritable(1));

        }

    }

}
2.创建 reduce 的任务处理类:WCReducer:
/*

 * 1.Reducer 类的四个泛型中,前两个输入要与 Mapper 的输出相对应。输出需要联系具体情况自定义

 */

public class WCReducer extends Reducer<Text, LongWritable, Text, LongWritable> {

    //框架在 map 处理完之后,将所有的 kv 对缓存起来,进行分组,然后传递一个分组(<key,{values}>,例如:<"hello",{1,1,1,1}>),

    //调用此方法

    @Override

    protected void reduce(Text key, Iterable<LongWritable> values, Context context)throws IOException, InterruptedException {

        //1.定义一个计数器

        long count = 0;

        //2.遍历 values的 list,进行累加求和

        for(LongWritable value : values) {

            //使用 LongWritable 的 get() 方法,可以将 一个 LongWritable 类型转为 Long 类型

            count += value.get();

        }

        //3.输出这一个单词的统计结果

        context.write(key, new LongWritable(count));

    }

}
3.创建一个类,用来描述一个特定的作业:WCRunner,(此类了楼主没有按照规范的模式写)
/**

 * 此类用来描述一个特定的作业

 * 例:1.该作业使用哪个类作为逻辑处理中的 map,哪个作为 reduce

 *       2.指定该作业要处理的数据所在的路径

 *       3.指定该作业输出的结果放到哪个路径

 */

public class WCRunner {

    public static void main(String[] args) throws Exception {

        //1.获取 Job 对象:使用 Job 静态的 getInstance() 方法,传入 Configuration 对象

        Configuration conf = new Configuration();

        Job wcJob = Job.getInstance(conf);

        //2.设置整个 Job 所用的类的 jar 包:使用 Job 的 setJarByClass(),一般传入  当前类.class

        wcJob.setJarByClass(WCRunner.class);

        //3.设置本 Job 使用的 mapper 和 reducer 的类

        wcJob.setMapperClass(WCMapper.class);

        wcJob.setReducerClass(WCReducer.class);

        //4.指定 reducer 输出数据的 kv 类型  注:若 mapper 和 reducer 的输出数据的 kv 类型一致,可以用如下两行代码设置

        wcJob.setOutputKeyClass(Text.class);

        wcJob.setOutputValueClass(LongWritable.class);

        //5.指定 mapper 输出数据的 kv 类型

        wcJob.setMapOutputKeyClass(Text.class);

        wcJob.setMapOutputValueClass(LongWritable.class);

        //6.指定原始的输入数据存放路径:使用 FileInputFormat 的 setInputPaths() 方法

        FileInputFormat.setInputPaths(wcJob, new Path("/wc/srcdata/"));

        //7.指定处理结果的存放路径:使用 FileOutputFormat 的 setOutputFormat() 方法

        FileOutputFormat.setOutputPath(wcJob, new Path("/wc/output/"));

        //8.将 Job 提交给集群运行,参数为 true 表示显示运行状态

        wcJob.waitForCompletion(true);

    }

}
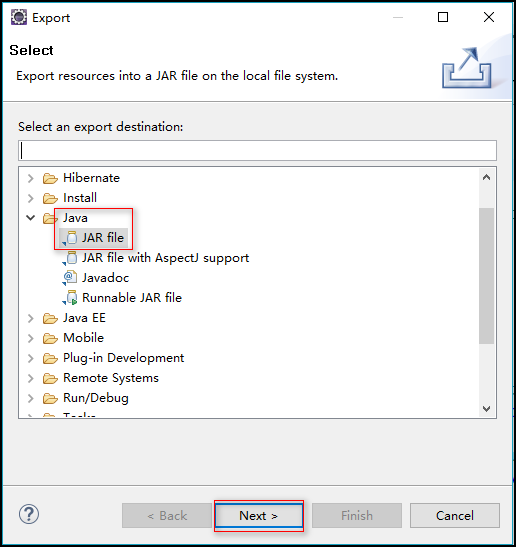
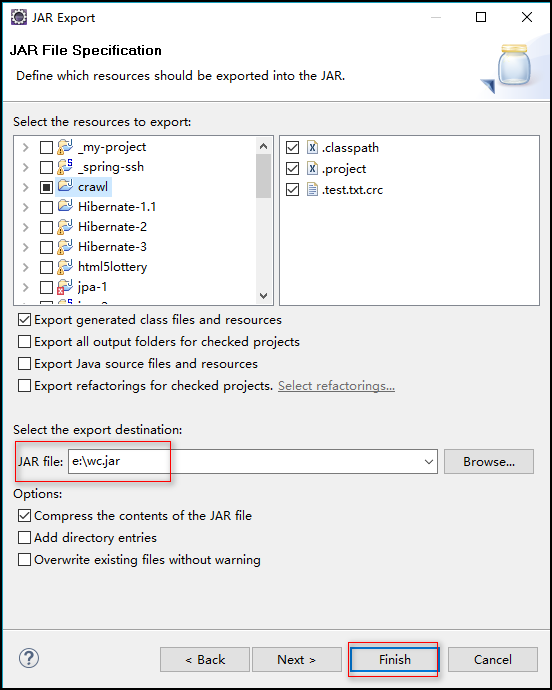
4.将此项目导出为 jar 文件
步骤:右击项目 ---> Export ---> Java ---> JAR file --->指定导出路径(我指定的为:e:\wc.jar) ---> Finish
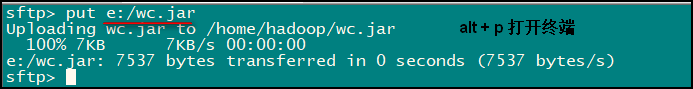
5.将导出的 jar 包上传到 linux 上
楼主使用的方法是:在 SecureCRT 客户端中使用 Alt + p 快捷键打开上传文件的终端,输入 put e"\wc.jar 即可上传
6.创建初始测试文件:words.log
命令: vi words.log 自己输入测试数据即可

7.在 hdfs 中创建存放初始测试文件 words.log 的目录:我们在 WCRunner 中指定的是 /wc/srcdata/
命令:
[hadoop@crawl ~]$ hadoop fs -mkdir /wc
[hadoop@crawl ~]$ hadoop fs -mkdir /wc/srcdata
8.将初始测试文件 words.log 上传到 hdfs 的相应目录
命令:[hadoop@crawl ~]$ hadoop fs -put words.log /wc/srcdata
9.运行 jar 文件
命令:hadoop jar wc.jar com.software.hadoop.mr.wordcount.WCRunner
此命令为 hadoop jar wc.jar 加上 WCRunner类的全类名,程序的入口为 WCRunner 内的 main 方法,运行完此命令便可以看到输出日志信息:
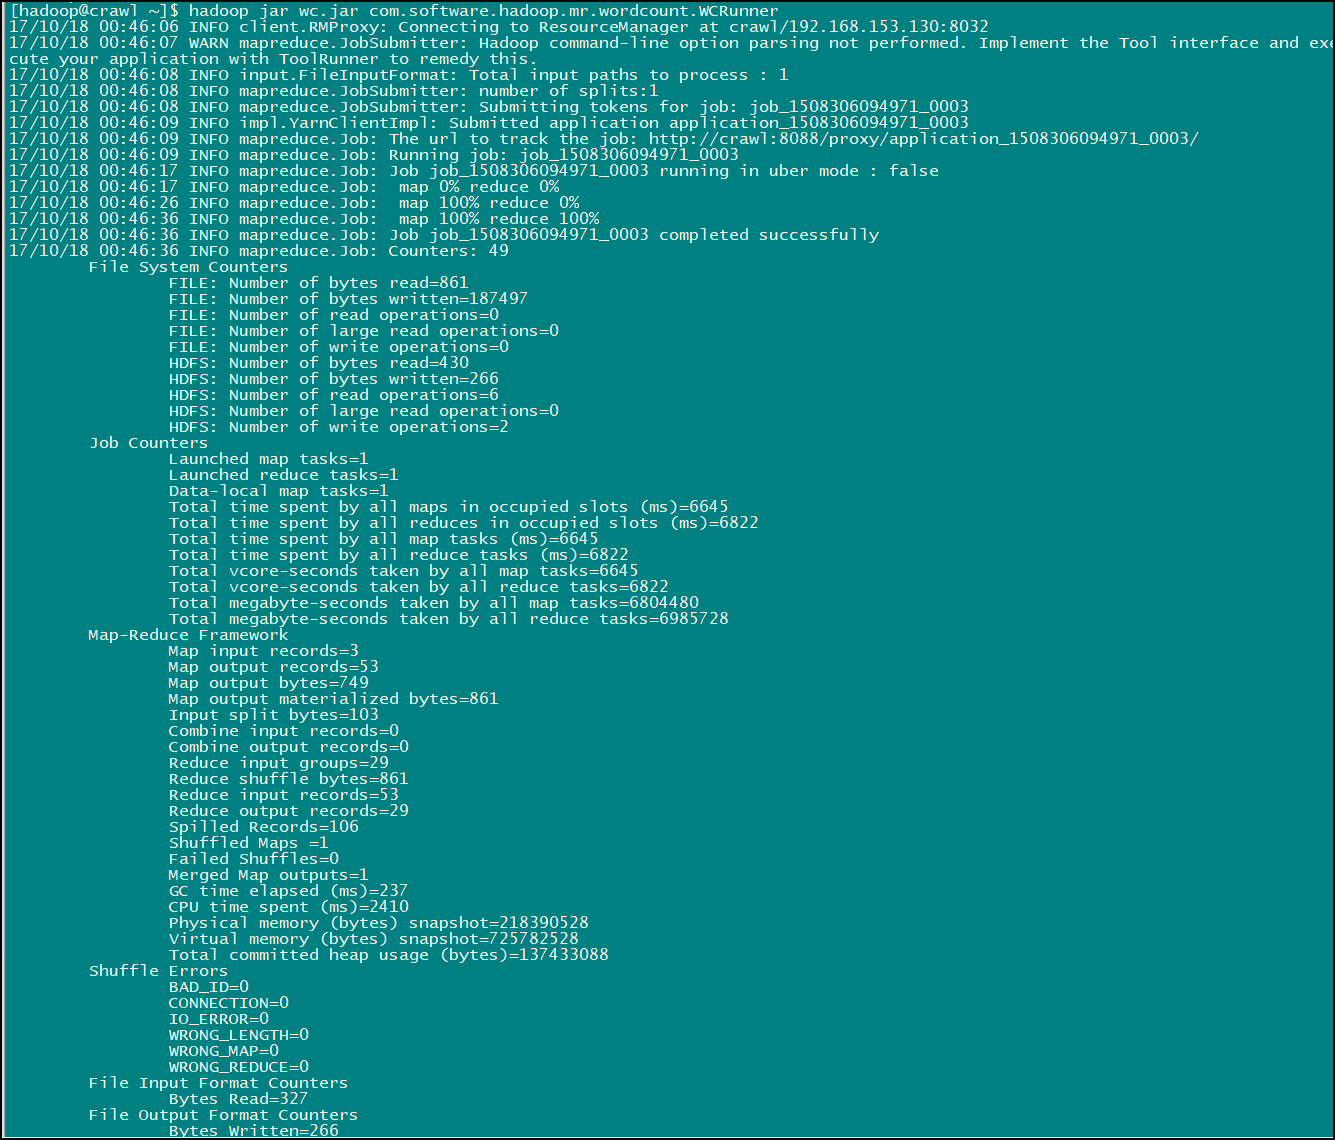
然后前去我们之前配置的存放输出结果的路径(楼主之前设置的为:/wc/output/)就可以看到 MapReduce 的执行结果了
输入命令:hadoop fs -ls /wc/output/ 查看以下 /wc/output/ 路径下的内容

结果数据就在第二个文件中,输入命令:hadoop fs -cat /wc/output/part-r-00000 即可查看:

至此我们的这个小应用就完成了,是不是很有意思的,楼主在实现的时候还是发生了一点小意外:
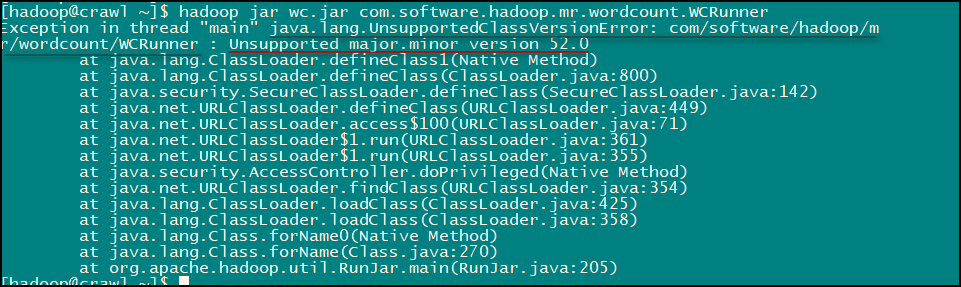
楼主查阅资料发现这是由于 jdk 版本不一致导致的错误,统一 jdk 版本后便没有问题了。
MapReduce 入门之一步步自实现词频统计功能的更多相关文章
- Java实现的词频统计——功能改进
本次改进是在原有功能需求及代码基础上额外做的修改,保证了原有的基础需求之外添加了新需求的功能. 功能: 1. 小文件输入——从控制台由用户输入到文件中,再对文件进行统计: 2.支持命令行输入英文作品的 ...
- awk词频统计功能
[root@test88 ~]# vim word_freq.sh #!/bin/bash if [ $# -ne 1 ];then echo "Usage: $0 filename&quo ...
- 使用HDFS完成wordcount词频统计
任务需求 统计HDFS上文件的wordcount,并将统计结果输出到HDFS 功能拆解 读取HDFS文件 业务处理(词频统计) 缓存处理结果 将结果输出到HDFS 数据准备 事先往HDFS上传需要进行 ...
- 如何用java完成一个中文词频统计程序
要想完成一个中文词频统计功能,首先必须使用一个中文分词器,这里使用的是中科院的.下载地址是http://ictclas.nlpir.org/downloads,由于本人电脑系统是win32位的,因此下 ...
- 软工之词频统计器及基于sketch在大数据下的词频统计设计
目录 摘要 算法关键 红黑树 稳定排序 代码框架 .h文件: .cpp文件 频率统计器的实现 接口设计与实现 接口设计 核心功能词频统计器流程 效果 单元测试 性能分析 性能分析图 问题发现 解决方案 ...
- 使用Storm进行词频统计
词频统计 1.需求:读取指定目录的数据,并且实现单词计数功能 2.实现方案: Spout用于读取指定文件夹(目录),读取文件,将文件的每一行发射到Bolt SplitBolt用于接收Spout发射过来 ...
- MapReduce词频统计
自定义Mapper实现 import org.apache.hadoop.io.IntWritable; import org.apache.hadoop.io.LongWritable; impor ...
- MapReduce实现词频统计
问题描述:现在有n个文本文件,使用MapReduce的方法实现词频统计. 附上统计词频的关键代码,首先是一个通用的MapReduce模块: class MapReduce: __doc__ = ''' ...
- map-reduce入门
map-reduce入门 近期在改写mahout源代码,感觉自己map-reduce功力不够深厚,因此打算系统学习一下. map-reduce事实上是一种编程范式,从统计词频(wordCount)程序 ...
随机推荐
- VIM格式化代码(How to format code with VIM)
1) 按两下小写g,即gg,定位光标到第一行.(2) 按住Shift+v,即大写V,进入可视化编辑的列编辑模式.(3) Shift+g,即大写G,选中整个代码.(4) 按下等号=,格式化所有代码.
- 无需安装SqlServer打开并管理SqlServer数据库的方法
本地安装的数据库是SqlServer2008R2的 在附加一个数据库文件时出现了以下错误 错误的原因就是附加的数据库版本太高,而本地数据库版本太低导致的 通过各种方式才查询到附加的数据库版本是SqlS ...
- svn 提交 working copy is not up-to-date
svn在提交时报错信息如下: working copy is not up-to-date svn:commit failed(details follow): svn:file "xxxx ...
- MongoDB索引限制
1. 额外开销: 每个索引占据一定的存储空间,在进行插入,更新和删除操作时也需要对索引进行操作.所以,如果你很少对集合进行读取操作,建议不使用索引. 2. 内存使用: 由于索引是存储在内存(RAM)中 ...
- scala攻略--简介
在个人学习scala的过程中,产生了写一系列随笔的想法,这些随笔包括:翻译自官网.其他英文网站的文章以及自己的心得体会,本文章作为这个系列中的第一个. 由于本人能力所限,以及对scala还处于初级阶段 ...
- 机器翻译评测——BLEU算法详解
◆版权声明:本文出自胖喵~的博客,转载必须注明出处. 转载请注明出处:http://www.cnblogs.com/by-dream/p/7679284.html 前言 近年来,在自然语言研究领域中, ...
- Python[1,1]
####################################################################################### //只是为了凑够150字 ...
- 使用sklearn进行数据挖掘-房价预测(4)—数据预处理
在使用机器算法之前,我们先把数据做下预处理,先把特征和标签拆分出来 housing = strat_train_set.drop("median_house_value",axis ...
- myeclipse+tomcat中出现org.apache.juli.logging.LogFactory这样的错误[转]
将项目部署好后,启动tomcat后报错,java.lang.NoClassDefFoundError: org/apache/juli/logging/LogFactory 报这个错说明你用的是t ...
- Cloud9 on Docker镜像发送
老外有做过几个cloud9的镜像,但是都有各种各样的问题. 小弟在此做了一个docker镜像,特此分享,希望各位大佬多提宝贵意见.谢谢. Cloud9 Online IDE Coding anywhe ...