
【Spark】源码分析之RDD的生成及stage的切分
一、概述
Spark源码整体的逻辑(spark1.3.1):
从saveAsTextFile()方法入手
-->saveAsTextFile()
--> saveAsHadoopFile()
--> 封装hadoopConf,并传入saveAsHadoopDataset()方法
--> 拿到写出流SaprkHadoopWriter,调用self.context.runJob(self,writeToFile)
--> runJob方法中,使用dagScheduler划分stage
--> submitJob开始提交作业
-->任务处理器的post方法启动线程,获取队列中的任务,并调用onRecevie()方法提交任务
-->调用handleJobSubmitted,使用newStage中的getParentStage方法对stage进行切分
-->getParentStage方法中,使用HashSet、Stack来存放stage和RDD,用栈来存储RDD主要是为了便于后面通过循环进行模式匹配,判断该RDD和父RDD的依赖关系,如果是宽依赖就会生成stage,如果是窄依赖,就会继续找父RDD
二、Spark源码详情
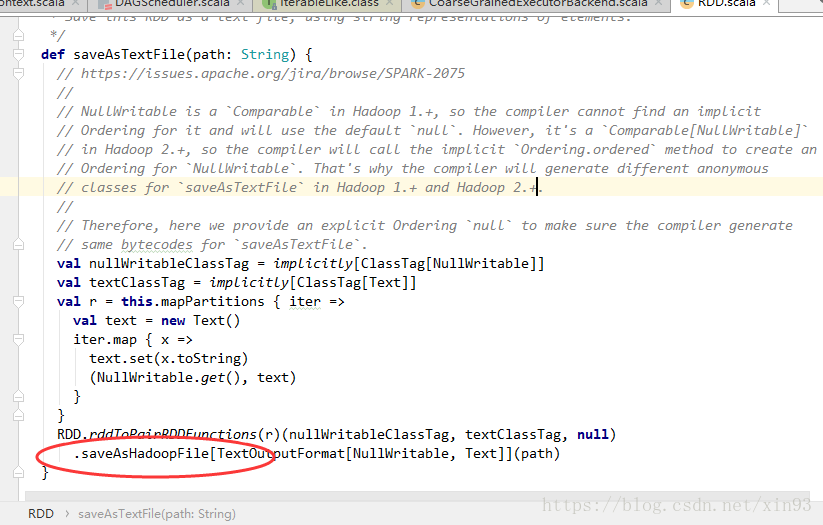
1. 在spark1.3.1的源码中,saveAsTextFile的关键代码在于它内部调用了saveAsHadoopFile()方法。
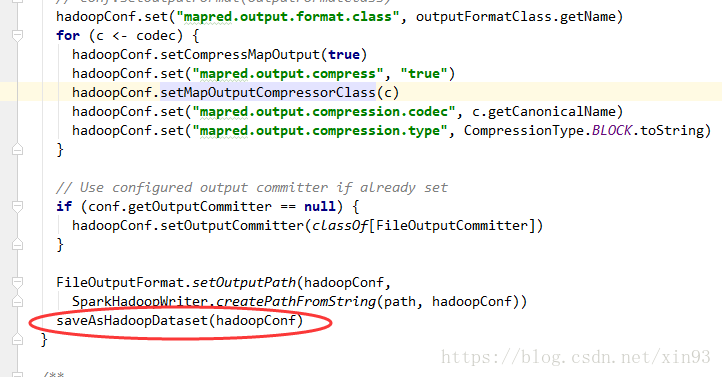
2. 进入到saveAsHadoopFile()方法中,首先spark会对配置信息进行封装,然后将配置信息传入saveAsHadoopDataset( )方法
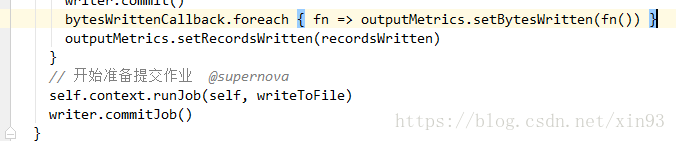
3. saveAsHadoopDataset()方法中将会拿到Spark的写出流,并调用runJob方法准备开始提交作业。

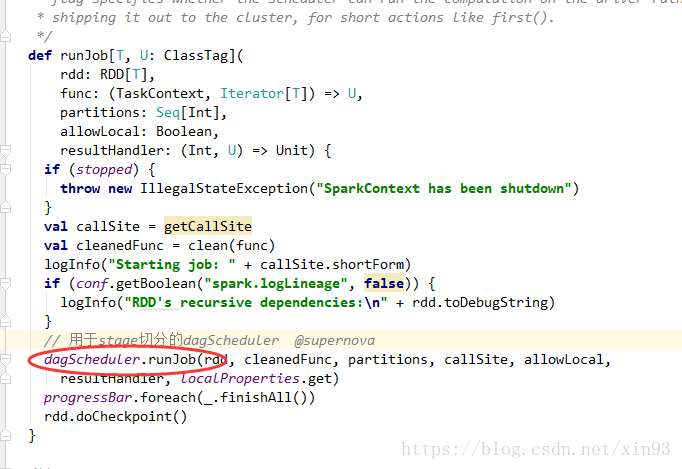
4. 进入runJob方法中,会使用dagScheduler进行stage的切分
5. submitJob开始提交作业

6. 获取finalRDD的分区数,并调用任务处理器的post方法,循环取出数据放入队列中
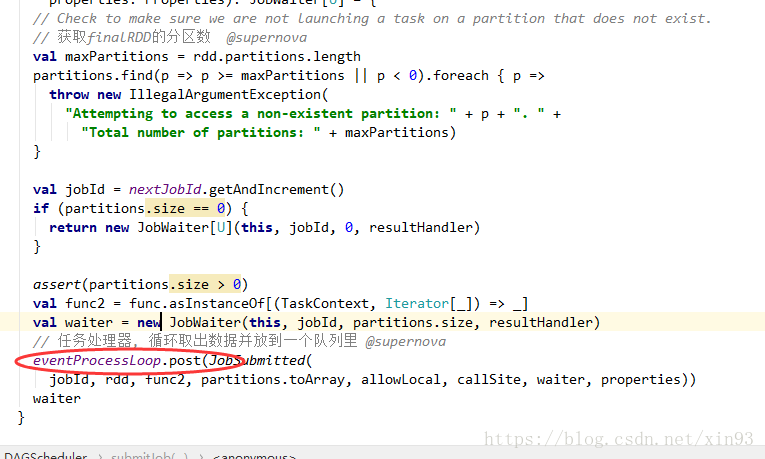
7. post方法中,将启动一个线程,将获取队列中的任务,并调用onRecevie()方法提交任务

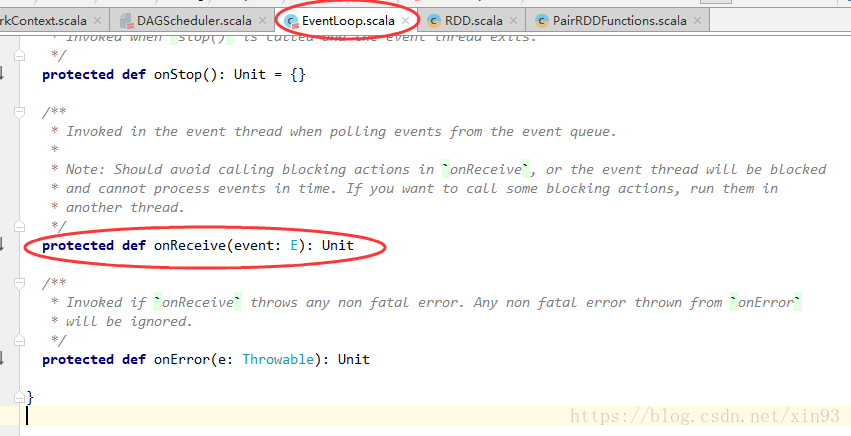
8. 进入onReceive(),可以看到它是一个抽象类中的方法
9. 方法的实现在DAGScheduler中,对方法进行模式匹配。 匹配到任务提交的方法后,调用handleJobSumitted提交任务
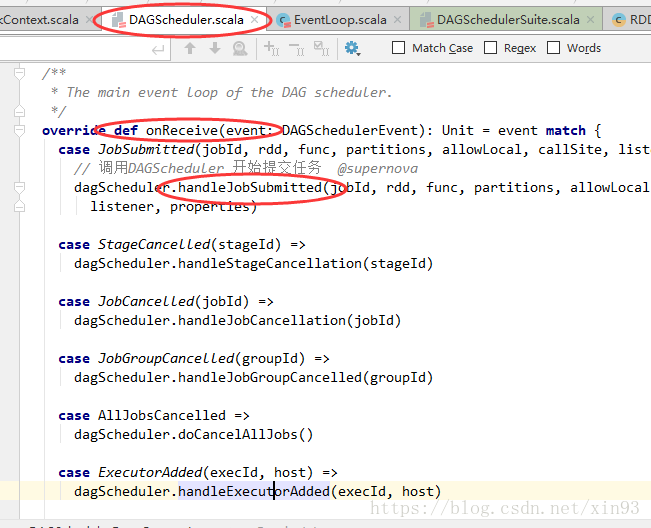
10. handleJobSubmitted中,使用newStage中的getParentStage方法对stage进行切分

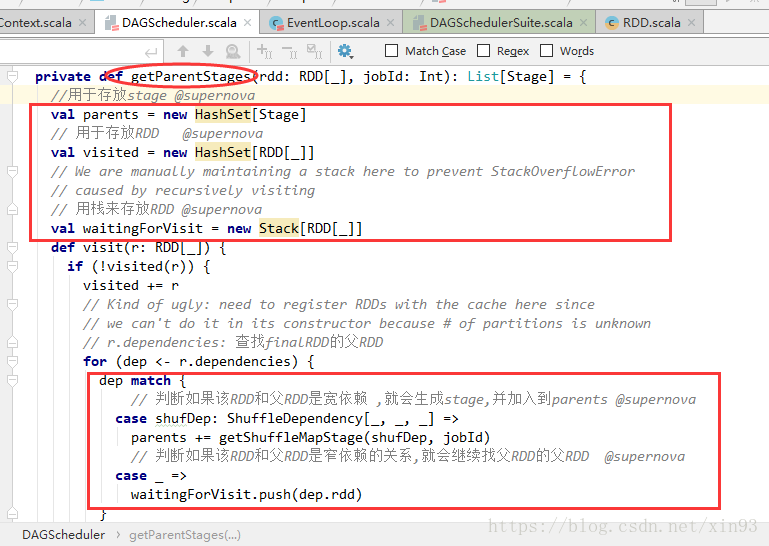
11. getParentStage方法中,使用HashSet、Stack来存放stage和RDD,用栈来存储RDD主要是为了便于后面通过循环进行模式匹配,判断该RDD和父RDD的依赖关系,如果是宽依赖就会生成stage,如果是窄依赖,就会继续找父RDD
【Spark】源码分析之RDD的生成及stage的切分的更多相关文章
- spark 源码分析之一 -- RDD的四种依赖关系
RDD的四种依赖关系 RDD四种依赖关系,分别是 ShuffleDependency.PrunDependency.RangeDependency和OneToOneDependency四种依赖关系.如 ...
- spark 源码分析之十九 -- DAG的生成和Stage的划分
上篇文章 spark 源码分析之十八 -- Spark存储体系剖析 重点剖析了 Spark的存储体系.从本篇文章开始,剖析Spark作业的调度和计算体系. 在说DAG之前,先简单说一下RDD. 对RD ...
- Spark 源码分析系列
如下,是 spark 源码分析系列的一些文章汇总,持续更新中...... Spark RPC spark 源码分析之五--Spark RPC剖析之创建NettyRpcEnv spark 源码分析之六- ...
- spark源码分析以及优化
第一章.spark源码分析之RDD四种依赖关系 一.RDD四种依赖关系 RDD四种依赖关系,分别是 ShuffleDependency.PrunDependency.RangeDependency和O ...
- Spark源码分析 – DAGScheduler
DAGScheduler的架构其实非常简单, 1. eventQueue, 所有需要DAGScheduler处理的事情都需要往eventQueue中发送event 2. eventLoop Threa ...
- Spark源码分析:多种部署方式之间的区别与联系(转)
原文链接:Spark源码分析:多种部署方式之间的区别与联系(1) 从官方的文档我们可以知道,Spark的部署方式有很多种:local.Standalone.Mesos.YARN.....不同部署方式的 ...
- Spark源码分析 – Shuffle
参考详细探究Spark的shuffle实现, 写的很清楚, 当前设计的来龙去脉 Hadoop Hadoop的思路是, 在mapper端每次当memory buffer中的数据快满的时候, 先将memo ...
- Spark源码分析 – BlockManager
参考, Spark源码分析之-Storage模块 对于storage, 为何Spark需要storage模块?为了cache RDD Spark的特点就是可以将RDD cache在memory或dis ...
- Spark源码分析 – SparkContext
Spark源码分析之-scheduler模块 这位写的非常好, 让我对Spark的源码分析, 变的轻松了许多 这里自己再梳理一遍 先看一个简单的spark操作, val sc = new SparkC ...
随机推荐
- C#中的多线程 - 同步基础 z
原文:http://www.albahari.com/threading/part2.aspx 专题:C#中的多线程 1同步概要Permalink 在第 1 部分:基础知识中,我们描述了如何在线程上启 ...
- Kibana基本使用
现在你已经安装了Kibana,现在你一步步通过本教程快速获取Kibana核心功能的实践经验.学习完本教程,你将: 1.加载案例数据到你安装的Elasticsearch中 2. 定义至少一个索引匹配模式 ...
- photoshopcs6破解补丁用来干嘛的
photoshopcs6破解补丁为 Adobe CS6 系列软件通用破解补丁,亲测可用,终于能用了不再出现那个烦人的购买页面了,cs6破解补丁解压后得到32和64两个文件夹,根据自己的系统类型选择,6 ...
- 获取所有权windows目录所有权
Takeown /r /f 盘符:\目录\目录 例如: Takeown /r /f C:\Windows\CSC
- java中i = i++问题
今天偶然呗问到了一个java中自增运算符的问题,涉及到了堆栈,觉得挺有趣的把它记录下来. int i=0; i=i++; 结果i是多少? 这是一个经常被提及的问题,答案一 ...
- 什么是SAP GUI的client
我们用SAPGUI登录某个系统时,除了用户名和密码外,还要指定一个必填字段client: 这个client是什么东东? 看文档: SAP Client is the highest hierarchi ...
- 对EJB的认识
对EJB的认识 接触EJB以来有一段时间了,走马观花一样把它所涉及到的东西看了一遍,随着深入了解越来越感觉到ejb的很强大,用了java后觉的java好用.学历SSH觉的比java好用.学了ejb觉的 ...
- js call、apply和bind
function add(a,b) { alert(a+b); } function sub(a,b) { alert(a-b); } add.call(sub,3,1); 例1 例子1中的意思就是用 ...
- bootstrap Switch 的一个坑点
在bootstrap的modal点开的时候改变bootstrapSwitch的状态的时候,会出现第一次打开modal,switch没有变化,第二次以后打开modal才会改变,这个问题找了好久没有找到答 ...
- Oracle 查找带有CLOB字段的所有表
查找带有CLOB字段的以HEHE开头的所有表 select t.column_name ,DATA_TYPE,TABLE_NAMEfrom user_tab_columns twhere t.TABL ...