
[hadoop](3) MapReduce:创建计数器、任务状态和写入日志
前言
本章主要讲述了如何在mapreduce任务中添加自定义的计数器,从所有任务中聚合信息,并且最终输出到mapreduce web ui中得到统计信息。
准备工作
数据集:ufo-60000条记录,这个数据集有一系列包含下列字段的UFO目击事件记录组成,每条记录的字段都是以tab键分割,请看http://www.cnblogs.com/cafebabe-yun/p/8679994.html
- sighting date:UFO目击事件发生时间
- Recorded date:报告目击事件的时间
- Location:目击事件发生的地点
- Shape:UFO形状
- Duration:目击事件持续时间
- Dexcription:目击事件的大致描述
例子:
19950915 19950915 Redmond, WA 6 min. Young man w/ 2 co-workers witness tiny, distinctly white round disc drifting slowly toward NE. Flew in dir. 90 deg. to winds.
需要共享的数据:州名缩写与全称的对应关系
数据:
AL      Alabama

AK      Alaska

AZ      Arizona

AR      Arkansas

CA      California
自定义计数器的使用
- 将数据集 ufo.tsv 上传到hdfs上
hadoop dfs -put ufo.tsv ufo.tsv
- 将共享数据数据上传到hdfs上,命令同上
- 创建文件 UFOCountingRecordValidationMapper.java ,并且输入以下代码:
import java.io.IOException;

import org.apache.hadoop.io.*;

import org.apache.hadoop.mapred.*;

import org.apache.hadoop.mapred.lib.*;

public class UFOCountingRecordValidationMapper extends MapReduceBase implements Mapper<LongWritable, Text, LongWritable, Text> {

    public enum LineCounters {

        BAD_LINES,

        TOO_MANY_TABS,

        TOO_FEW_TABS

    };

    @Override

    public void map(LongWritable key, Text value, OutputCollector<LongWritable, Text> output, Reporter reporter) throws IOException {

        String line = value.toString();

        if(validate(line, reporter)) {

            output.collect(key, value);

        }

    }

    private boolean validate(String line, Reporter reporter) {

        String[] words = line.split("\t");

        if (words.length != 6) {

            if (words.length < 6) {

                reporter.incrCounter(LineCounters.TOO_MANY_TABS

, 1);

              } else {

                reporter.incrCounter(LineCounters.TOO_FEW_TABS, 1);

            }

            reporter.incrCounter(LineCounters.BAD_LINES, 1);

            if ((reporter.getCounter(LineCounters.BAD_LINES).getCounter() % 10) == 0) {

                reporter.setStatus("Got 10 bad lines.");

                System.err.println("Read another 10 bad lines.");

            }

            return false;

        }

        return true;

    }

}
- 创建文件 UFOLocation3.java ,并输入以下代码:
import java.io.*;

import java.util.*;

import java.net.*;

import java.util.regex.*;

import org.apache.hadoop.conf.*;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.filecache.DistributedCache;

import org.apache.hadoop.io.*;

import org.apache.hadoop.mapred.*;

import org.apache.hadoop.mapred.lib.*;

public class UFOLocation3 {

    public static class MapClass extends MapReduceBase implements Mapper<LongWritable, Text, Text, LongWritable> {

        private final static LongWritable one = new LongWritable(1);

        private static Pattern locationPattern = Pattern.compile("[a-zA-Z]{2}[^a-zA-Z]*$");

        private Map<String, String> stateNames;

        @Override

        public void configure(JobConf job) {

            try {

                Path[] cacheFiles = DistributedCache.getLocalCacheFiles(job);

                setupStateMap(cacheFiles[0].toString());

            } catch (IOException e) {

                System.err.println("Error reading state file.");

                System.exit(1);

            }

        }

        private void setupStateMap(String fileName) throws IOException {

            Map<String, String> stateCache = new HashMap<String, String>();

            BufferedReader reader = new BufferedReader(new FileReader(fileName));

            String line = null;

            while((line = reader.readLine()) != null) {

                String[] splits = line.split("\t");

                stateCache.put(splits[0], splits[1]);

            }

            stateNames = stateCache;

        }

        @Override

        public void map(LongWritable key, Text value, OutputCollector<Text, LongWritable> output, Reporter reporter) throws IOException {

            String line = value.toString();

            String[] fields = line.split("\t");

            String location = fields[2].trim();

            if(location.length() >= 2) {

                Matcher matcher = locationPattern.matcher(location);

                if(matcher.find()) {

                    int start = matcher.start();

                    String state = location.substring(start, start + 2);

                    output.collect(new Text(lookupState(state.toUpperCase())), one);

                }

            }

        }

        private String lookupState(String state) {

            String fullName = stateNames.get(state);

            if(fullName == null || "".equals(fullName)) {

                fullName = state;

            }

            return fullName;

        }

    }

    public static void main(String...args) throws Exception {

        Configuration config = new Configuration();

        JobConf conf = new JobConf(config, UFOLocation3.class);

        conf.setJobName("UFOLocation3");

        DistributedCache.addCacheFile(new URI("/user/root/states.txt"), conf);

        conf.setOutputKeyClass(Text.class);

        conf.setOutputValueClass(LongWritable.class);

        JobConf mapconf1 = new JobConf(false);

        ChainMapper.addMapper(conf, UFOCountingRecordValidationMapper.class, LongWritable.class, Text.class, LongWritable.class, Text.class, true, mapconf1);

        JobConf mapconf2 = new JobConf(false);

        ChainMapper.addMapper(conf, MapClass.class, LongWritable.class, Text.class, Text.class, LongWritable.class, true, mapconf2);

        conf.setMapperClass(ChainMapper.class);

        conf.setCombinerClass(LongSumReducer.class);

        conf.setReducerClass(LongSumReducer.class);

        FileInputFormat.setInputPaths(conf, args[0]);

        FileOutputFormat.setOutputPath(conf, new Path(args[1]));

        JobClient.runJob(conf);

    }

}
- 编译上述的两个文件
javac UFOCountingRecordValidationMapper.java UFOLocation3.java
- 将编译好的文件打包成jar文件
jar cvf ufo3.jar UFO*class
- 在hadoop上执行jar包
hadoop cvf ufo3.jar UFOLocation3 ufo.tsv output
- 查看输出结果
hadoop dfs -cat output/part-00000
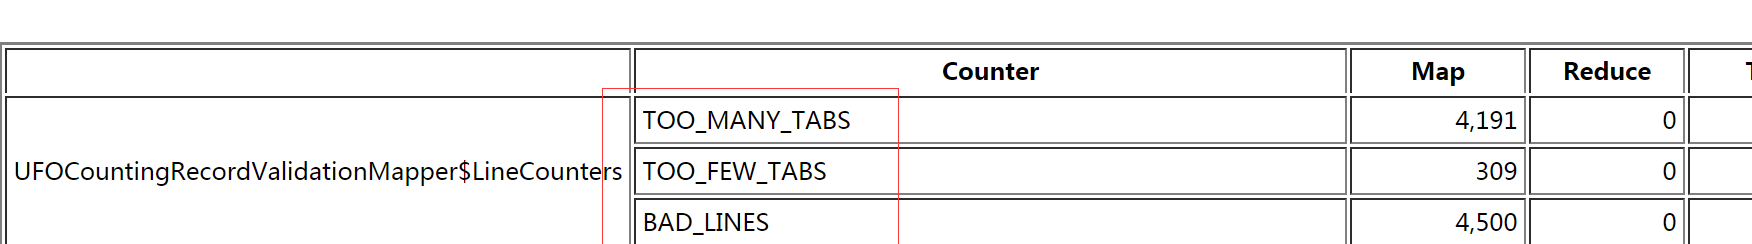
- 在mapreduce web ui页面上查看统计信息
- 相应的job,进入job的统计信息页面

- 查看统计信息
[hadoop](3) MapReduce:创建计数器、任务状态和写入日志的更多相关文章
- Hadoop基础-MapReduce的工作原理第一弹
Hadoop基础-MapReduce的工作原理第一弹 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 在本篇博客中,我们将深入学习Hadoop中的MapReduce工作机制,这些知识 ...
- Hadoop基础-MapReduce的排序
Hadoop基础-MapReduce的排序 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.MapReduce的排序分类 1>.部分排序 部分排序是对单个分区进行排序,举个 ...
- Hadoop 新 MapReduce 框架 Yarn 详解【转】
[转自:http://www.ibm.com/developerworks/cn/opensource/os-cn-hadoop-yarn/] 简介: 本文介绍了 Hadoop 自 0.23.0 版本 ...
- hadoop之mapreduce详解(进阶篇)
上篇文章hadoop之mapreduce详解(基础篇)我们了解了mapreduce的执行过程和shuffle过程,本篇文章主要从mapreduce的组件和输入输出方面进行阐述. 一.mapreduce ...
- hadoop(二MapReduce)
hadoop(二MapReduce) 介绍 MapReduce:其实就是把数据分开处理后再将数据合在一起. Map负责“分”,即把复杂的任务分解为若干个“简单的任务”来并行处理.可以进行拆分的前提是这 ...
- Hadoop 新 MapReduce 框架 Yarn 详解
Hadoop 新 MapReduce 框架 Yarn 详解: http://www.ibm.com/developerworks/cn/opensource/os-cn-hadoop-yarn/ Ap ...
- 用PHP编写Hadoop的MapReduce程序
用PHP编写Hadoop的MapReduce程序 Hadoop流 虽然Hadoop是用Java写的,但是Hadoop提供了Hadoop流,Hadoop流提供一个API, 允许用户使用任何语言编 ...
- HADOOP之MAPREDUCE程序应用二
摘要:MapReduce程序进行单词计数. 关键词:MapReduce程序 单词计数 数据源:人工构造英文文档file1.txt,file2.txt. file1.txt 内容 Hello Ha ...
- 对于Hadoop的MapReduce编程makefile
根据近期需要hadoop的MapReduce程序集成到一个大的应用C/C++书面框架.在需求make当自己主动MapReduce编译和打包的应用. 在这里,一个简单的WordCount1一个例子详细的 ...
随机推荐
- docker远程访问TLS证书认证shell
docker开启远程访问端口,防止非法访问 配置证书认证 配置防火墙或安全策略 #!/bin/bash # docker.tls.sh # 环境centos 7 ,root # 创建 Docker T ...
- JAVA在页面查看或下载服务器上的日志
1.配置 FileUtils类所需jar包的maven地址 <dependency> <groupId>commons-io</groupId> <artif ...
- 解决jQuery的toggle()的自动触发问题
在1.9以后的版本toggle()就存在这个问题,用之前的版本就正常了 解决办法: 1.去 jquery官网下载一个版本升级文件.http://blog.jquery.com/2013/05/08/j ...
- 如何实现动态水球图 --》 echars结合echarts-liquidfill实现
1)项目中作为项目依赖,安装到项目当中(注意必须要结合echars) npm install echarts vue-echarts --save npm install echarts-liquid ...
- 前端 CSS的选择器 伪类选择器 CSS3 nth-child()
first-child 选中第一个标签 应用CSS样式 <!DOCTYPE html> <html lang="en"> <head> < ...
- Hibernate异常:MappingException
异常信息: org.hibernate.MappingException: Unknown entity: com.geore.pojo.customer.Customer 造成原因: Mapping ...
- Java第三周总结&实验报告(1)
总结:不知不觉,到了第三周,回顾这一周,我更加深入了解了main方法,除此之外,学习了两个关键字,一个this,一个static,this在强调属性时,只能放在句首且不能循环调用,static声明用于 ...
- (4.14)mysql备份还原——mysql物理热备工具之ibbackup
关键词:mysql热备工具,ibbackup,mysql物理备份工具 1. 准备 ibbackup 是 InnoDB 提供的收费工具,它支持在线热备 InnoDB 数据,主要有以下特性: * Onli ...
- Balanced Lineup poj3264 线段树
Balanced Lineup poj3264 线段树 题意 一串数,求出某个区间的最大值和最小值之间的差 解题思路 使用线段树,来维护最大值和最小值,使用两个查询函数,一个查区间最大值,一个查区间最 ...
- JS相比TS的缺点(或TS的优点)
JS只有在运行时,才会抛出错误, JS里有任何的拼写错误 都不会提示错误 JS运行时报的错,指向也未必是错误的源头,也就是说:A类里因为书写代码有误,会造成运行时其他的类报错如B JS无法做到不同pa ...