
wget 指令学习之递归抓取文档技巧
在线上阅读文档的时候,有没有想将它抓取到本地,以备没有网的时候阅读只需?
先上指令:
$ wget --user-agent="Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Ubuntu Chromium/53.0.2785.143 Chrome/53.0.2785.143 Safari/537.36" -p -np -k -r --wait=1 http://www.tornadoweb.org/en/stable/
你会看到如下的页面:
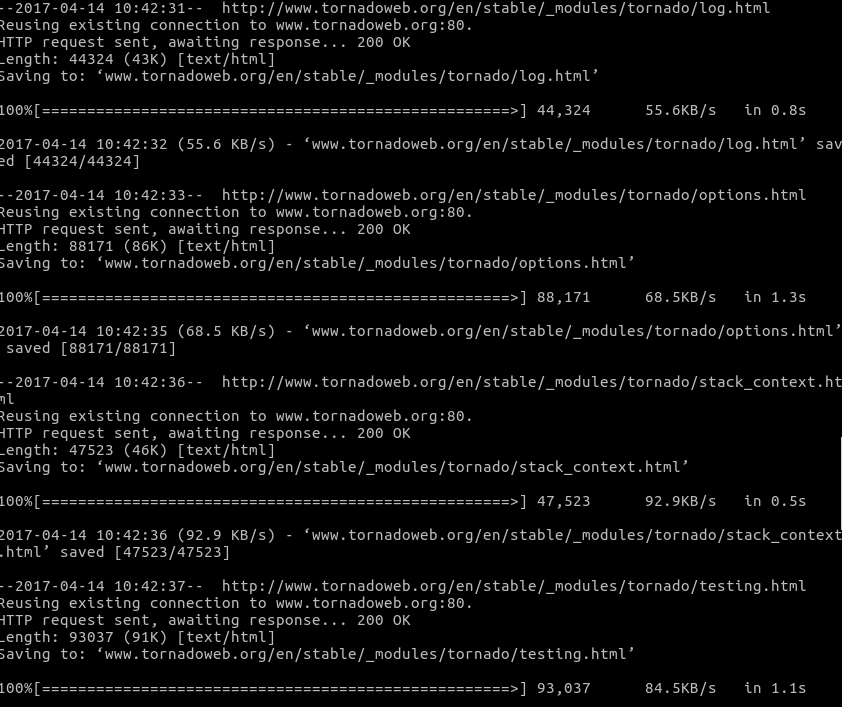
过段时间,就会抓取完成,并在本地生成了一个相关联的目录。
这个命令就是 wget。它是开发者在Linux下面非常喜欢使用的下载指令。经常,我们会看到一些技术文档在指导你下载安装包的时候,也会用到,比如: wget xxx.tar.gz 之类的。
我们可以通过 man wget 或 wget -h 来查阅 wget 的参数。下面挑出几个常用的参数介绍下。
HTTP 相关的:
  --http-user=USER        设置 http 用户名为 USER。
  --http-password=PASS    设置 http 密码为 PASS。
  --no-cache              不在服务器上缓存数据。
  -U,  --user-agent=AGENT      标识为 AGENT 而不是 Wget/VERSION。
       --no-http-keep-alive    禁用 HTTP keep-alive (永久连接)。
       --no-cookies            不使用 cookies。
       --load-cookies=FILE     会话开始前从 FILE 中载入 cookies。
       --save-cookies=FILE     会话结束后保存 cookies 至 FILE。
       --keep-session-cookies  载入并保存会话 (非永久) cookies。
       --post-data=STRING      使用 POST 方式;把 STRING 作为数据发送。
       --post-file=FILE        使用 POST 方式;发送 FILE 内容。
       --content-disposition   当选中本地文件名时
                               允许 Content-Disposition 头部 (尚在实验)。
       --auth-no-challenge     发送不含服务器询问的首次等待
                               的基本 HTTP 验证信息。
下载相关的:
  -w,  --wait=SECONDS            等待间隔为 SECONDS 秒。
       --waitretry=SECONDS       在获取文件的重试期间等待 1..SECONDS 秒。
       --random-wait             获取多个文件时,每次随机等待间隔
                                 0.5*WAIT...1.5*WAIT 秒。
-O     --output-document=FILE    将文档写入 FILE。
递归下载:
  -r,  --recursive          指定递归下载。
  -p,  --page-requisites    下载所有用于显示 HTML 页面的图片之类的元素。
  -k,  --convert-links      让下载得到的 HTML 或 CSS 中的链接指向本地文件。
  -np, --no-parent          不追溯至父目录。
原文网址 http://www.cnblogs.com/scharfsinnig/p/6707859.html

参考文档:
  http://linux.51yip.com/search/wget
wget 指令学习之递归抓取文档技巧的更多相关文章
- scrapy递归抓取网页数据
scrapy spider的parse方法能够返回两种值:BaseItem.或者Request.通过Request能够实现递归抓取. 假设要抓取的数据在当前页,能够直接解析返回item(代码中带**凝 ...
- Xml学习笔记(3)利用递归解析Xml文档添加到TreeView中
利用递归解析Xml文档添加到TreeView中 private void Form1_Load(object sender, EventArgs e) { XmlDocument doc = new ...
- SpringBoot学习笔记:Swagger实现文档管理
SpringBoot学习笔记:Swagger实现文档管理 Swagger Swagger是一个规范且完整的框架,用于生成.描述.调用和可视化RESTful风格的Web服务.Swagger的目标是对RE ...
- python爬虫学习:分布式抓取
前面的文章都是基于在单机操作,正常情况下,一台机器无论配置多么高,线程开得再多,也总会有一个上限,或者说成本过于巨大.因此,本文将提及分布式的爬虫,让爬虫的效率提高得更快. 构建分布式爬虫首先需要有多 ...
- Node.js的学习--使用cheerio抓取网页数据
打算要写一个公开课网站,缺少数据,就决定去网易公开课去抓取一些数据. 前一阵子看过一段时间的Node.js,而且Node.js也比较适合做这个事情,就打算用Node.js去抓取数据. 关键是抓取到网页 ...
- Java学习-046-日志抓取合并后排序问题解决方案之 --- log4j 二次定制,实现日志输出添加延时10ms
自3月25至今,已经好久没有写学习日志了,今天在写日志抓取合并的小方法,发现抓取后的日志并米有依据系统执行的日志顺序排序.日志抓取排列逻辑如下: 通过日志标识,从各个日志文件(例如 use.log,e ...
- Nodejs全站开发学习系列 & 深入浅出Node学习笔记 & Spider抓取
https://course.tianmaying.com/node 这个系列的文章看起来很不错,值得学习一下. /Users/baidu/Documents/Data/Interview/Web-S ...
- Nutch学习笔记二——抓取过程简析
在上篇学习笔记中http://www.cnblogs.com/huligong1234/p/3464371.html 主要记录Nutch安装及简单运行的过程. 笔记中 通过配置抓取地址http://b ...
- hibernate框架学习之数据抓取(加载)策略helloworld
package cn.itcast.h3.query.hql; import java.util.List; import org.hibernate.Query; import org.hibern ...
随机推荐
- GoldenGate 双向复制解决方案
1 双向复制方案简介 在双向复制(Bidirectional)方案中,可以采用以下两种部署方式: 方式一:配置源和目标数据库可以同时保持Active 状态,同时进行应用系统的事务处理, 此时需由应用系 ...
- NodeJS学习笔记 进阶 (2)Nodejs进阶:MD5加密算法(ok)
个人总结:这篇文章讲解了Nodejs中自带模块的MD5加密算法的使用,读完这篇文章需要15分钟,其实还有一个叫utility的包在npm上,也非常好用. 摘选自网络 简介 MD5(Message-Di ...
- vsftp迁移记录笔记
由于之前的服务器用的window下的ftp安全性和稳定性都不好,所以我们才把ftp迁移到linux环境下 vsftp概述: vsftpd 它可以运行在多平台系统上面,是一个完全免费的.开放源代码的f ...
- Laravel+vue实现history模式URL可行方案
项目:laravel + vue 实现前后端分离.vue-router 默认 hash 模式 -- 使用 URL 的 hash 来模拟一个完整的 URL,于是当 URL 改变时,页面不会重新加载. h ...
- python中的装饰器decorator
python中的装饰器 装饰器是为了解决以下描述的问题而产生的方法 我们在已有的函数代码的基础上,想要动态的为这个函数增加功能而又不改变原函数的代码 例如有三个函数: def f1(x): retur ...
- MFC Wizard创建的空应用程序中各个文件内容的解析
创建的MFC应用程序名为:wd,那么: 一.wd.h解析 // wd.h : main header file for the WD application // #if !defined(AFX_W ...
- RvmTranslator6.6 - RVM to CATIA
RvmTranslator6.6 - RVM to CATIA eryar@163.com RvmTranslator can translate the RVM file exported by A ...
- 【HDU 5402】Travelling Salesman Problem(构造)
被某题卡SB了,结果这题也没读好...以为每一个格子能够有负数就当搜索做了.怎么想也搜只是去,后来发现每一个格子是非负数,那么肯定就是构造题. 题解例如以下: 首先假设nn为奇数或者mm为奇数,那么显 ...
- Linux 6.2配置yum本地
yum 1.挂在iso文件 [root@localhostmedia]# mount /dev/cdrom /media 2.安装createrepo createrepo是配置YUM源的配置工具,检 ...
- vue22 路由
<!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8&quo ...