
python爬虫——selenium+chrome使用代理
先看下本文中的知识点:
- python selenium库安装
- chrome webdirver的下载安装
- selenium+chrome使用代理
- 进阶学习
搭建开发环境:
- selenium库
- chrome webdirver
- 谷歌浏览器 >=7.9
PS:安装了的同学可以跳过了接着下一步,没安装的同学跟着我的步骤走一遍
安装selenium库
pip install selenium
安装chrome webdirver
这里要注意要配置系统环境,把chrome webdirver解压后放到python路径的Scripts目录下,跟pip在一个目录下。
这里可以教大家一个查看python安装路径的命令
# windows系统,打开cmd

where python

# linux系统

whereis python
谷歌浏览器
注意谷歌浏览器的版本要>=7.9,因为之前下载的chrome webdirver是7.9版本的。浏览器就自己安装吧。
代码样例
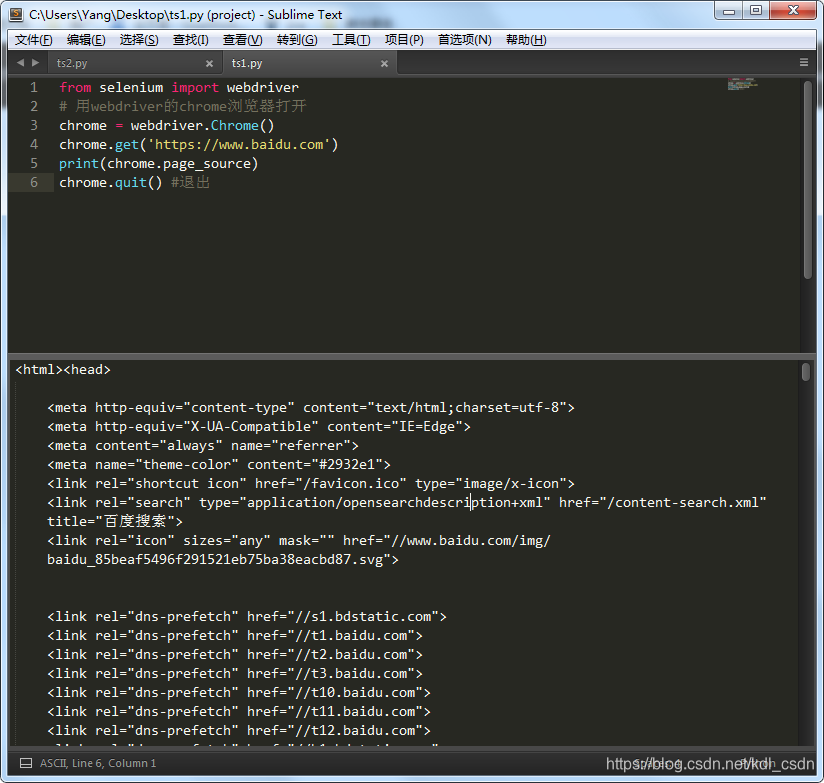
好的,现在咋们的环境都配置好了,写几行代码试下,以请求百度为例
from selenium import webdriver

# 用webdriver的chrome浏览器打开

chrome = webdriver.Chrome()

chrome.get('https://www.baidu.com')

print(chrome.page_source)

chrome.quit() #退出
运行下,先会打开chrome浏览器,然后访问百度,在打印page信息,最后关闭浏览器
使用代理
使用代理IP去访问就得加一个参数了,代码如下
from selenium import webdriver

chrome_options = webdriver.ChromeOptions()

# 代理IP,由快代理提供

proxy = '60.17.254.157:21222'

# 设置代理

chrome_options.add_argument('--proxy-server=%s' % proxy)

# 注意options的参数用之前定义的chrome_options

chrome = webdriver.Chrome(options=chrome_options)

# 百度查IP

chrome.get('https://www.baidu.com/s?ie=UTF-8&wd=ip')

print(chrome.page_source)

chrome.quit() #退出
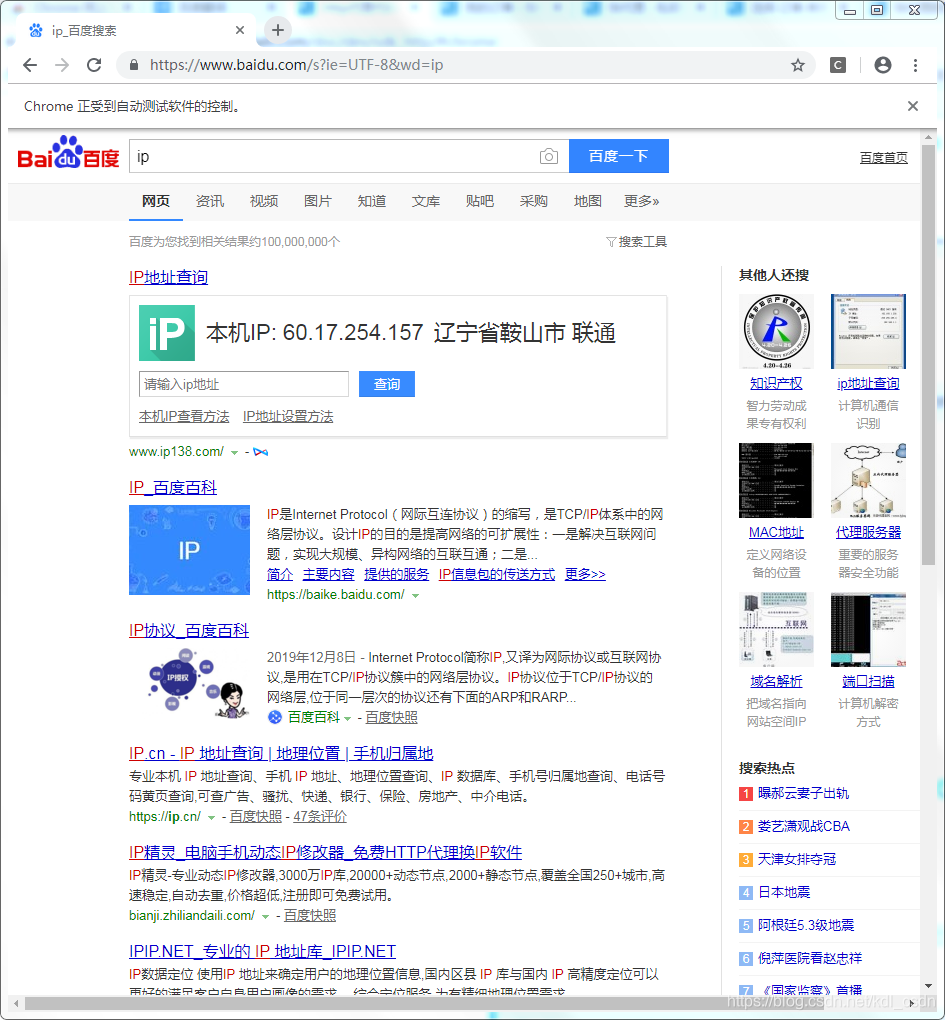
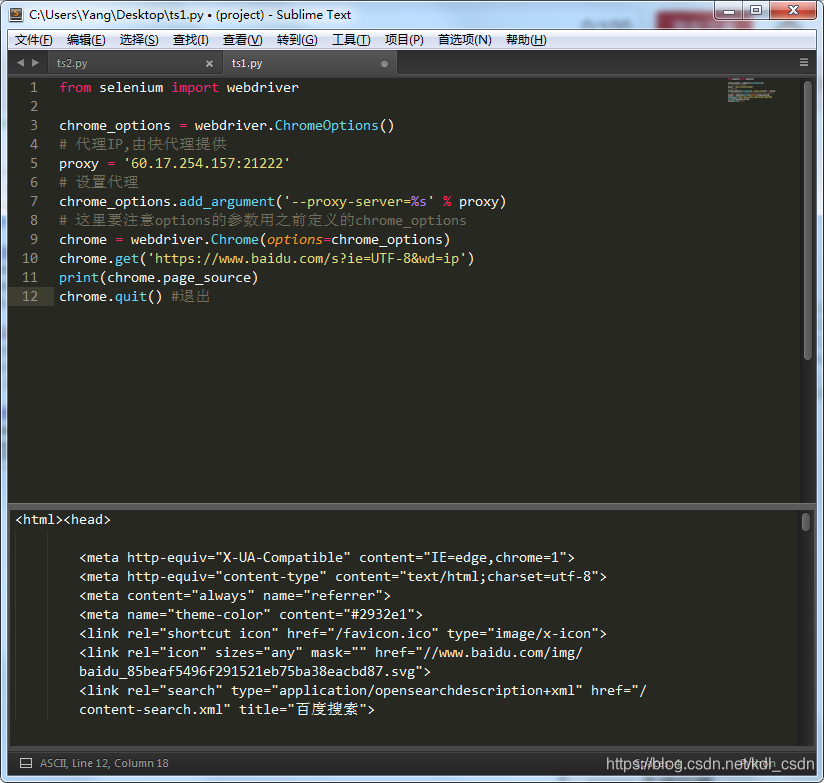
运行下,结果如图
扩展
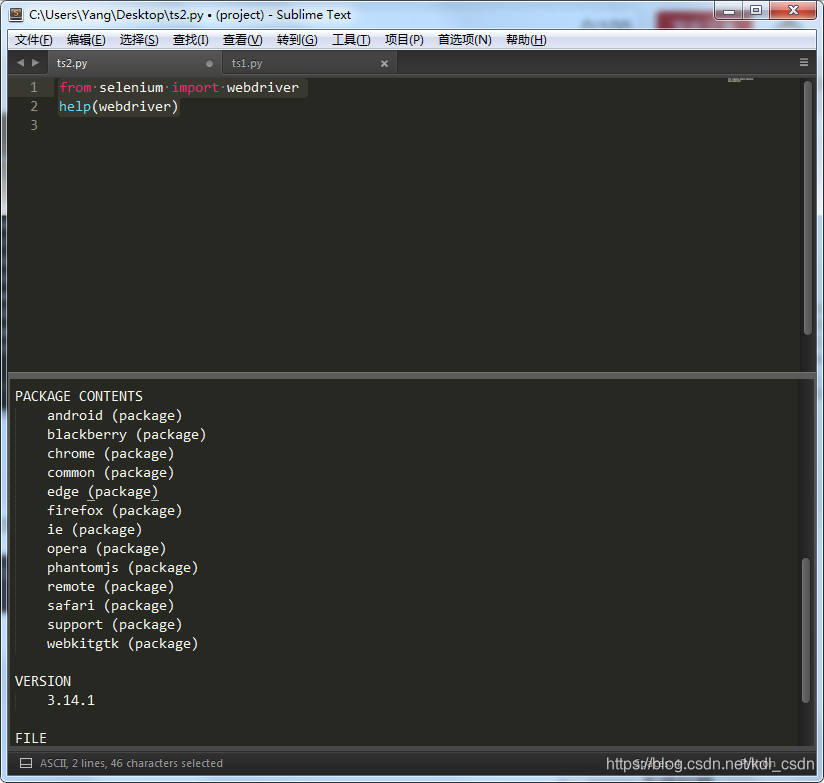
不想用谷歌浏览器啊,想用火狐怎么办。没问题啊,webdriver也支持火狐。看下webdriver的帮助文档
from selenium import webdriver

help(webdriver)
看下图,不止支持火狐firefox,谷歌chrome,ie,opera等等都支持的。
进阶学习
python爬虫——selenium+chrome使用代理的更多相关文章
- python爬虫——selenium+firefox使用代理
本文中的知识点: python selenium库安装 firefox geckodriver的下载与安装 selenium+firefox使用代理 进阶学习 搭建开发环境: selenium库 fi ...
- [Python爬虫] Selenium实现自动登录163邮箱和Locating Elements介绍
前三篇文章介绍了安装过程和通过Selenium实现访问Firefox浏览器并自动搜索"Eastmount"关键字及截图的功能.而这篇文章主要简单介绍如何实现自动登录163邮箱,同时 ...
- [Python爬虫] Selenium+Phantomjs动态获取CSDN下载资源信息和评论
前面几篇文章介绍了Selenium.PhantomJS的基础知识及安装过程,这篇文章是一篇应用.通过Selenium调用Phantomjs获取CSDN下载资源的信息,最重要的是动态获取资源的评论,它是 ...
- [Python爬虫] Selenium爬取新浪微博客户端用户信息、热点话题及评论 (上)
转载自:http://blog.csdn.net/eastmount/article/details/51231852 一. 文章介绍 源码下载地址:http://download.csdn.net/ ...
- python爬虫---selenium库的用法
python爬虫---selenium库的用法 selenium是一个自动化测试工具,支持Firefox,Chrome等众多浏览器 在爬虫中的应用主要是用来解决JS渲染的问题. 1.使用前需要安装这个 ...
- [python爬虫] Selenium常见元素定位方法和操作的学习介绍
这篇文章主要Selenium+Python自动测试或爬虫中的常见定位方法.鼠标操作.键盘操作介绍,希望该篇基础性文章对你有所帮助,如果有错误或不足之处,请海涵~同时CSDN总是屏蔽这篇文章,再加上最近 ...
- Python爬虫-selenium的使用(2)
使用selenium打开chrome浏览器百度进行搜索 12345678910111213141516171819202122232425 from selenium import webdriver ...
- [Python爬虫] Selenium获取百度百科旅游景点的InfoBox消息盒
前面我讲述过如何通过BeautifulSoup获取维基百科的消息盒,同样可以通过Spider获取网站内容,最近学习了Selenium+Phantomjs后,准备利用它们获取百度百科的旅游景点消息盒(I ...
- [python爬虫] Selenium常见元素定位方法和操作的学习介绍(转载)
转载地址:[python爬虫] Selenium常见元素定位方法和操作的学习介绍 一. 定位元素方法 官网地址:http://selenium-python.readthedocs.org/locat ...
随机推荐
- 【a602】最大乘积
Time Limit: 1 second Memory Limit: 32 MB [问题描述] 一个正整数一般可以分为几个互不相同的自然数的,如3=1+2,4=1+3,5=1+4=2+3,6=1+5= ...
- 如何理解springMVC?
springMVC 工作原理? 简单理解:客户端发送请求-->前端控制器接受客户端的请求DispathServelt-->找到处理器映射HandMapping-->找到处理器hand ...
- 测试驱动开发实践—从testList开始
[内容指引]运行单元测试:装配一条数据:模拟更多数据测试列表:测试无搜索列表:测试标准查询:测试高级查询. 一.运行单元测试 我们以文档分类(Category)这个领域类为例,示范如何通过编写测试用例 ...
- redisUtil
package com.cinc.ecmp.utils; import org.springframework.beans.factory.annotation.Autowired; import o ...
- [HNOI2019]白兔之舞
memset0 多合一无聊题 mod k=t,并且k是p-1的约数 单位根反演石锤了. 所以直接设f[i]表示走i步的方案数, 然后C(L,i)分配位置,再A^i进行矩乘得到f[i] 变成生成函数F( ...
- Crazy Binary String<Map法>
#include<cstdio> #include<iostream> #include<map> using namespace std; map<int, ...
- Github Pages 无法调用 node_modules 文件夹的解决方案
今天写一个demo,用npm安装的前端库,然后想在github的pages上展示出来 发布到github后,发现node_modules文件夹下的js无法调用 google解决方案:新增一个名字为.n ...
- 僵进程与SIGCHLD信号
参考: https://www.cnblogs.com/webor2006/p/4014586.html wait()和waitpid()的参数解析:https://blog.csdn.net/csd ...
- background新增属性
今天解除了几个曾经没有用到的属性,所以想总结并且复习一下. background-origin属性:有三个属性值,分别是border-box,padding-box,content-box.看到bor ...
- 异步加载css 和 谷歌浏览器各实用小工具介绍
异步加载css资源 加开页面首屏显示速度使我们前端一直在追求的目标,而css资源在这些优化中同样也是不可或缺的. 一个网站可能有一部分css资源是必须的,他需要在页面渲染完之前就被加载完,并和html ...