
python 皮尔森相关系数
皮尔森理解
皮尔森相关系数(Pearson correlation coefficient)也称皮尔森积矩相关系数(Pearson product-moment correlation coefficient) ,是一种线性相关系数。皮尔森相关系数是用来反映两个变量线性相关程度的统计量。相关系数用r表示,其中n为样本量,分别为两个变量的观测值和均值。r描述的是两个变量间线性相关强弱的程度。r的绝对值越大表明相关性越强。
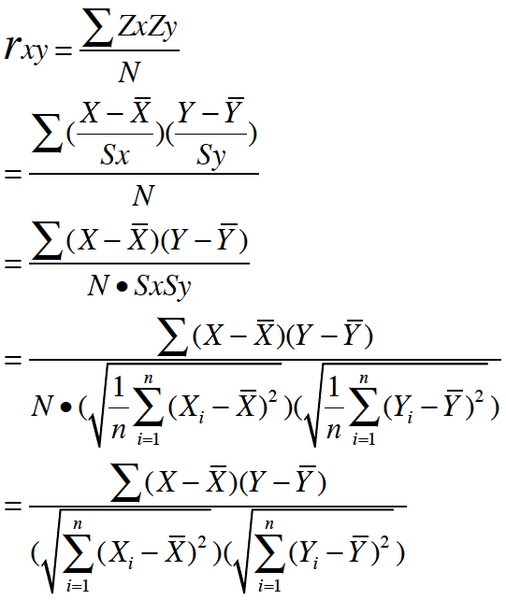
简单的相关系数的分类
- 0.8-1.0 极强相关
- 0.6-0.8 强相关
- 0.4-0.6 中等程度相关
- 0.2-0.4 弱相关
- 0.0-0.2 极弱相关或无相关
r描述的是两个变量间线性相关强弱的程度。r的取值在-1与+1之间,若r>0,表明两个变量是正相关,即一个变量的值越大,另一个变量的值也会越大;若r<0,表明两个变量是负相关,即一个变量的值越大另一个变量的值反而会越小。r 的绝对值越大表明相关性越强,要注意的是这里并不存在因果关系。
python 实现
# encoding:utf-8
import pandas as pd
from pandas import DataFrame
import matplotlib.pyplot as plot
import math
#target_url = ("https://archive.ics.uci.edu/ml/machine-learning-databases/undocumented/connectionist-bench/sonar/sonar.all-data")
#rockVMines = pd.read_csv(target_url ,header=None,prefix="V") #prefix前缀
rockVMines = pd.read_csv('../rockdata.txt',header=None,prefix="V")  #prefix前缀
row2 = rockVMines.iloc[1,0:60]
row3 = rockVMines.iloc[2,0:60]
n = len(row2)
mean2 =  row2.mean()
mean3 =  row3.mean()
t2=0 ; t3=0;t1=0
for i in range(n):
    t2 += (row2[i] - mean2) * (row2[i] - mean2) / n
    t3 += (row3[i] - mean3) * (row3[i] - mean3) / n
r23=0
for i in range(n):
    r23 += (row2[i] - mean2)*(row3[i] - mean3)/(n* math.sqrt(t2 * t3))
print r23
corMat = DataFrame(rockVMines.corr())  #corr 求相关系数矩阵
print corMat
plot.pcolor(corMat)
plot.show()
python 皮尔森相关系数的更多相关文章
- Spearman秩相关系数和Pearson皮尔森相关系数
1.Pearson皮尔森相关系数 皮尔森相关系数也叫皮尔森积差相关系数,用来反映两个变量之间相似程度的统计量.或者说用来表示两个向量的相似度. 皮尔森相关系数计算公式如下:
- 【ML基础】皮尔森相关系数(Pearson correlation coefficient)
前言 参考 1. 皮尔森相关系数(Pearson correlation coefficient): 完
- spark MLlib 概念 1:相关系数( PPMCC or PCC or Pearson's r皮尔森相关系数) and Spearman's correlation(史匹曼等级相关系数)
皮尔森相关系数定义: 协方差与标准差乘积的商. Pearson's correlation coefficient when applied to a population is commonly r ...
- 相关性系数及其python实现
参考文献: 1.python 皮尔森相关系数 https://www.cnblogs.com/lxnz/p/7098954.html 2.统计学之三大相关性系数(pearson.spearman.ke ...
- 《Spark Python API 官方文档中文版》 之 pyspark.sql (二)
摘要:在Spark开发中,由于需要用Python实现,发现API与Scala的略有不同,而Python API的中文资料相对很少.每次去查英文版API的说明相对比较慢,还是中文版比较容易get到所需, ...
- python 推荐算法
每个人都会有这样的经历:当你在电商网站购物时,你会看到天猫给你弹出的“和你买了同样物品的人还买了XXX”的信息:当你在SNS社交网站闲逛时,也会看到弹出的“你可能认识XXX“的信息:你在微博添加关注人 ...
- 《Spark Python API 官方文档中文版》 之 pyspark.sql (四)
摘要:在Spark开发中,由于需要用Python实现,发现API与Scala的略有不同,而Python API的中文资料相对很少.每次去查英文版API的说明相对比较慢,还是中文版比较容易get到所需, ...
- 《Spark Python API 官方文档中文版》 之 pyspark.sql (三)
摘要:在Spark开发中,由于需要用Python实现,发现API与Scala的略有不同,而Python API的中文资料相对很少.每次去查英文版API的说明相对比较慢,还是中文版比较容易get到所需, ...
- Python金融量化
Python股票数据分析 最近在学习基于python的股票数据分析,其中主要用到了tushare和seaborn.tushare是一款财经类数据接口包,国内的股票数据还是比较全的 官网地址:http: ...
随机推荐
- 转载->C#中的委托的使用和讲解
C# 中的委托 引言 委托 和 事件在 .Net Framework中的应用非常广泛,然而,较好地理解委托和事件对很多接触C#时间不长的人来说并不容易.它们就像是一道槛儿,过了这个槛的人,觉得真是太容 ...
- 异构GoldenGate 12c 单向复制配置
1.分别在windows2008.linux平台部署oracle 11.2.0.4 2.分别在windows2008.linux平台部署gg. 2.1 windows平台: gg的安装目录位 C:\o ...
- LeetCode 25 Reverse Nodes in k-Group Add to List (划分list为k组)
题目链接: https://leetcode.com/problems/reverse-nodes-in-k-group/?tab=Description Problem :将一个有序list划分 ...
- 使用jetty的continuations实现"服务器推"
在实际的开发中,我们可能会有这样的场景:许多客户端都连接到服务器端,当有某个客户端的消息的时候,服务器端会主动"推"消息给客户端,手机app的推送是一个典型的场景(IOS的推送都是 ...
- Asp.Net MVC大型项目实践整合 NHibernate与Json序列化
通过NHibernate我们多表查询是实现了 但由于查询出来的集合中的对象“不是平的”,如何在送到UI绑定成了问题.ExtJs UI组件的数据绑定支持多种格式,如简单数组,Json,Xml.在本项目中 ...
- Gradle gitignore Gradle 模式 上传SVN 要忽略的文件
.gradle /local.properties /.idea/workspace.xml /.idea/libraries .DS_Store /build /captures /.idea *. ...
- vue--获取监听获取radius的改变
做一个考试系统,单选题都是后台来的数据,所以一时间没有想到 @change这个方法: <template> <div id="Home"> <v-he ...
- Spark2 Dataset之collect_set与collect_list
collect_set去除重复元素:collect_list不去除重复元素select gender, concat_ws(',', collect_set(children)), ...
- Elasticsearch 与 Mongodb 数据同步问题
1.mongo-connector工具 首先安装python环境 wget http://www.python.org/ftp/python/3.0.1/Python-3.0.1.tgz tar -z ...
- HDU 2993 - MAX Average Problem - [斜率DP]
题目链接:http://acm.hdu.edu.cn/showproblem.php?pid=2993 Consider a simple sequence which only contains p ...