
node实现缓存
内容:
1.缓存基本原理
2.node实现缓存
1.缓存基本原理
第一重要、缓存策略:
- cache-control:用于控制缓存,常见的取值有private、no-cache、max-age、must-revalidate等,默认为private
- expires:失效时间
第二重要、缓存实现过程:
- 第一次Server->Client:"Last-Modified: Sat, 02 Dec 2017 04:03:14 GMT" --> 服务端告诉客户端资源修改的时间
- 第二次Client->Server:"If-Modified-Since: Sat, 02 Dec 2017 04:03:14 GMT" --> 浏览器告诉服务器自己缓存的资源的修改时间
- 第二次Server->Client:200 || 304 --> 服务器根据两者时间是否相同决定返回200(返回新资源)还是304(叫浏览器用自己缓存的资源)
注意:
- cookie不属于缓存!
- 关于localstorage:https://www.cnblogs.com/st-leslie/p/5617130.html
2.node实现缓存
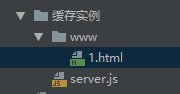
源码:
 const http=require('http');

 const fs=require('fs');

 const url=require('url');

 // 连续两次访问:  http://localhost:8080/1.html    第一次是200  第二次是304

 http.createServer((req, res)=>{

     let {pathname}=url.parse(req.url);

     //获取文件日期

     fs.stat(`www${pathname}`, (err, stat)=>{

         if(err){

             res.writeHeader(404);

             res.write('Not Found');

             res.end();

         }else{

             // 请求头中有if-modified-since -> 不是第一次请求,之前浏览器中缓存了该页面

             if(req.headers['if-modified-since']){

                 let oDate=new Date(req.headers['if-modified-since']);

                 let time_client=Math.floor(oDate.getTime()/1000);

                 let time_server=Math.floor(stat.mtime.getTime()/1000);

                 if(time_server>time_client){      // 服务器的文件时间 > 客户端手里的版本

                     sendFileToClient();

                 }else{

                     res.writeHeader(304);

                     res.write('Not Modified');

                     res.end();

                 }

             }

             // 请求头中没有if-modified-since -> 第一次请求 -> 直接返回要的文件

             else{

                 sendFileToClient();

             }

             // 直接返回文件

             function sendFileToClient(){

                 //发送

                 let rs=fs.createReadStream(`www${pathname}`);

                 res.setHeader('Last-Modified', stat.mtime.toGMTString());

                 //输出

                 rs.pipe(res);

                 rs.on('error', function(err){

                     res.writeHeader(404);

                     res.write('Not Found');

                     res.end();

                 });

             }

         }

     });

 }).listen(8080);
原理:
- 服务端第一次向客户端发送资源时设置文件修改时间:setHeader('Last-Modified', stat.mtime.toGMTString())
- 之后客户端向浏览器请求时服务端检查请求头中是否有if-modified-since:
- 如果有if-modified-since就判断服务器时间是否大于浏览器时间(若大于说明服务端文件已经修改就将新修改的文件返回,否则就返回304浏览器会直接使用原先缓存的资源)
- 如果没有if-modified-since就直接返回文件并像最上面那样设置文件修改时间
另外还可以设置缓存:
 // 具有缓存控制的服务器 --> 设置Cache-Control(no-cache)

 const http=require('http');

 const fs=require('fs');

 const url=require('url');

 // 连续两次访问:  http://localhost:8080/1.html    第一次是200  第二次是304

 http.createServer((req, res)=>{

     let {pathname}=url.parse(req.url);

     //获取文件日期

     fs.stat(`www${pathname}`, (err, stat)=>{

         if(err){

             res.writeHeader(404);

             res.write('Not Found');

             res.end();

         }else{

             // 请求头中有if-modified-since -> 不是第一次请求,之前浏览器中缓存了该页面

             if(req.headers['if-modified-since']){

                 let oDate=new Date(req.headers['if-modified-since']);

                 let time_client=Math.floor(oDate.getTime()/1000);

                 let time_server=Math.floor(stat.mtime.getTime()/1000);

                 if(time_server>time_client){      // 服务器的文件时间 > 客户端手里的版本

                     sendFileToClient();

                 }else{

                     res.writeHeader(304);

                     res.write('Not Modified');

                     res.end();

                 }

             }

             // 请求头中没有if-modified-since -> 第一次请求 -> 直接返回要的文件

             else{

                 sendFileToClient();

             }

             // 直接返回文件

             function sendFileToClient(){

                 //发送

                 let rs=fs.createReadStream(`www${pathname}`);

                 // 设置缓存

                 res.setHeader('Cache-Control', 'no-cache');

                 res.setHeader('Last-Modified', stat.mtime.toGMTString());

                 //输出

                 rs.pipe(res);

                 rs.on('error', function(err){

                     res.writeHeader(404);

                     res.write('Not Found');

                     res.end();

                 });

             }

         }

     });

 }).listen(8080);
node实现缓存的更多相关文章
- node.js缓存处理方式
Node.JS缓存处理分为客户端和服务端两个部分. 客户端的缓存主要是利用浏览器对HTTP协议响应头中cache-control和expires字段的支持.浏览器在得到明确的响应头后,会将文件缓存在本 ...
- Node.js缓存
Node.js Buffer(缓冲区) JavaScript 语言自身只有字符串数据类型,没有二进制数据类型. 但在处理像TCP流或文件流时,必须使用到二进制数据.因此在 Node.js中,定义了一个 ...
- 深入浅出node(2) 模块机制
这部分主要总结深入浅出Node.js的第二章 一)CommonJs 1.1CommonJs模块定义 二)Node的模块实现 2.1模块分类 2.2 路径分析和文件定位 2.2.1 路径分析 2.2.2 ...
- 缓存淘汰算法--LRU算法
1. LRU1.1. 原理 LRU(Least recently used,最近最少使用)算法根据数据的历史访问记录来进行淘汰数据,其核心思想是"如果数据最近被访问过,那么将来被访问的几率也 ...
- JavaScript实现TwoQueues缓存模型
本文所指TwoQueues缓存模型,是说数据在内存中的缓存模型. 无论何种语言,都可能需要把一部分数据放在内存中,避免重复运算.读取.最常见的场景就是JQuery选择器,有些Dom元素的选取是非常耗时 ...
- node学习笔记
一.准备(github地址) 什么是Javascript? ... Javascript能做什么? ..... 浏览器中的Javascript可以做什么? 操作DOM(增删改查) AJAX/跨域 BO ...
- JPA,EclipseLink 缓存机制学习(一) 树节点搜索问题引发的思考
最近在项目在使用JPA+EclipseLink 的方式进行开发,其中EclipseLink使用版本为2.5.1.遇到一些缓存方面使用不当造成的问题,从本篇开始逐步学习EclipseLink的缓存机制. ...
- 浅析LRU(K-V)缓存
LRU(Least Recently Used)算法是缓存技术中的一种常见思想,顾名思义,最近最少使用,也就是说有两个维度来衡量,一个是时间(最近),一个频率(最少).如果需要按优先级来对缓存中的K- ...
- Node.js的模块载入方式与机制
Node.js中模块可以通过文件路径或名字获取模块的引用.模块的引用会映射到一个js文件路径,除非它是一个Node内置模块.Node的内置模块公开了一些常用的API给开发者,并且它们在Node进程开始 ...
随机推荐
- Robust Tracking via Weakly Supervised Ranking SVM
参考文献:Yancheng Bai and Ming Tang. Robust Tracking via Weakly Supervised Ranking SVM Abstract 通常的算法:ut ...
- shell 脚本实战笔记(7)--集群网络相关知识和环境搭建
前言: 对网络相关的知识, 做下笔记. 包括IP地址A/B/C的分类, 静态地址的配置/DNS配置, 以及网卡相关信息查看. *) A/B/C/D类网络地址的划分 IP地址=网络地址+主机地址 或 I ...
- 用pthon来写个跳板机
用pthon来写个跳板机 1.需求 程序一:1.后台管理- 堡垒机上创建用户和密码(堡垒机root封装的类,UserProfile表)- .bashrc /usr/bin/python3 /dat ...
- python 取整
1.向下取整 向下取整直接用内建的 int() 函数即可: >>> a = 3.75 >>> int(a) 3 2.四舍五入 对数字进行四舍五入用 round() ...
- MySQL的innoDB锁机制以及死锁处理
MySQL的nnoDB锁机制 InnoDB与MyISAM的最大不同有两点:一是支持事务(TRANSACTION):二是采用了行级锁.行级锁与表级锁本来就有许多不同之处,innodb正常的select ...
- 实现多线程的方式之实现Callable接口
package com.hls.juc; import java.util.concurrent.Callable;import java.util.concurrent.ExecutionExcep ...
- RAC1——Clusterware概念简介1
一 集群环境下的一些特殊问题 1.1 并发控制 在集群环境中, 关键数据通常是共享存放的,比如放在共享磁盘上. 而各个节点的对数据有相同的访问权限, 这时就必须有某种机制能够控制节点对数据的访问. O ...
- Spring核心思想:“控制反转”,也叫“依赖注入” 的理解
@Service对应的是业务层Bean,例如: @Service("userService") public class UserServiceImpl implements Us ...
- npm 构建时,次要版本变化引起的问题
问题:下载项目后,运行 npm install 或 yarn install,vue-awesome-swiper 做的功能显示不正常. 解决:从 官方网站 文件 README.md 中找到: // ...
- 回归cnBlogs
一.最近的想法 最近几天看了好多IT和非IT朋友的技术博客和自媒体博客,本想自己搭建一个独立博客,查了好多资料,各种方法,比如:goDaddy购买域名,利用GitHub免费空间搭博客. ...