
【译】Kafka最佳实践 / Kafka Best Practices
本文来自于DataWorks Summit/Hadoop Summit上的《Apache Kafka最佳实践》分享,里面给出了很多关于Kafka的使用心得,非常值得一看,今推荐给大家。
硬件配置
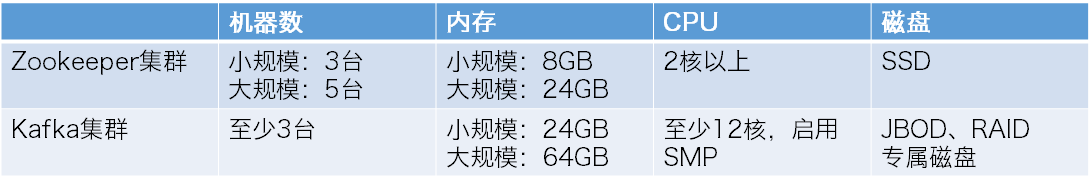
JBOD: Just bunch of disks,就是普通的一堆磁盘组成的集群
OS调优
磁盘调优
基本监控
如何监控备份不足情况发生?
JMX指标:kafka.server:type=ReplicaManager,name=UnderReplicatedPartitions
- broker挂了
- controller问题
- zk问题
- 网络问题
- 调整ISR参数,比如 min.insync.replica和replica.lag.time.max.ms, num.replica.fetchers
- 增加broker数
controller问题
- ISR抖动
- zk性能问题
- Long GC
- 网络问题
- kafka.controller:type=KafkaController,name=ActiveControllerCount应该=1
- 监控LeaderElectionRate
unclean leader选举
集群评估(sizing)
- 单broker上的分区数<2000
- 控制分区大小,不要超过25GB
- 磁盘使用率<60%
- 网络使用率<75%
- 确保topic分区分布尽量均匀
- 确保broker节点不会磁盘、带宽耗尽
broker监控
topic评估
- 至少和最大的消费者组中consumer的数量一致
- 分区不要太大,小于25GB
- 要考虑未来业务的扩容
选择分区
份额控制
Kafka producer
- batch.size: 越大,TPS越大,延时也越大
- linger.ms: 越大,TPS越大,延时也越大
- max.in.flight.requests.per.connection: 增加TPS,关乎消息接收顺序
- compression.type: 设置压缩类型,提升TPS
- acks: 设置消息持久性级别
性能调优
- 增加用户线程
- 增加batch size
- 使用多个producer实例
- 添加分区
监控指标
- batch-size-avg
- compression-rate-avg
- waiting-threads
- buffer-available-bytes
- record-queue-time-max
- record-send-rate
- records-per-request-avg
Kafka Consumer
- 分区数不够
- OS缓存命中太低,分配更多页缓存
- 处理逻辑过重
- fetch.min.bytes、fetch.max.wait.ms
- max.poll.interval.ms
- max.poll.records
- session.timeout.ms
监控
- 分析consumer,是GC问题还是consumer hang住了
- 增加consumer instances
- 增加分区数
无数据丢失配置
- retries = MAX
- acks=all
- max.in.flight.requests.per.connection = 1
- 关闭producer
- replication factor >= 3
- min.insync.replicas = 2
- 关闭unclean leader选举
- 关闭auto.offset.commit
- 消息被处理后提交位移
【译】Kafka最佳实践 / Kafka Best Practices的更多相关文章
- Kafka最佳实践
一.硬件考量 1.1.内存 不建议为kafka分配超过5g的heap,因为会消耗28-30g的文件系统缓存,而是考虑为kafka的读写预留充足的buffer.Buffer大小的快速计算方法是平均磁盘写 ...
- window下Kafka最佳实践
Kafka的介绍和入门请看这里kafka入门:简介.使用场景.设计原理.主要配置及集群搭建(转) 当前文章从实践的角度为大家规避window下使用的坑. 1.要求: java 6+ 2.下载kafka ...
- 【iOS10 SpeechRecognition】语音识别 现说现译的最佳实践
首先想强调一下“语音识别”四个字字面意义上的需求:用户说话然后马上把用户说的话转成文字显示!,这才是开发者真正需要的功能. 做需求之前其实是先谷歌百度一下看有没有造好的轮子直接用,结果真的很呵呵,都是 ...
- 【转】优化Web程序的最佳实践
自动排版有点乱,看着蛋疼,建议下载中文PDF版阅读或阅读英文原文. Yahoo!的Exceptional Performance团队为改善Web性能带来最佳实践.他们为此进行了 一系列的实验.开发了各 ...
- 大规模使用 Apache Kafka 的20个最佳实践
必读 | 大规模使用 Apache Kafka 的20个最佳实践 配图来源:书籍<深入理解Kafka> Apache Kafka是一款流行的分布式数据流平台,它已经广泛地被诸如New Re ...
- Apache Kafka: 优化部署的10个最佳实践
原文作者:Ben Bromhead 译者:江玮 原文地址:https://www.infoq.com/articles/apache-kafka-best-practices-to-opti ...
- Kafka在大型应用中的 20 项最佳实践
原标题:Kafka如何做到1秒处理1500万条消息? Apache Kafka 是一款流行的分布式数据流平台,它已经广泛地被诸如 New Relic(数据智能平台).Uber.Square(移动支付公 ...
- Spring Boot 自定义kafka 消费者配置 ContainerFactory最佳实践
Spring Boot 自定义kafka 消费者配置 ContainerFactory最佳实践 本篇博文主要提供一个在 SpringBoot 中自定义 kafka配置的实践,想象这样一个场景:你的系统 ...
- JavaScript初学者应知的24条最佳实践(译)
原文:24 JavaScript Best Practices for Beginners 译者:youngsterxyf (注:阅读原文的时候没有注意发布日期,觉得不错就翻译了,翻译到JSON.pa ...
随机推荐
- 关于Unity中常用的数据结构和JSON处理(专题三)
数据结构通俗来讲就是用某个对象去存储数据集合,比如要存储100个整数,要用什么样的数据类型能把它们存储好. Jason处理,服务器对接,配置文件的使用,Unity和Jason之间相互的转换. Arra ...
- 关于Unity中的刚体和碰撞器的相关用法(二)
在关于Unity中的刚体和碰撞器的相关用法(一)的基础上 有一个plane平面,一个ball球体,都挂了碰撞器,ball挂了刚体Rigidbody,写了一个脚本ball挂载在球体上,球体从空中落下装机 ...
- Airtest 网易 UI 自动化工具 Airtest 浅用记录
一 使用目的 该工具主要是面向游戏UI测试基于图像识别,如游戏框架unity,Cocos-js以及网易内部的游戏框架同时也支持原生Android App 的基于元素识别的UI自动化测试.本文主要使用目 ...
- linux下硬盘的分区:
提到硬盘的分区,以前就是很乱,有什么主分区/扩展分区/逻辑分区等;它们有什么区别呢?现在简单的了解一下: 由于在MBR的主引导记录中的分区表里面最多只能记录4个分区记录,这个不够用啊,为了解决这个问题 ...
- C# 中委托和代理是一个概念吗??
刚刚看了一下资料,发现有些资料说的是代理,有的说是委托,但都是指同一样东西delegate,委托和事件是有关的,因为事件的本质就是多播委托,关于多播委托楼主可以找找资料就知道了. 不过个人觉得这两个概 ...
- C#中按模板操作Word —— 如何向Word中插入图片
一.Word对象模型的重叠性分析 本文主要介绍通过书签Bookmark向Word文档中插入图片的方法.在此之前我们先简单讨论下Word对象模型的重叠性.如果你对Word对象模型还不熟悉,请参考本专栏第 ...
- Shell脚本中的export
shell 与 export命令 用户登录到Linux系统后,系统将启动一个用户shell.在这个shell中,可以使用shell命令 或声明变量,也可以创建并运行shell脚本程序.运行shell脚 ...
- perl 中的引用
perl 语言中的引用共分为两类: 声明引用时只需要在对象的前面加上反斜杠 第一列是数组的引用: 代码示例: , , ); my $array_ref = \@array; 第二种是哈希的引用 代码示 ...
- oracle转mysql总结
oracle转mysql总结 ares-sdk初始开发测试使用的是oracle数据库,由于宁波通商的特殊需要,必须把数据库环境从oracle转向mysql. 现对转换过程中出现的问题及经验总结如下: ...
- iOS:ODRefreshControl
https://github.com/Sephiroth87/ODRefreshControl Important note if your project doesn’t use ARC: you ...