
SVM面试知识点总结
1. SVM 原理
SVM 是一种二类分类模型。它的基本思想是在特征空间中寻找间隔最大的分离超平面使数据得到高效的二分类,具体来讲,有三种情况(不加核函数的话就是个线性模型,加了之后才会升级为一个非线性模型):
- 当训练样本线性可分时,通过硬间隔最大化,学习一个线性分类器,即线性可分支持向量机;
- 当训练数据近似线性可分时,引入松弛变量,通过软间隔最大化,学习一个线性分类器,即线性支持向量机;
- 当训练数据线性不可分时,通过使用核技巧及软间隔最大化,学习非线性支持向量机。
2. SVM 为什么采用间隔最大化(与感知机的区别):
当训练数据线性可分时,存在无穷个分离超平面可以将两类数据正确分开。感知机利用误分类最小策略,求得分离超平面,不过此时的解有无穷多个。线性可分支持向量机利用间隔最大化求得最优分离超平面,这时,解是唯一的。另一方面,此时的分隔超平面所产生的分类结果是最鲁棒的,对未知实例的泛化能力最强。
3. 为什么要将求解 SVM 的原始问题转换为其对偶问题
- 一是对偶问题往往更易求解,当我们寻找约束存在时的最优点的时候,约束的存在虽然减小了需要搜寻的范围,但是却使问题变得更加复杂。为了使问题变得易于处理,我们的方法是把目标函数和约束全部融入一个新的函数,即拉格朗日函数,再通过这个函数来寻找最优点。
- 二是可以自然引入核函数,进而推广到非线性分类问题。
4. 为什么 SVM 要引入核函数
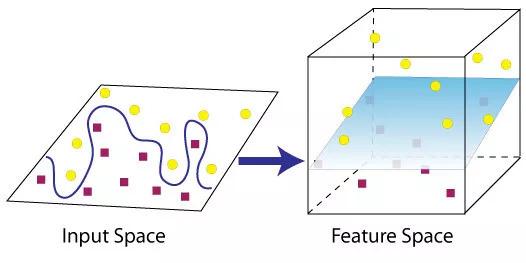
当样本在原始空间线性不可分时,可将样本从原始空间映射到一个更高维的特征空间,使得样本在这个特征空间内线性可分。而引入这样的映射后,所要求解的对偶问题的求解中,无需求解真正的映射函数,而只需要知道其核函数。核函数的定义:K(x,y)=<ϕ(x),ϕ(y)>,即在特征空间的内积等于它们在原始样本空间中通过核函数 K 计算的结果。一方面数据变成了高维空间中线性可分的数据,另一方面不需要求解具体的映射函数,只需要给定具体的核函数即可,这样使得求解的难度大大降低。
用自己的话说就是,在SVM不论是硬间隔还是软间隔在计算过程中,都有X转置点积X,若X的维度低一点还好算,但当我们想把X从低维映射到高维的时候(让数据变得线性可分时),这一步计算很困难,等于说在计算时,需要先计算把X映射到高维的的ϕ(x),再计算ϕ(x1)和ϕ(x2)的点积,这一步计算起来开销很大,难度也很大,此时引入核函数,这两步的计算便成了一步计算,即只需把两个x带入核函数,计算核函数,举个列子一目了然:
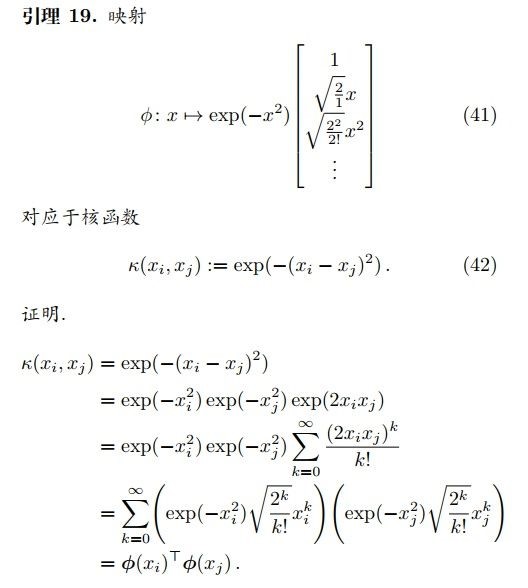
个人对核函数的理解:核函数就是一个函数,接收两个变量,这两个变量是在低维空间中的变量,而核函数求的值等于将两个低维空间中的向量映射到高维空间后的内积。
5. 为什么SVM对缺失数据敏感
这里说的缺失数据是指缺失某些特征数据,向量数据不完整。SVM 没有处理缺失值的策略。而 SVM 希望样本在特征空间中线性可分,所以特征空间的好坏对SVM的性能很重要。缺失特征数据将影响训练结果的好坏。
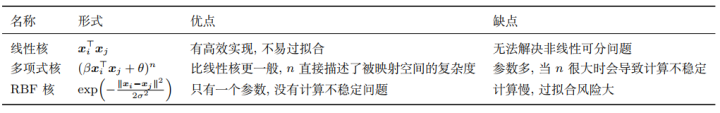
6. 如何选择核函数:
- 当特征维数 d 超过样本数 m 时 (文本分类问题通常是这种情况), 使用线性核;
- 当特征维数 d 比较小. 样本数 m 中等时, 使用RBF核;
- 当特征维数 d 比较小. 样本数 m 特别大时, 支持向量机性能通常不如深度神经网络
7. SVM的目标(硬间隔):
有两个目标:第一个是使间隔最大化,第二个是使样本正确分类,由此推出目标函数:
稍微解释一下,w是超平面参数,目标一是从点到面的距离公式化简来的,具体不展开,目标二就相当于感知机,只是把大于等于0进行缩放变成了大于等于1,为了后面的推导方便。有了两个目标,写在一起,就变成了svm的终极目标:
8. 求解目标(硬间隔):
从上面的公式看出,这是一个有约束条件的最优化问题,用拉格朗日函数来解决。
上式的拉格朗日函数为:
在满足Slater定理的时候,且过程满足KKT条件的时候,原问题转换成对偶问题:
先求内部最小值,对 和
求偏导并令其等于
可得:
将其代入到上式中去可得到
此时需要求解 ,利用SMO(序列最小优化)算法:
SMO算法的基本思路是每次选择两个变量和
,选取的两个变量所对应的样本之间间隔要尽可能大,因为这样更新会带给目标函数值更大的变化。SMO算法之所以高效,是因为仅优化两个参数的过程实际上仅有一个约束条件,其中一个可由另一个表示,这样的二次规划问题具有闭式解。
9. 软间隔:
不管直接在原特征空间,还是在映射的高维空间,我们都假设样本是线性可分的。虽然理论上我们总能找到一个高维映射使数据线性可分,但在实际任务中,寻找一个合适的核函数核很困难。此外,由于数据通常有噪声存在,一味追求数据线性可分可能会使模型陷入过拟合,因此,我们放宽对样本的要求,允许少量样本分类错误。这样的想法就意味着对目标函数的改变,之前推导的目标函数里不允许任何错误,并且让间隔最大,现在给之前的目标函数加上一个误差,就相当于允许原先的目标出错,引入松弛变量 ,公式变为:
那么这个松弛变量怎么计算呢,最开始试图用0,1损失去计算,但0,1损失函数并不连续,求最值时求导的时候不好求,所以引入合页损失(hinge loss):
函数图长这样:
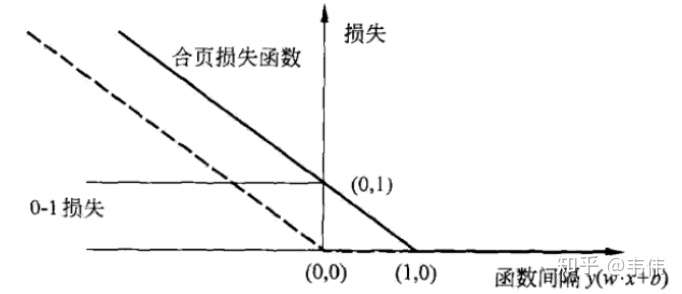
理解起来就是,原先制约条件是保证所有样本分类正确, ,现在出现错误的时候,一定是这个式子不被满足了,即
,衡量一下错了多少呢?因为左边一定小于1,那就跟1比较,因为1是边界,所以用1减去
来衡量错误了多少,所以目标变为(正确分类的话损失为0,错误的话付出代价):
但这个代价需要一个控制的因子,引入C>0,惩罚参数,即:
可以想象,C越大说明把错误放的越大,说明对错误的容忍度就小,反之亦然。当C无穷大时,就变成一点错误都不能容忍,即变成硬间隔。实际应用时我们要合理选取C,C越小越容易欠拟合,C越大越容易过拟合。
所以软间隔的目标函数为:
其中:
10. 软间隔求解:
与硬间隔类似:
上式的拉格朗日函数为:
在满足Slater定理的时候,且过程满足KKT条件的时候,原问题转换成对偶问题:
先求内部最小值,对 ,
和
求偏导并令其等于
可得:
将其代入到上式中去可得到,注意 被消掉了:
此时需要求解 ,同样利用SMO(序列最小优化)算法。
11. 关于支持向量的问题:
1.先说硬间隔:
先看KKT条件
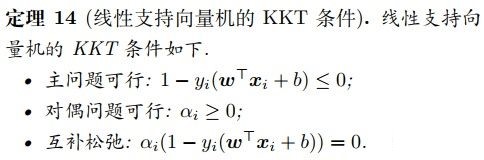
支持向量,对偶变量 αi > 0 对应的样本;
- 线性支持向量机中, 支持向量是距离划分超平面最近的样本, 落在最大间隔边界上。
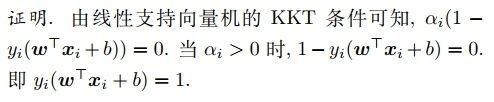
- 支持向量机的参数 (w; b) 仅由支持向量决定, 与其他样本无关。

2. 再说软间隔:
先看kkt条件:
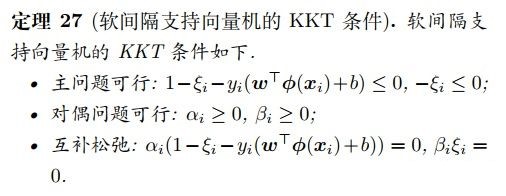
经过SMO后,求得 ,
。
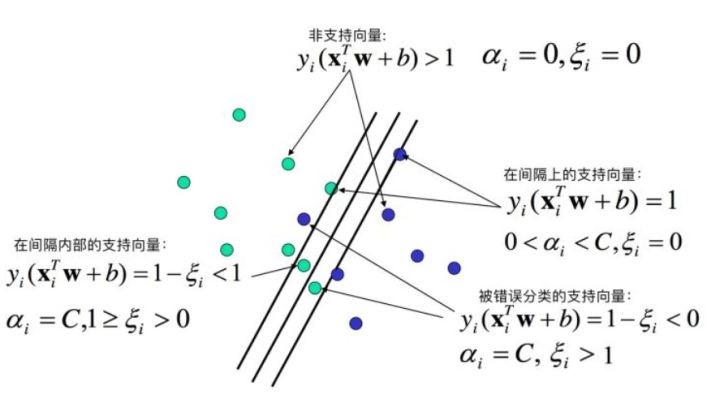
对于任意样本,
若
,此样本点不是支持向量,该样本对模型没有任何的作用
若,此样本是一个支持向量(同硬间隔)
若满足,进一步地,
- 若
, 则
,即刚好
,样本恰好在最大间隔边界上
- 若
,有
,此时若
则该样本落在最大间隔内部
- 若
则该样本落在最大间隔内部(不属于自己的另一部分)即被错误分类
如图:
12. 谈谈SVM的损失函数:
此处说的是软间隔:
先看软间隔的基本型形式:
稍微做一点变化:
这样写是为了符合标准的损失函数+正则化的样子,其中, 第一项称为经验风险, 度量了模型对训练数据的拟合程度; 第二项称为结构风险, 也称为正则化项, 度量 了模型自身的复杂度. 正则化项削减了假设空间, 从而 降低过拟合风险. λ 是个可调节的超参数, 用于权衡经验风险和结构风险.
其中:
这样的话给上式乘以mc,就会变成上上式了。
13. SVM的优缺点:
优点:
- 由于SVM是一个凸优化问题,所以求得的解一定是全局最优而不是局部最优。
- 不仅适用于线性线性问题还适用于非线性问题(用核技巧)。
- 拥有高维样本空间的数据也能用SVM,这是因为数据集的复杂度只取决于支持向量而不是数据集的维度,这在某种意义上避免了“维数灾难”。
- 理论基础比较完善(例如神经网络就更像一个黑盒子)。
缺点:
- 二次规划问题求解将涉及m阶矩阵的计算(m为样本的个数), 因此SVM不适用于超大数据集。(SMO算法可以缓解这个问题)
- 只适用于二分类问题。(SVM的推广SVR也适用于回归问题;可以通过多个SVM的组合来解决多分类问题)
参考文献:https://zhuanlan.zhihu.com/p/76946313
SVM面试知识点总结的更多相关文章
- 前端开发面试知识点大纲--摘自jackyWHJ
前端开发面试知识点大纲:HTML&CSS: 对Web标准的理解.浏览器内核差异.兼容性.hack.CSS基本功:布局.盒子模型.选择器优先级及使用.HTML5.CSS3.移动端适应 Ja ...
- Java---常用基础面试知识点
综合网上的一点资源,给大家整理了一些Java常用的基础面试知识点,希望能帮助到刚开始学习或正在学习的学员. 1.抽象 抽象就是忽略一个主题中与当前目标无关的那些方面,以便更充分地注意与当前目标有关的方 ...
- 知名互联网公司校招 Java 开发岗面试知识点解析
天之道,损有余而补不足,是故虚胜实,不足胜有余. 本文作者在一年之内参加过多场面试,应聘岗位均为 Java 开发方向.在不断的面试中,分类总结了 Java 开发岗位面试中的一些知识点. 主要包括以下几 ...
- Java web 前端面试知识点总结
经过几家大厂面试,目前成功拿到唯品会offer,分享一下我的面试知识点总结: 耦合性:也称块间联系.指软件系统结构中各模块间相互联系紧密程度的一种度量.模块之间联系越紧密,其耦合性就越强,模块的独立性 ...
- Java 面试知识点解析(一)——基础知识篇
前言: 在遨游了一番 Java Web 的世界之后,发现了自己的一些缺失,所以就着一篇深度好文:知名互联网公司校招 Java 开发岗面试知识点解析 ,来好好的对 Java 知识点进行复习和学习一番,大 ...
- Java 面试知识点解析(二)——高并发编程篇
前言: 在遨游了一番 Java Web 的世界之后,发现了自己的一些缺失,所以就着一篇深度好文:知名互联网公司校招 Java 开发岗面试知识点解析 ,来好好的对 Java 知识点进行复习和学习一番,大 ...
- Java 面试知识点解析(三)——JVM篇
前言: 在遨游了一番 Java Web 的世界之后,发现了自己的一些缺失,所以就着一篇深度好文:知名互联网公司校招 Java 开发岗面试知识点解析 ,来好好的对 Java 知识点进行复习和学习一番,大 ...
- Java 面试知识点解析(四)——版本特性篇
前言: 在遨游了一番 Java Web 的世界之后,发现了自己的一些缺失,所以就着一篇深度好文:知名互联网公司校招 Java 开发岗面试知识点解析 ,来好好的对 Java 知识点进行复习和学习一番,大 ...
- Java 面试知识点解析(五)——网络协议篇
前言: 在遨游了一番 Java Web 的世界之后,发现了自己的一些缺失,所以就着一篇深度好文:知名互联网公司校招 Java 开发岗面试知识点解析 ,来好好的对 Java 知识点进行复习和学习一番,大 ...
随机推荐
- 【LeetCode】75-颜色分类
题目描述 给定一个包含红色.白色和蓝色,一共 n 个元素的数组,原地对它们进行排序,使得相同颜色的元素相邻,并按照红色.白色.蓝色顺序排列. 此题中,我们使用整数 0. 1 和 2 分别表示红色.白色 ...
- 字符串和Date互相转化
话不多说,上程序,如图: public class TestDate { public static void main(String[] args) throws ParseException { ...
- HashMap面试必问的数据结构相关知识
如果在看这篇文章时,对HashMap的结构还不是很了解,建议你参考前段时间写的<刨死你系列——HashMap剖析(基于jdk1.8)>,可能会对下面的提及到知识点有些帮助. 1:HashM ...
- json-lib包引入失败的解决方法
要想使用json-lib的依赖必须加入<classifier>jdk15</classifier> 这一行,否则就导入依赖时就会失败报错,下载不下来jar包,因为json-li ...
- 秒杀活动是否适合O2O生鲜行业的思考
一.命题提出背景 公司是O2O生鲜行业,公司的业务部门提出要做秒杀活动.产品负责人听到后说没意义,秒杀不适合O2O生鲜.(产品负责人据说是阿里出来的P8,后来去微信,去永辉带运营.研发,做大佬,再后来 ...
- 来几道水题 d050: 妳那裡現在幾點了?
减去15即可(注意这个数小于15的情况) 题目:珊珊到了美国犹他州的杨百翰大学之后,文文禁不住对她的思念,常常想打电话给她,却又担心在美国的她是不是在睡觉.好不容易鼓起勇气打通了电话,第一句就先问:「 ...
- Servlet控制台输出乱码问题
在如下图的配置页面: 在此行添加编码格式:
- JAVA WEB中的Servlet过滤器
实现一个Servlet过滤器,可以对用户登录情况进行控制.要求如下: 1)访问路径是admin下的资源,需要登录,如果用户没有登录,自动转向用户登录页面.用户登录成功后,再次访问admin下的资源不需 ...
- android studio连接雷电模拟器 【AS 模拟器】
⭐ 我的网站: www.mengyingjie.com ⭐ Android studio 怎么连接安卓模拟器呢,跟着下面的步骤即可 (以雷电模拟器为例,其他模拟器类似) 一.下载模拟器 下载安装完雷电 ...
- Debezium SQL Server Source Connector+Kafka+Spark+MySQL 实时数据处理
写在前面 前段时间在实时获取SQLServer数据库变化时候,整个过程可谓是坎坷.然后就想在这里记录一下. 本文的技术栈: Debezium SQL Server Source Connector+K ...