
ETL hive update 之 deltamerge 优化
- full join 横向join ,不能map join 走shuffle
- row_number() over ( partition by 主键 order by $flag desc) rank ... where rank =1 ,走shufle
select

  id,

  order_datekey,

  f_procurement_order,

from

  (

    select

      id,

      order_datekey,

      f_procurement_order,

      row_number() over (

        partition by id

        order by

          b_flag_i desc

      ) rank

    from

      (

        select

          id,

          order_datekey,

          f_procurement_order,

          0 b_flag_i

        from

          ods_pms_procurement_order_item_hm old

        WHERE

          c_t >= 1479916800

          or u_t >= 1479916800

        union all

        select

          id,

          order_datekey,

          f_procurement_order,

          1 b_flag_i

        from

          ods_pms_procurement_order_item_hm_delta_64124FEADBFA9720 new

      ) t

  ) st

where

  rank = 1;
- 差集 + 并集方式 效率最高 前提是增量数据较少,要不也要走shuffle
# semi_1 数据 id , name

1       jx

2       gj

# semi_2数据id, age

1       28

3       30

select a.id,a.name from semi_1 a left anti join semi_2 b on a.id = b.id;

left anti join 是以左表为主,如果join上就返回null,否则返回左表数据。

2       gj
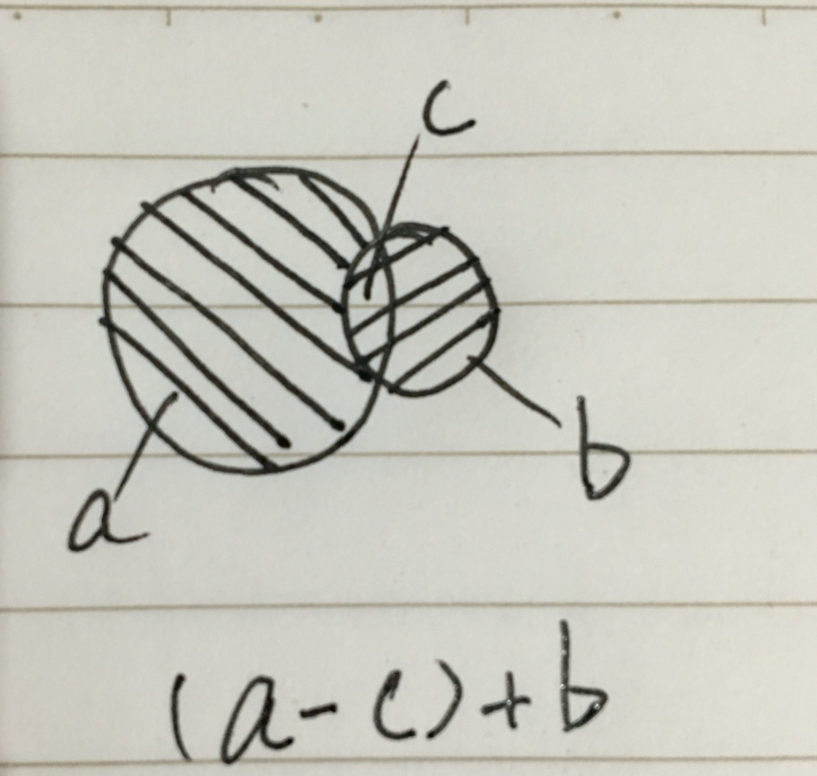
下图a代表完整old 全集,b代表完整new全集,c代表a与b join 上的交集部分(比如id相等的部分)所以思路就是(a-c)+b实现hive 的update
SET hive.mapred.mode=nonstrict;

INSERT overwrite TABLE $target.table

SELECT

  $stream.format

FROM

  $target.table old left anti

  join ($delta) new on $stream.unique_keys

UNION ALL

SELECT

  $stream.format

FROM

  $target.table ;
fields = 'id,name'

new = 'new'

old = 'old'

and_str = ' AND '

cmd = []

for field in fields.split(','):

    str = old + '.' + field + ' = ' + new + '.' + field

    cmd.append(str)

print and_str.join(cmd)
ETL hive update 之 deltamerge 优化的更多相关文章
- 写好Hive 程序的若干优化技巧和实际案例
使用Hive可以高效而又快速地编写复杂的MapReduce查询逻辑.但是一个”好”的Hive程序需要对Hive运行机制有深入的了解,像理解mapreduce作业一样理解Hive QL才能写出正确.高效 ...
- Hive性能分析和优化方法
Hive性能分析和优化方法 http://wenku.baidu.com/link?url=LVrnj-mD0OB69-eUH-0b2LGzc2SN76hjLVsGfCdYjV8ogyyN-BSja5 ...
- Hive使用Calcite CBO优化流程及SQL优化实战
目录 Hive SQL执行流程 Hive debug简单介绍 Hive SQL执行流程 Hive 使用Calcite优化 Hive Calcite优化流程 Hive Calcite使用细则 Hive向 ...
- hive中与hbase外部表join时内存溢出(hive处理mapjoin的优化器机制)
与hbase外部表(wizad_mdm_main)进行join出现问题: CREATE TABLE wizad_mdm_dev_lmj_edition_result as select * from ...
- hive查询注意及优化tips
Hive是将符合SQL语法的字符串解析生成可以在Hadoop上执行的MapReduce的工具.使用Hive尽量按照分布式计算的一些特点来设计sql,和传统关系型数据库有区别, 所以需要去掉原有关系型数 ...
- HIVE的几种优化
5 WAYS TO MAKE YOUR HIVE QUERIES RUN FASTER 今天看了一篇[文章] (http://zh.hortonworks.com/blog/5-ways-make-h ...
- hive 总结四(优化)
本文参考:黑泽君相关博客 本文是我总结日常工作中遇到的坑,结合黑泽君相关博客,选取.补充了部分内容. 表的优化 小表join大表.大表join小表 将key相对分散,并且数据量小的表放在join的左边 ...
- hive中笛卡尔积的优化
由于一个业务,必须要进行笛卡尔积,但是速度太慢了,left join时左表大概4万条数据,右表大概 3000多条数据,这样大概就是一亿多条数据, 这在大数据领域其实不算很大的数据量,但是hive中跑的 ...
- Hive参数层面常用优化
1.hive数据仓库权限问题: set hive.warehouse.subdir.inherit.perms=true; 2.HiveServer2的内存 连接的个数越多压力越大,可以加大内存:可以 ...
随机推荐
- window下为kibana安装x-pack时候出现Plugin installation was unsuccessful due to error "No valid url specified."错误的解决方案
在Windows环境下为kibana安装x-pack plugin的时候,按照官网提示的安装步骤执行命令: kibana-plugin install file:///E:/software/ELK/ ...
- Beff的学习
Beff介绍 BeEF,全称The Browser Exploitation Framework,是一款针对浏览器的渗透测试工具. 首先打开kali,直接点击beef图标打开beef 浏览器会默认弹出 ...
- 简单尝试利用维控LeviStudioU的一栈缓冲区溢出漏洞
这是别人给我发的,让我分析一下,看能否写出exp.只怪自己水平不够,最后没能写出exp,以下为自己的分析思路 环境为win10 pro x64 英文版(10.0.16299) 默认安全配置 一.漏洞分 ...
- Go - WaitGroup
package main import ( "fmt" "sync" ) //WaitGroup用于等待一组线程的结束.父线程调用Add方法来设定应等待的线程的 ...
- Python实例之抓取淘宝商品数据(json型数据)并保存为TXT
本实例实现了抓取淘宝网中以‘python’为关键字的搜索结果,经详细查看数据存储于html文档中的js脚本中,数据类型为JSON 具体实现代码如下: import requests import re ...
- ios-键盘回收
对输入的UITextField 控件设置完代理,然后粘上两种方法,即可. #pragma mark- 键盘收回 -(void)textFieldDidEndEditing:(UITextField * ...
- Iterator迭代器UML类图
ArrayList类中,实现了List接口的方法 List接口的方法 迭代器接口 ArrayList的内部类实现了这个[迭代器]接口
- python-闭包函数
在函数编程中经常用到闭包.闭包是什么,它是怎么产生的及用来解决什么问题呢.给出字面的定义先:闭包是由函数及其相关的引用环境组合而成的实体(即:闭包=函数+引用环境)(想想Erlang的外层函数传入一个 ...
- IntelliJ IDEA自动导入包去除星号(import xxx.*)
打开设置>Editor>Code Style>Java>Scheme Default>Imports ① 将Class count to use import with ...
- mysql用户管理及授权
以mariadb5.5版本为例 新建用户 登录mariadb # mysql -uroot -p Enter password: Welcome to the MariaDB monitor. Com ...