
Spark源码学习2
转自:http://www.cnblogs.com/hseagle/p/3673123.html
在源码阅读时,需要重点把握以下两大主线。
- 静态view 即 RDD, transformation and action
- 动态view 即 life of a job, 每一个job又分为多个stage,每一个stage中可以包含多个rdd及其transformation,这些stage又是如何映射成为task被distributed到cluster中
一、概要
本文以wordCount为例,详细说明spark创建和运行job的过程,重点是在进程及线程的创建。
二、实验环境搭建
在进行后续操作前,确保下列条件已满足。
- 下载spark binary 0.9.1
- 安装scala
- 安装sbt
- 安装java
三、启动spark-shell
3.1 单机模式运行,即local模式
local模式运行非常简单,只要运行以下命令即可,假设当前目录是$SPARK_HOME
MASTER=local bin/spark-shell
"MASTER=local"就是表明当前运行在单机模式
3.2 local cluster方式运行
local cluster模式是一种伪cluster模式,在单机环境下模拟standalone的集群,启动顺序分别如下
- 启动master
- 启动worker
- 启动spark-shell
3.3 master
$SPARK_HOME/sbin/start-master.sh
注意运行时的输出,日志默认保存在$SPARK_HOME/logs目录。
master主要是运行类 org.apache.spark.deploy.master.Master,在8080端口启动监听,日志如下图所示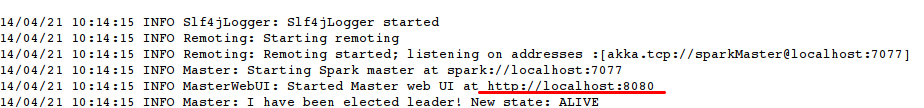
3.4 修改配置
- 进入$SPARK_HOME/conf目录
- 将spark-env.sh.template重命名为spark-env.sh
- 修改spark-env.sh,添加如下内容
export SPARK_MASTER_IP=localhost

export SPARK_LOCAL_IP=localhost
3.5 运行worker
bin/spark-class org.apache.spark.deploy.worker.Worker spark://localhost:7077 -i 127.0.0.1 -c 1 -m 512M
worker启动完成,连接到master。打开maser的web ui可以看到连接上来的worker. Master WEb UI的监听地址是http://localhost:8080
3.6 启动spark-shell
MASTER=spark://localhost:7077 bin/spark-shell
如果一切顺利,将看到下面的提示信息。
Created spark context..

Spark context available as sc.
可以用浏览器打开localhost:4040来查看如下内容
- stages
- storage
- environment
- executors
wordcount
上述环境准备妥当之后,我们在sparkshell中运行一下最简单的例子,在spark-shell中输入如下代码
scala>sc.textFile("README.md").filter(_.contains("Spark")).count
上述代码统计在README.md中含有Spark的行数有多少
四、部署过程详解
Spark布置环境中组件构成如下图所示。
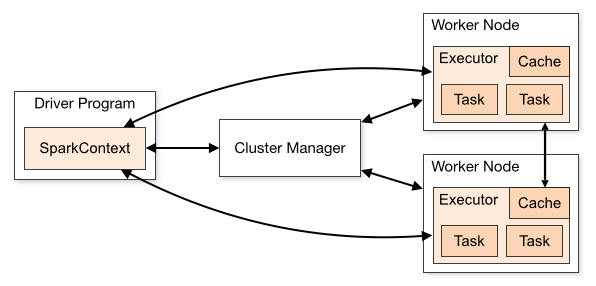
- Driver Program 简要来说在spark-shell中输入的wordcount语句对应于上图的Driver Program.
- Cluster Manager 就是对应于上面提到的master,主要起到deploy management的作用
- Worker Node 与Master相比,这是slave node。上面运行各个executor,executor可以对应于线程。executor处理两种基本的业务逻辑,一种就是driver programme,另一种就是job在提交之后拆分成各个stage,每个stage可以运行一到多个task
Notes: 在集群(cluster)方式下, Cluster Manager运行在一个jvm进程之中,而worker运行在另一个jvm进程中。在local cluster中,这些jvm进程都在同一台机器中,如果是真正的standalone或Mesos及Yarn集群,worker与master或分布于不同的主机之上。
五、JOB的生成和运行
job生成的简单流程如下
- 首先应用程序创建SparkContext的实例,如实例为sc
- 利用SparkContext的实例来创建生成RDD
- 经过一连串的transformation操作,原始的RDD转换成为其它类型的RDD
- 当action作用于转换之后RDD时,会调用SparkContext的runJob方法
- sc.runJob的调用是后面一连串反应的起点,关键性的跃变就发生在此处
调用路径大致如下
- sc.runJob->dagScheduler.runJob->submitJob
- DAGScheduler::submitJob会创建JobSummitted的event发送给内嵌类eventProcessActor
- eventProcessActor在接收到JobSubmmitted之后调用processEvent处理函数
- job到stage的转换,生成finalStage并提交运行,关键是调用submitStage
- 在submitStage中会计算stage之间的依赖关系,依赖关系分为宽依赖和窄依赖两种
- 如果计算中发现当前的stage没有任何依赖或者所有的依赖都已经准备完毕,则提交task
- 提交task是调用函数submitMissingTasks来完成
- task真正运行在哪个worker上面是由TaskScheduler来管理,也就是上面的submitMissingTasks会调用TaskScheduler::submitTasks
- TaskSchedulerImpl中会根据Spark的当前运行模式来创建相应的backend,如果是在单机运行则创建LocalBackend
- LocalBackend收到TaskSchedulerImpl传递进来的ReceiveOffers事件
- receiveOffers->executor.launchTask->TaskRunner.run
代码片段executor.lauchTask
 def launchTask(context: ExecutorBackend, taskId: Long, serializedTask: ByteBuffer) {

     val tr = new TaskRunner(context, taskId, serializedTask)

     runningTasks.put(taskId, tr)

     threadPool.execute(tr)

   }
说了这么一大通,也就是讲最终的逻辑处理切切实实是发生在TaskRunner这么一个executor之内,运算结果是包装成为MapStatus然后通过一系列的内部消息传递,反馈到DAGScheduler,这一个消息传递路径不是过于复杂,有兴趣可以自行勾勒
Spark源码学习2的更多相关文章
- Spark源码学习1.2——TaskSchedulerImpl.scala
许久没有写博客了,没有太多时间,最近陆续将Spark源码的一些阅读笔记传上,接下来要修改Spark源码了. 这个类继承于TaskScheduler类,重载了TaskScheduler中的大部分方法,是 ...
- Spark源码学习1.1——DAGScheduler.scala
本文以Spark1.1.0版本为基础. 经过前一段时间的学习,基本上能够对Spark的工作流程有一个了解,但是具体的细节还是需要阅读源码,而且后续的科研过程中也肯定要修改源码的,所以最近开始Spark ...
- spark源码学习-withScope
withScope是最近的发现版中新增加的一个模块,它是用来做DAG可视化的(DAG visualization on SparkUI) 以前的sparkUI中只有stage的执行情况,也就是说我们 ...
- Spark源码学习1.6——Executor.scala
Executor.scala 一.Executor类 首先判断本地性,获取slaves的host name(不是IP或者host: port),匹配运行环境为集群或者本地.如果不是本地执行,需要启动一 ...
- Spark源码学习1.5——BlockManager.scala
一.BlockResult类 该类用来表示返回的匹配的block及其相关的参数.共有三个参数: data:Iterator [Any]. readMethod: DataReadMethod.Valu ...
- Spark源码学习1.4——MapOutputTracker.scala
相关类:MapOutputTrackerMessage,GetMapOutputStatuses extends MapPutputTrackerMessage,StopMapOutputTracke ...
- Spark源码学习3
转自:http://www.cnblogs.com/hseagle/p/3673132.html 一.概要 本篇主要阐述在TaskRunner中执行的task其业务逻辑是如何被调用到的,另外试图讲清楚 ...
- Spark源码学习1
转自:http://www.cnblogs.com/hseagle/p/3664933.html 一.基本概念(Basic Concepts) RDD - resillient distributed ...
- Spark源码学习1.8——ShuffleBlockManager.scala
shuffleBlockManager继承于Logging,参数为blockManager和shuffleManager.shuffle文件有三个特性:shuffleId,整个shuffle stag ...
随机推荐
- oracle10G之前介质下载地址【珍藏版】
今天在互联网搜了一下相关介质下载,自己记录一下. Oracle9i Database Release 2 Enterprise/Standard/Personal Edition for Window ...
- SpringMVC中的异步提交表单
1.前言 近期在做一个项目,前台框架用的是EasyUI+SpringMVC,因为对SpringMVC不太了解,所以刚開始接触的时候有点吃力,在此通过一个EasyUi中的DataGrid表格来总结一下. ...
- ping操作
如何使用Ping命令 使用Ping命令检查网络故障方法 发布时间:2012-09-13 17:42 作者:电脑百事网原创 来源:www.pc841.com 53165次阅读 电脑百事网手机版:3g ...
- gulp简单使用小记
npm install --save-dev 写入package.json里 var gulp = require('gulp'); var less = require('gulp-less ...
- Mysql联合查询UNION和UNION ALL的使用介绍
UNION和UNION ALL的作用和语法 UNION 用于合并两个或多个 SELECT 语句的结果集,并消去表中任何重复行.UNION 内部的 SELECT 语句必须拥有相同数量的列,列也必须拥有相 ...
- JQuery表格展开与内容筛选
单击分类的时候,可以关闭打开相对应的内容.例如点击前台设计组,则只显示前台设计组的内容.再次点击则收缩. 筛选的话就是匹配输入框的内容,如果某行数据存在,则显示出来. <html> < ...
- function(ev) //括号里的ev是什么东西,什么意思?
事件对象: 楼上的不要误导新人 ev是我们获取事件详细信息的event是IE的写法 大多数人是写window.event 其实区别也差不多 好像window.event更安全些 我也不记得了 火狐呢 ...
- 黑马程序员-- C语言交换两个整数变量值几种函数比较
总结了C语言中几种交换两个整数数值的函数,欢迎交流 #include <stdio.h> 使用多种交换变量值的函数比较 方法一:使用第三方临时变量 这种函数a,b只是值传递,实质上不能修交 ...
- 汇编写下strcpy
#include <stdio.h> int main() { char *source = "hello world\n"; ] = {}; char *p = de ...
- html5test
html5test Github https://github.com/NielsLeenheer/html5test 主程序是 scripts/7/engine.js 目前看到的分类大部分是基于判断 ...