
java 爬虫:开源java爬虫 swing工具 Imgraber
1实现点:
- 1.返回给定URL网页内,所有图像url list
- 2.返回给定URL网页内,自动生成图像文件路径.txt 文件
- 3.返回给定URL网页内,下载txt文件指定的图片url,并将所有图像保存在 ./img文件夹下
- 4.实现简易swing 界面,有空再改造
2基于开源jsoup实现,鸣谢!
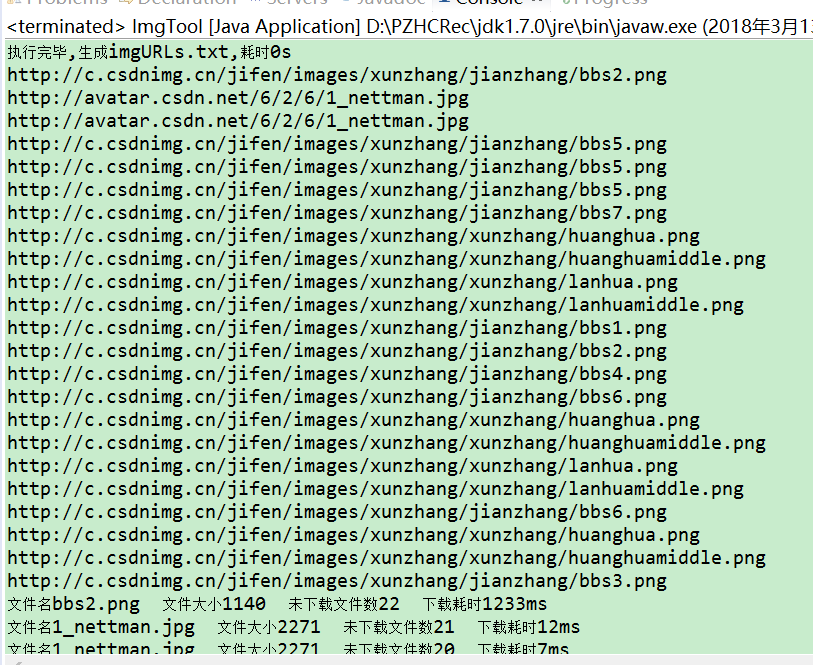
效果


github
package himi.crawler;

import java.io.BufferedInputStream;

import java.io.BufferedOutputStream;

import java.io.BufferedReader;

import java.io.BufferedWriter;

import java.io.File;

import java.io.FileOutputStream;

import java.io.FileReader;

import java.io.FileWriter;

import java.io.IOException;

import java.io.InputStream;

import java.io.OutputStream;

import java.net.HttpURLConnection;

import java.net.URL;

import java.util.ArrayList;

import java.util.List;

import java.util.regex.Matcher;

import java.util.regex.Pattern;

import org.jsoup.Jsoup;

import org.jsoup.helper.StringUtil;

import org.jsoup.nodes.Document;

import org.jsoup.select.Elements;

/**

 *

 * @ClassName: ImgTool

 * @Description:IMG tool ,请先赋值URL 获取指定ULR的某个网页里面

 * 					1.返回所有图像url list

 * 					2.图像文件夹路径.txt

 *                  3.所有图像保存在img文件夹里面

 * @author penny

 * @date 2018年3月7日 下午10:07:49

 *

 */

public class ImgTool {

	// 参数域

	/** 指定URL */

	public static String URL = "https://www.oschina.net";

	private int imgNumbs = 0;

	public static List<String> downloadMsg=new ArrayList<String>();

	public String imgUrlTxt = "imgURLs.txt";

	public static String regex= "^((https|http|ftp|rtsp|mms)?://)"

								+ "?(([0-9a-z_!~*'().&=+$%-]+: )?[0-9a-z_!~*'().&=+$%-]+@)?" //ftp的user@

								+ "(([0-9].)[0-9]" // IP形式的URL- 199.194.52.184

								+ "|" // 允许IP和DOMAIN(域名)

								+ "([0-9a-z_!~*'()-]+.)*" // 域名-

								+ "([0-9a-z][0-9a-z-])?[0-9a-z]." // 二级域名

								+ "[a-z])" // first level domain- .com or .museum

								+ "(:[0-9])?" // 端口- :80

								+ "((/?)|" // a slash isn't required if there is no file name

								+ "(/[0-9a-z_!~*'().;?:@&=+$,%#-]+)+/?)$";

	private ImgTool() {

	};

	private static ImgTool instance = new ImgTool();

	/** 获取ImgTool 单例 */

	public static ImgTool getInstance() {

		return instance;

	}

	public List<String> getURLs() {

		return getURLs(null);

	}

	public boolean isURL(String str) {

		if(StringUtil.isBlank(str)){

			return false;

		}else{

//		String regex = "^(?:https?://)?[\\w]{1,}(?:\\.?[\\w]{1,})+[\\w-_/?&=#%:]*$";

//		String regex = "^([hH][tT]{2}[pP]:/*|[hH][tT]{2}[pP][sS]:/*|[fF][tT][pP]:/*)(([A-Za-z0-9-~]+).)+([A-Za-z0-9-~\\/])+(\\?{0,1}(([A-Za-z0-9-~]+\\={0,1})([A-Za-z0-9-~]*)\\&{0,1})*)$";

		Pattern pattern = Pattern.compile(regex);

		Matcher matcher = pattern.matcher(str);

		if(matcher.matches()){

			return true;

		}else{

			return false;

		}

	}};

	/***

	 * @Title: getURLs

	 * @Description: 给定cssQuery对象

	 * @param @param cssQuery HTML中的CSS(或者 JQuery)选择器语法,更多详细用法见Jsoup介绍 < a

	 *        href="https://jsoup.org/apidocs/org/jsoup/select/Selector.html"

	 *        ></a>

	 * @param @return List

	 * @throws

	 *

	 */

	public List<String> getURLs(String cssQuery) {

		List<String> urls = null;

		Document doc;

		Elements imgElements ;

		if (!isURL(URL)) {

			return null;

		}

		if(StringUtil.isBlank(cssQuery)){

			cssQuery="img";

		}

		try {

			doc = Jsoup.connect(URL).get();

		} catch (IOException e) {

			e.printStackTrace();

			return null;

		}

		if(doc==null)return null;

		imgElements = doc.select(cssQuery);

		urls = new ArrayList<String>();

		for (Object eleObj : imgElements) {

			//"(https?|ftp|http)://[-A-Za-z0-9+&@#/%?=~_|!:,.;]+[-A-Za-z0-9+&@#/%=~_|]"

			Pattern pattern = Pattern.compile("(https?|http)://[-A-Za-z0-9+&@#/%?=~_|!:,.;]+[-A-Za-z0-9+&@#/%=~_|]");

			Matcher matcher = pattern.matcher(eleObj.toString());

			if (matcher.find()) {

				String url = matcher.group();

				urls.add(url);

			}

		}

		imgNumbs = imgElements.size();

		return urls;

	}

	/**

	 *

	 * @Title: createImgURLTxt

	 * @Description:

	 * @param @param cssQuery:默认使用img HTML中的CSS(或者 JQuery)选择器语法,更多详细用法见Jsoup介绍 <

	 *        a href="https://jsoup.org/apidocs/org/jsoup/select/Selector.html">

	 *        </a>

	 * @throws 生成imgURLs.txt

	 */

	public String createImgURLTxt(String cssQuery) {

		long start = System.currentTimeMillis();

		List<String> urls;

		urls = getURLs(cssQuery);

		BufferedWriter os = null;

		File urlsFiles = new File("imgURLs.txt");

		if(urlsFiles.exists()){

			try {

				urlsFiles.createNewFile();

			} catch (IOException e) {

				e.printStackTrace();

			}

		}

		try {

			os = new BufferedWriter(new FileWriter(urlsFiles));

			if(urls==null)return null;

			for (int i = 0; i < urls.size(); i++) {

				os.write(urls.get(i) + "\n");

			}

			String result = "执行完毕,生成imgURLs.txt,耗时"

					+ (System.currentTimeMillis() - start) / 1000 + "s";

			System.out.println(result);

			return result;

		} catch (IOException e) {

			e.printStackTrace();

		} finally {

			try {

				if (os != null)

					os.close();

			} catch (IOException e) {

				e.printStackTrace();

			}

		}

		return null;

	}

	/**

	 *

	 * @Title: createImgs

	 * @Description:

	 * @param @param cssQuery

	 * @param @throws IOException

	 * @throws

	 */

	public void createImgs(String cssQuery) throws IOException {

		long startTime = System.currentTimeMillis();

		downloadMsg.add("Your images is downloading ");

		BufferedReader br = null;

		OutputStream out = null;

		InputStream in = null;

		ArrayList<String> imgList = null;

		HttpURLConnection con = null;

		String url;			 	//待下载文件url

		int fileSize = 0;		//单个文件大小

		int totalFileNum=0;		//总文件数

		int downLoadFileNum=0;	//已下载文件

		long totalTime=0;		//总耗时/s

		long singleTime=0;		//单个文件耗时/ms

		br = new BufferedReader(new FileReader(imgUrlTxt));

		imgList = new ArrayList<String>();

		while ((url = br.readLine()) != null) {

			imgList.add(url);

		}

		downLoadFileNum=totalFileNum= imgList.size();

		downloadMsg.add("总文件数"+(totalFileNum));

		for (String listUrl : imgList) {

			startTime = System.currentTimeMillis();

			String fileName = listUrl.substring(listUrl.lastIndexOf('/') + 1);// 截取文件名

			URL imgUrl = new URL(listUrl.trim());

			if (con != null)

				con.disconnect();

			con = (HttpURLConnection) imgUrl.openConnection();

			con.setRequestMethod("GET");

			con.setDoInput(true);

			con.setConnectTimeout(1000 * 30);

			con.setReadTimeout(1000 * 30);

			fileSize = con.getContentLength();

			con.connect();

			try {

				in = con.getInputStream();

				File file = new File("img" + File.separator, fileName);

				if (!file.exists()) {

					file.getParentFile().mkdirs();

					file.createNewFile();

				}

				out = new BufferedOutputStream(new FileOutputStream(file));

				int len = 0;

				byte[] buff = new byte[1024 * 1024];

				while ((len = new BufferedInputStream(in).read(buff)) != -1) {

					out.write(buff, 0, len);

				}

				out.flush();

				downLoadFileNum--;

			} catch (Exception e) {

				e.printStackTrace();

			} finally {

				if (br != null)

					try {

						br.close();

					} catch (IOException e) {

						e.printStackTrace();

					}

				if (in != null)

					try {

						in.close();

					} catch (IOException e) {

						e.printStackTrace();

					}

				if (out != null)

					try {

						out.close();

					} catch (IOException e) {

						e.printStackTrace();

					}

				singleTime=System.currentTimeMillis() - startTime;

				totalTime+=singleTime;

				downloadMsg.add("文件名" + fileName + "  文件大小" + fileSize

								  +"  未下载文件数"+(downLoadFileNum)

								  +"  下载耗时"+ singleTime + "ms" );

				System.out.println(downloadMsg.get(downloadMsg.size()-1));

			}

		}

		downloadMsg.add("总耗时"+totalTime/1000+"s");

	}

	/**

	 * @throws IOException

	 *

	 * @Title: main

	 * @Description: test

	 * @param @param args

	 * @throws

	 */

	public static void main(String[] args) throws IOException {

		ImgTool img = ImgTool.getInstance();

		 img.createImgURLTxt("img");

		 List<String> urls = img.getURLs("img");

		 for (Object str : urls) {

			System.out.println(str.toString());

		}

		img.createImgs(null);

	}

}
java 爬虫:开源java爬虫 swing工具 Imgraber的更多相关文章
- 基于 Java 的开源网络爬虫框架 WebCollector
原文:https://www.oschina.net/p/webcollector
- 【转】44款Java 网络爬虫开源软件
原帖地址 http://www.oschina.net/project/lang/19?tag=64&sort=time 极简网络爬虫组件 WebFetch WebFetch 是无依赖极简网页 ...
- 不会python?那就换一种姿势爬虫!Java爬虫技术总结
-本博客为原创内容,转载需注明本人- 前几天有个师妹将要毕业,需要准备毕业论文,但是论文调研需要数据资料,上知网一查,十几万条数据!指导老师让她手动copy收集,十几万的数据手动copy要浪费多少时间 ...
- 用java实现新浪爬虫,代码完整剖析(仅针对当前SinaSignOn有效)
先来看我们的web.xml文件,如下 <!DOCTYPE web-app PUBLIC "-//Sun Microsystems, Inc.//DTD Web Application ...
- 7 款开源 Java 反编译工具
今天我们要来分享一些关于Java的反编译工具,反编译听起来是一个非常高上大的技术词汇,通俗的说,反编译是一个对目标可执行程序进行逆向分析,从而得到原始代码的过程.尤其是像.NET.Java这样的运行在 ...
- WEKA,一个开源java的数据挖掘工具
开始研究WEKA,一个开源java的数据挖掘工具. HS沉寂这么多天,谁知道偏偏在我申请离职的时候给我安排了个任务,哎,无语. 于是,今天看了一天的Weka. 主要是看了HS提供的三个文章(E文,在g ...
- 7款开源Java反编译工具
今天我们要来分享一些关于Java的反编译工具,反编译听起来是一个非常高上大的技术词汇,通俗的说,反编译是一个对目标可执行程序进行逆向分析,从而得到原始代码的过程.尤其是像.NET.Java这样的运行在 ...
- Java 图片爬虫,java打包jar文件
目录 1. Java 图片爬虫,制作 .jar 文件 spider.java 制作 jar 文件 添加执行权限 1. Java 图片爬虫,制作 .jar 文件 spider.java spider.j ...
- Arthas Alibaba 开源 Java 诊断工具
Arthas 用户文档 English Docs Arthas(阿尔萨斯) 能为你做什么? Arthas 是Alibaba开源的Java诊断工具,深受开发者喜爱. 当你遇到以下类似问题而束手无策时,A ...
随机推荐
- python 设计模式之适配器模式 Adapter Class/Object Pattern
#写在前面 看完了<妙味>和<华医>,又情不自禁的找小说看,点开了推荐里面随机弹出的<暗恋.橘生淮南>,翻了下里面的评论,有个读者从里面摘了一段自己很喜欢的话出来, ...
- 蒙特卡洛树搜索算法 —— github上的implement的原代码
首先在网上看到了关于蒙特卡洛搜索算法的介绍,如下: https://www.cnblogs.com/steven-yang/p/5993205.html 并从中发现了一个在GitHub上impleme ...
- Spring cloud微服务安全实战-3-6API安全机制之数据校验
校验:非空.唯一性等校验 密码的加密:密码加密来存储. 如何做https的访问 校验 一个层面是接口层面,另外一个层面是数据库层面. Springboot给我们提供了简单的封装 校验的包里面还有其他的 ...
- [ kvm ] 学习笔记 4:KVM 高级功能详解
1. 半虚拟化驱动 1.1 virtio 概述 KVM 是必须使用硬件虚拟化辅助技术(如 Intel VT-x .AMD-V)的 Hypervisor,在CPU 运行效率方面有硬件支持,其效率是比较高 ...
- elasticsearch5.0.1集群索引分片丢失的处理
elasticdump命令安装 yum install npm npm install elasticdump -g 命令安装完毕,可以测试. 可能会报出nodejs的版本之类的错误,你需要升级一下版 ...
- Java分布式:分布式事务
Java分布式:分布式事务 分布式事务 分布式事务就是指事务的参与者.支持事务的服务器.资源服务器以及事务管理器分别位于不同的分布式系统的不同节点之上.简单的说,就是一次大的操作由不同的小操作组成,这 ...
- golang中sync.RWMutex和sync.Mutex区别
golang中sync包实现了两种锁Mutex (互斥锁)和RWMutex(读写锁),其中RWMutex是基于Mutex实现的,只读锁的实现使用类似引用计数器的功能. type Mutex f ...
- 微信小程序bug集
bug1:navigator标签无法跳转,控制台不报错,解决方案如图
- canal启动报错ERROR c.a.o.canal.parse.inbound.mysql.dbsync.DirectLogFetcher - I/O error while reading from client socket
- php面向对象(文件操作)
文件操作 1.只能操作服务器的文件 2.文件包含目录和文件 判断文件类型 var_dump(filetype("../0529")); //返回文件的类型:目录dir 文件file ...