
spark 33G表
http://192.168.2.51:4041
http://hadoop1:8088/proxy/application_1512362707596_0006/executors/

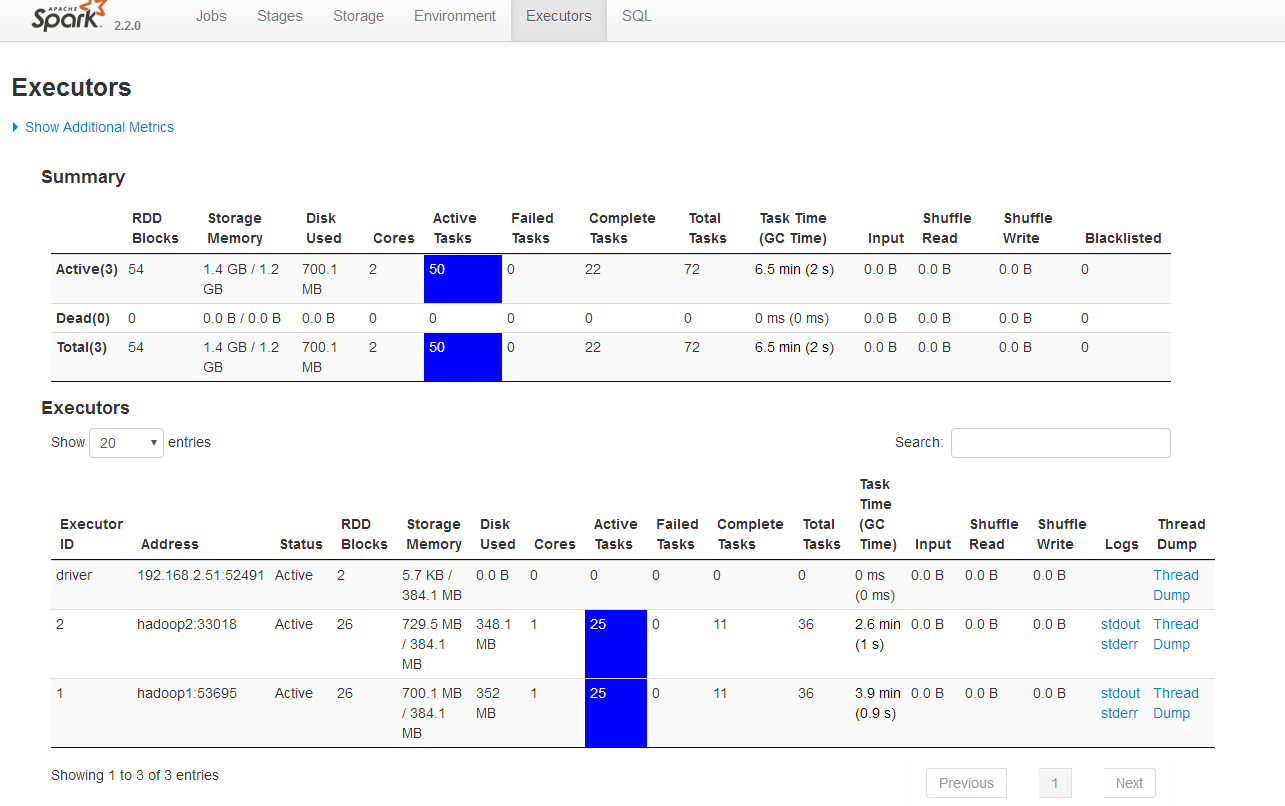
Executors
Summary
| RDD Blocks | Storage Memory | Disk Used | Cores | Active Tasks | Failed Tasks | Complete Tasks | Total Tasks | Task Time (GC Time) | Input | Shuffle Read | Shuffle Write | Blacklisted | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Active(3) | 54 | 1.4 GB / 1.2 GB | 700.1 MB | 2 | 50 | 0 | 22 | 72 | 6.5 min (2 s) | 0.0 B | 0.0 B | 0.0 B | 0 |
| Dead(0) | 0 | 0.0 B / 0.0 B | 0.0 B | 0 | 0 | 0 | 0 | 0 | 0 ms (0 ms) | 0.0 B | 0.0 B | 0.0 B | 0 |
| Total(3) | 54 | 1.4 GB / 1.2 GB | 700.1 MB | 2 | 50 | 0 | 22 | 72 | 6.5 min (2 s) | 0.0 B | 0.0 B | 0.0 B | 0 |
Executors
20
40
60
100
All
entries
| Executor ID | Address | Status | RDD Blocks | Storage Memory | Disk Used | Cores | Active Tasks | Failed Tasks | Complete Tasks | Total Tasks | Task Time (GC Time) | Input | Shuffle Read | Shuffle Write | Logs | Thread Dump |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| driver | 192.168.2.51:52491 | Active | 2 | 5.7 KB / 384.1 MB | 0.0 B | 0 | 0 | 0 | 0 | 0 | 0 ms (0 ms) | 0.0 B | 0.0 B | 0.0 B | Thread Dump | |
| 2 | hadoop2:33018 | Active | 26 | 729.5 MB / 384.1 MB | 348.1 MB | 1 | 25 | 0 | 11 | 36 | 2.6 min (1 s) | 0.0 B | 0.0 B | 0.0 B | Thread Dump | |
| 1 | hadoop1:53695 | Active | 26 | 700.1 MB / 384.1 MB | 352 MB | 1 | 25 | 0 | 11 | 36 | 3.9 min (0.9 s) | 0.0 B | 0.0 B | 0.0 B | Thread Dump |
from pyspark.sql import SparkSession

my_spark = SparkSession \
    .builder \
    .appName("myAppYarn-10g") \
    .master('yarn') \
    .config("spark.mongodb.input.uri", "mongodb://pyspark_admin:admin123@192.168.2.50/recommendation.article") \
    .config("spark.mongodb.output.uri", "mongodb://pyspark_admin:admin123@192.168.2.50/recommendation.article") \
    .getOrCreate()

db_rows = my_spark.read.format("com.mongodb.spark.sql.DefaultSource").load().collect()
Summary
| RDD Blocks | Storage Memory | Disk Used | Cores | Active Tasks | Failed Tasks | Complete Tasks | Total Tasks | Task Time (GC Time) | Input | Shuffle Read | Shuffle Write | Blacklisted | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Active(3) | 31 | 748.4 MB / 1.2 GB | 75.7 MB | 2 | 27 | 0 | 0 | 27 | 0 ms (0 ms) | 0.0 B | 0.0 B | 0.0 B | 0 |
| Dead(2) | 56 | 1.5 GB / 768.2 MB | 790.3 MB | 2 | 0 | 0 | 77 | 77 | 2.7 h (2 s) | 0.0 B | 0.0 B | 0.0 B | 0 |
| Total(5) | 87 | 2.3 GB / 1.9 GB | 865.9 MB | 4 | 27 | 0 | 77 | 104 | 2.7 h (2 s) | 0.0 B | 0.0 B | 0.0 B | 0 |
Executors
20
40
60
100
All
entries
| Executor ID | Address | Status | RDD Blocks | Storage Memory | Disk Used | Cores | Active Tasks | Failed Tasks | Complete Tasks | Total Tasks | Task Time (GC Time) | Input | Shuffle Read | Shuffle Write | Logs | Thread Dump |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| driver | 192.168.2.51:52491 | Active | 2 | 5.7 KB / 384.1 MB | 0.0 B | 0 | 0 | 0 | 0 | 0 | 0 ms (0 ms) | 0.0 B | 0.0 B | 0.0 B | Thread Dump | |
| 4 | hadoop2:34394 | Active | 12 | 315.9 MB / 384.1 MB | 0.0 B | 1 | 11 | 0 | 0 | 11 | 0 ms (0 ms) | 0.0 B | 0.0 B | 0.0 B | Thread Dump | |
| 3 | hadoop1:39620 | Active | 17 | 432.5 MB / 384.1 MB | 75.7 MB | 1 | 16 | 0 | 0 | 16 | 0 ms (0 ms) | 0.0 B | 0.0 B | 0.0 B | Thread Dump | |
| 2 | hadoop2:33018 | Dead | 27 | 758.7 MB / 384.1 MB | 390.4 MB | 1 | 0 | 0 | 38 | 38 | 1.3 h (1 s) | 0.0 B | 0.0 B | 0.0 B | Thread Dump | |
| 1 | hadoop1:53695 | Dead | 29 | 775.9 MB / 384.1 MB | 399.9 MB | 1 | 0 | 0 | 39 | 39 | 1.4 h (0.9 s) | 0.0 B | 0.0 B | 0.0 B | Thread Dump |
Logs for container_1512362707596_0006_02_000002 |
|
|
Showing 4096 bytes. Click here for full log Manager: Dropping block taskresult_48 from memory |
|
spark 33G表的更多相关文章
- 基于spark实现表的join操作
1. 自连接 假设存在如下文件: [root@bluejoe0 ~]# cat categories.csv 1,生活用品,0 2,数码用品,1 3,手机,2 4,华为Mate7,3 每一行的格式为: ...
- 利用spark将表中数据拆分
i# coding:utf-8from pyspark.sql import SparkSession import os if __name__ == '__main__': os.environ[ ...
- spark使用Hive表操作
spark Hive表操作 之前很长一段时间是通过hiveServer操作Hive表的,一旦hiveServer宕掉就无法进行操作. 比如说一个修改表分区的操作 一.使用HiveServer的方式 v ...
- Databricks 第6篇:Spark SQL 维护数据库和表
Spark SQL 表的命名方式是db_name.table_name,只有数据库名称和数据表名称.如果没有指定db_name而直接引用table_name,实际上是引用default 数据库下的表. ...
- Spark SQL概念学习系列之如何使用 Spark SQL(六)
val sqlContext = new org.apache.spark.sql.SQLContext(sc) // 在这里引入 sqlContext 下所有的方法就可以直接用 sql 方法进行查询 ...
- spark基础知识介绍2
dataframe以RDD为基础的分布式数据集,与RDD的区别是,带有Schema元数据,即DF所表示的二维表数据集的每一列带有名称和类型,好处:精简代码:提升执行效率:减少数据读取; 如果不配置sp ...
- 新手福利:Apache Spark入门攻略
[编者按]时至今日,Spark已成为大数据领域最火的一个开源项目,具备高性能.易于使用等特性.然而作为一个年轻的开源项目,其使用上存在的挑战亦不可为不大,这里为大家分享SciSpike软件架构师Ash ...
- Spark入门之DataFrame/DataSet
目录 Part I. Gentle Overview of Big Data and Spark Overview 1.基本架构 2.基本概念 3.例子(可跳过) Spark工具箱 1.Dataset ...
- 6.3 使用Spark SQL读写数据库
Spark SQL可以支持Parquet.JSON.Hive等数据源,并且可以通过JDBC连接外部数据源 一.通过JDBC连接数据库 1.准备工作 ubuntu安装mysql教程 在Linux中启动M ...
随机推荐
- POJ 3469 Dual Core CPU ——网络流
[题目分析] 构造一个最小割的模型. S向每一个点连Ai,每一个点向T连Bi. 对于每一个限制条件,在i和j之间连一条Cij的双向边即可. 然后求出最小割就是最少的花费. 验证最小割的合理性很容易. ...
- Ionic 如何把左上角的按钮去掉?
代码实现: <ion-header > <ion-toolbar> <ion-buttons start> <a href="#"> ...
- uva 11426 线性欧拉函数筛选+递推
Problem J GCD Extreme (II) Input: Standard Input Output: Standard Output Given the value of N, you w ...
- 438. Find All Anagrams in a Strin
Given a string s and a non-empty string p, find all the start indices of p's anagrams in s. Strings ...
- IntelliJ IDEA常用统一设置(Linux/Mac/Windows)
前言:如果说VS是宇宙超级无敌第一大开发工具,那么IDEA是当之无愧的第二大开发工具,将来有机会把VS干掉. 说明:除了以下说明的配置地方外,其它尽量保持默认,这样有利于团队代码风格的统一. 运行VM ...
- Camtasia Studio录制屏幕字迹不清晰的原因
Camtasia Studio这是一个很优秀的屏幕录像软件,功能强大且录制效果出色,支持众多格式输出: 之前一直用它录制视频的都很正常,但这次换系统后再重新安装后录制视频时,发现输出的视频画质不佳,文 ...
- openfalcon的安装和使用
蛮复杂的样子 根据官方文档指导,一步一步走起:https://book.open-falcon.org/zh_0_2/quick_install/prepare.html 单机安装的过程:单击安装会把 ...
- 应用程序中的server错误,没有名称为“ServiceBehavior”的服务行为
应用程序中的server错误,没有名称为"ServiceBehavior"的服务行为 今天在阅读"创建和使用Web服务"的相关内容,在浏览器中查 ...
- 三期_day05_Dao层的准备工作_II
工作文件夹: 实体类:UserInfo.java package com.yc.crm.entity; import java.util.Date; public class UserInfo { p ...
- 函数柯里化 curry
一.函数柯里化的特性: (1)参数复用 $.ajax // 示例一 function ajax(type,url,data) { var xhr = new XMLHttpRequest(); xhr ...