
spark streaming 踩过的那些坑
- 系统背景
- spark streaming + Kafka高级API receiver
- 目前资源分配(现在系统比较稳定的资源分配),独立集群
--driver-memory 50G
--executor-memory 8G
--num-executors 11
--executor-cores 5
- 广播变量
1. 广播变量的初始化
1.1.executor端,存放广播变量的对象使用非静态,因为静态变量是属于类的,不能使用构造函数来初始化。在executor端使用静态的时候,它只是定义的时候的一个状态,而在初始化时设置的值取不到。而使用非静态的对象,其构造函数的初始化在driver端执行,故在集群可以取到广播变量的值。
2. 广播变量的释放
2.1.当filter增量为指定大小时,进行广播,虽然广播的是同一个对象,但是,广播的ID是不一样的,而且ID号越来越大,这说明对于广播来说,它并不是一个对象,而只是名字一样的不同对象,如果不对广播变量进行释放,将会导致executor端内存占用越来越大,而一直没有使用的广播变量,被进行GC,会导致GC开销超过使用上线,导致程序失败。
2.2.解决方案:这广播之前,先调用unpersist()方法,释放不用的广播变量
- 使用Kafka 的高级API receiver
1. 在使用receiver高级API时,由于receiver、partition、executor的分配关系,经常会导致某个executor任务比较繁重,进而影响整体处理速度
1.1.最好是一个receiver对应一个executor
2. 由于前段时间数据延迟比较严重,就想,能不能让所有executor的cores都去处理数据?所以调整receiver为原来的四倍,结果系统启动时,就一下冲上来非常大的数据量,导致系统崩溃,可见,receiver不仅跟partition的分配有关,还跟数据接收量有关
3. 在实际处理数据中,由于消息延迟,可以看到,有的topic处理速度快有的慢,原因分析如下:
3.1.跟消息的格式有关,有的是序列化文件,有的事json格式,而json的解析相对于比较慢
3.2.有时候拖累整个集群处理速度的,除了大量数据,还跟单条数据的大小有关
以下是程序跑挂的一些异常,和原因分析
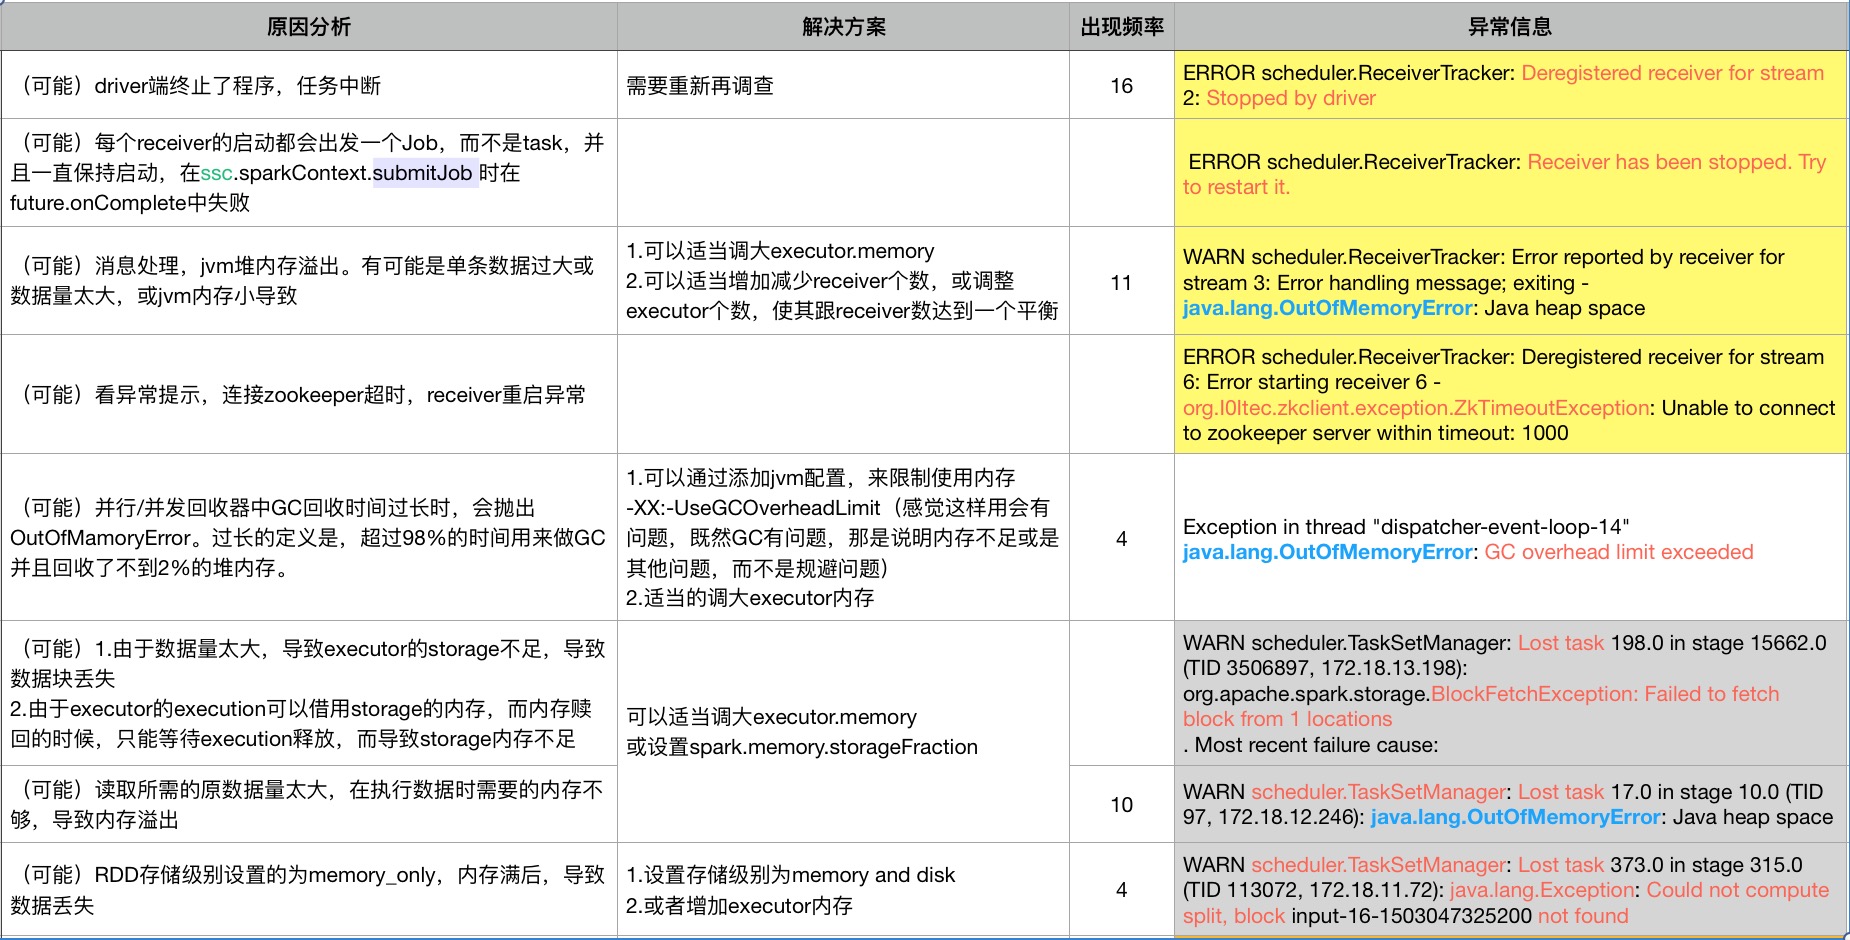

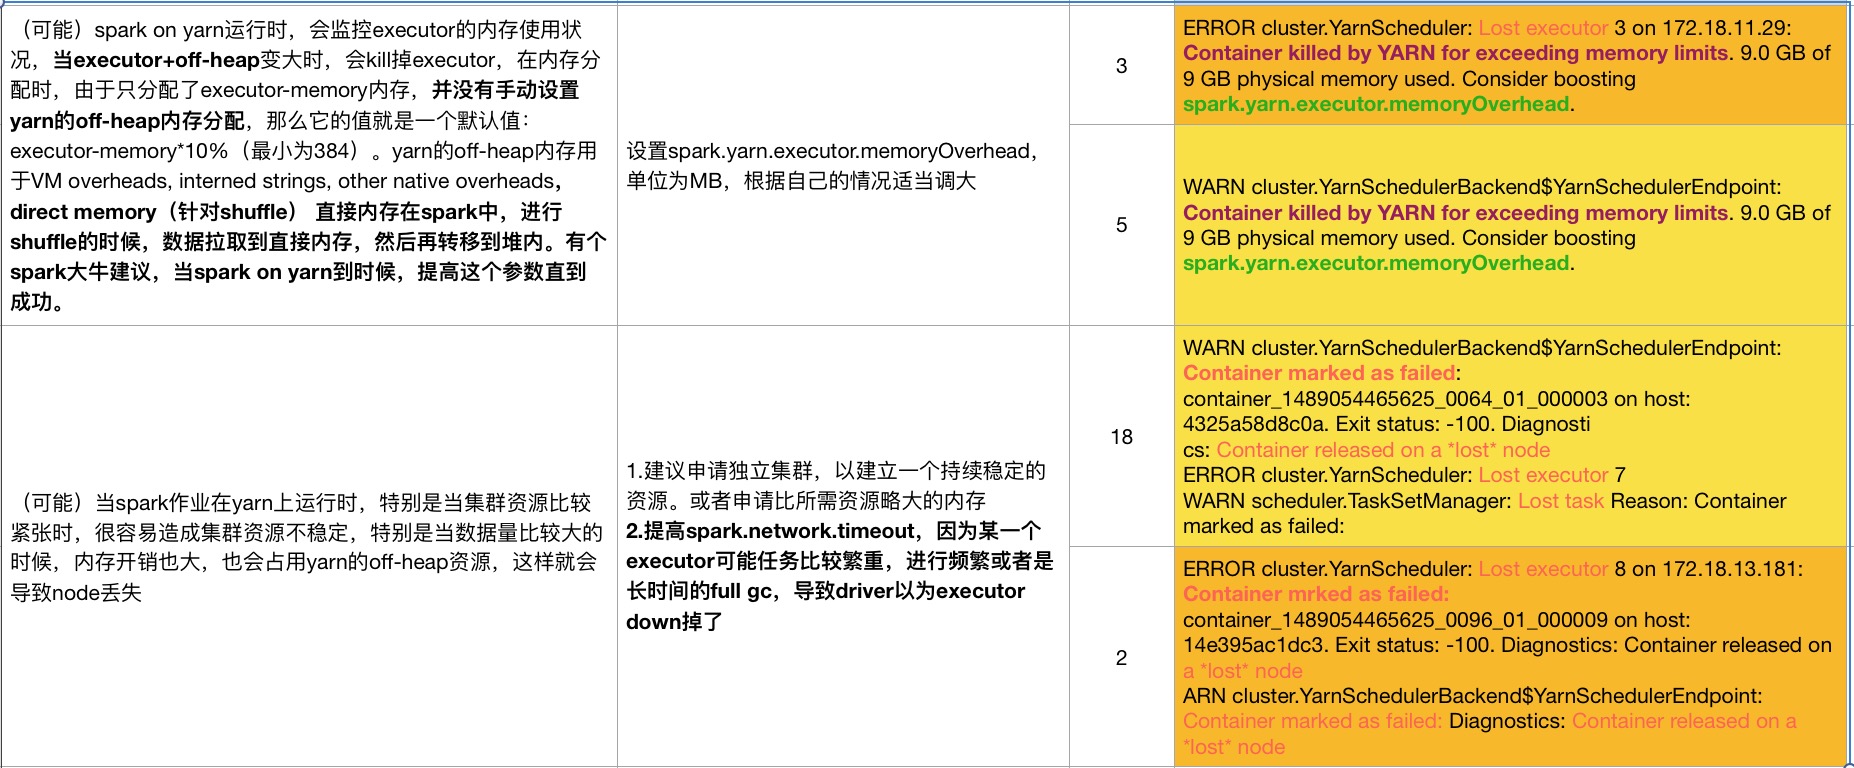
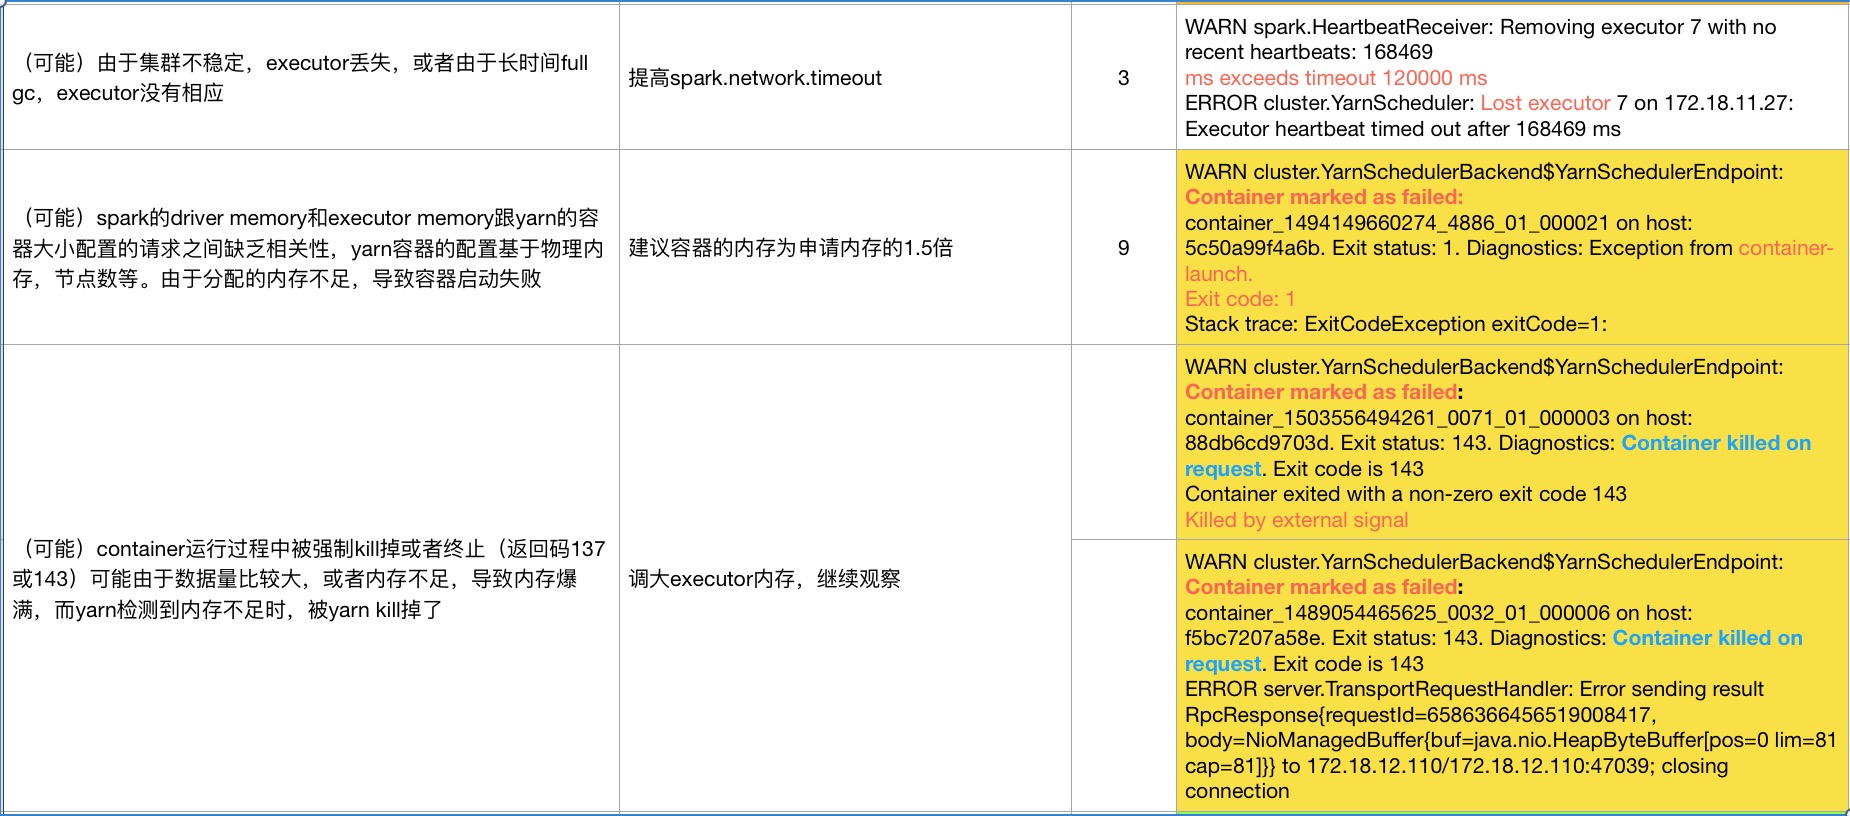
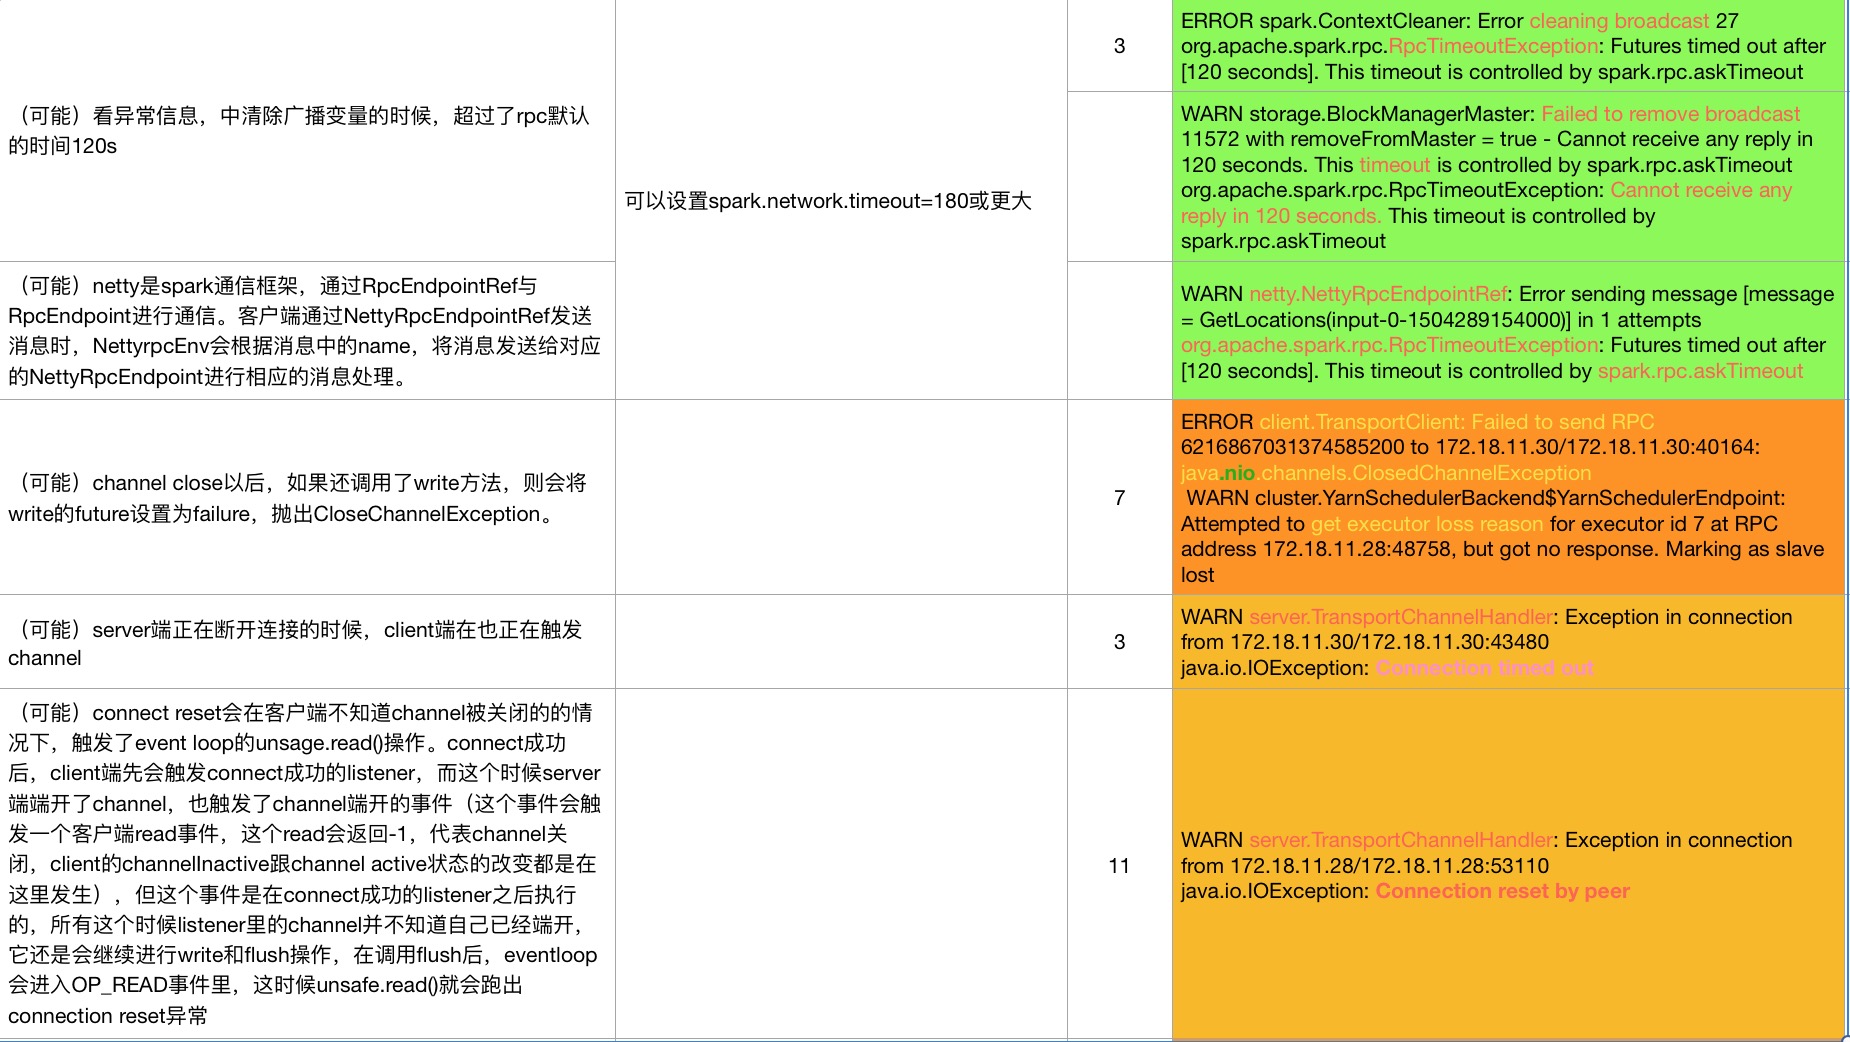
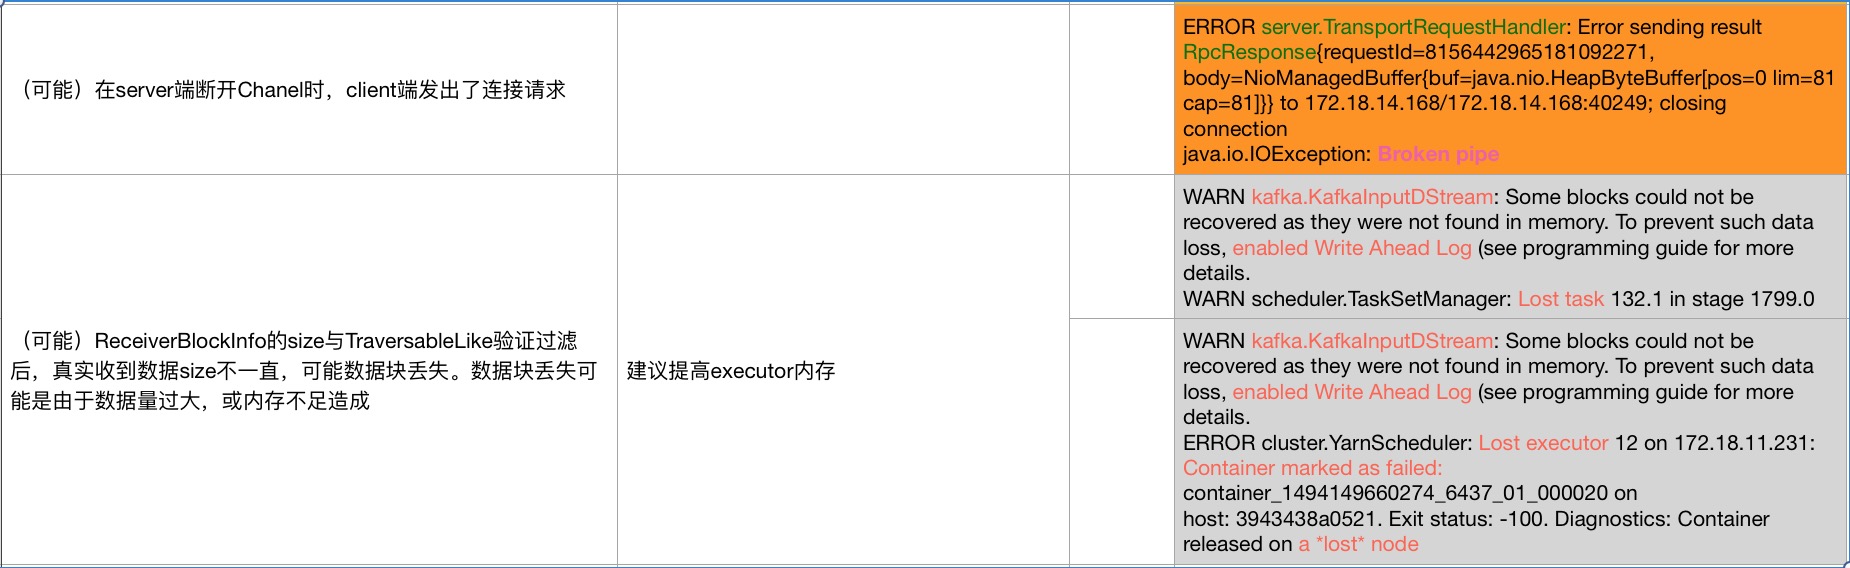
问题矫正:
第一张图片的,解决方案的倒数第二个, spark.memory.storageFraction(动态内存的百分比设置),应该为spark.storage.memoryFraction(静态内存分配的设置) (由于原文档丢失,导致无法修改文档。)
如果有什么问题,欢迎大家指出,共同探讨,共同进步
spark streaming 踩过的那些坑的更多相关文章
- spark streaming 消费 kafka入门采坑解决过程
kafka 服务相关的命令 # 开启kafka的服务器bin/kafka-server-start.sh -daemon config/server.properties &# 创建topic ...
- Spark踩坑记——Spark Streaming+Kafka
[TOC] 前言 在WeTest舆情项目中,需要对每天千万级的游戏评论信息进行词频统计,在生产者一端,我们将数据按照每天的拉取时间存入了Kafka当中,而在消费者一端,我们利用了spark strea ...
- Spark踩坑记:Spark Streaming+kafka应用及调优
前言 在WeTest舆情项目中,需要对每天千万级的游戏评论信息进行词频统计,在生产者一端,我们将数据按照每天的拉取时间存入了Kafka当中,而在消费者一端,我们利用了spark streaming从k ...
- Spark Streaming+Kafka
Spark Streaming+Kafka 前言 在WeTest舆情项目中,需要对每天千万级的游戏评论信息进行词频统计,在生产者一端,我们将数据按照每天的拉取时间存入了Kafka当中,而在消费者一端, ...
- Spark streaming消费Kafka的正确姿势
前言 在游戏项目中,需要对每天千万级的游戏评论信息进行词频统计,在生产者一端,我们将数据按照每天的拉取时间存入了Kafka当中,而在消费者一端,我们利用了spark streaming从kafka中不 ...
- Spark Streaming实时写入数据到HBase
一.概述 在实时应用之中,难免会遇到往NoSql数据如HBase中写入数据的情景.题主在工作中遇到如下情景,需要实时查询某个设备ID对应的账号ID数量.踩过的坑也挺多,举其中之一,如一开始选择使用NE ...
- 使用 Kafka 和 Spark Streaming 构建实时数据处理系统
使用 Kafka 和 Spark Streaming 构建实时数据处理系统 来源:https://www.ibm.com/developerworks,这篇文章转载自微信里文章,正好解决了我项目中的技 ...
- Redis上踩过的一些坑
来自: http://blog.csdn.net//chenleixing/article/details/50530419 上上周和同事(龙哥)参加了360组织的互联网技术训练营第三期,美团网的DB ...
- 【自动化】基于Spark streaming的SQL服务实时自动化运维
设计背景 spark thriftserver目前线上有10个实例,以往通过监控端口存活的方式很不准确,当出故障时进程不退出情况很多,而手动去查看日志再重启处理服务这个过程很低效,故设计利用Spark ...
随机推荐
- JS 事件添加onclick写法注意。
自定义函数添加onclick事件写法注意. 错误写法:element.onclick = addclass(className); 正确写法:element.onclick = function(){ ...
- AJPFX对equals()方法和==异同的比较
equals()方法是Object类的方法,所有的类都集成了此方法,还有部分类重写了这个方法,我们看一下Object类中关于该方法的的源码: public boolean equals(Object ...
- Redis相关问题收集
问题一.强制关闭Redis快照导致不能持久化 MISCONF Redis is configured to save RDB snapshots, but is currently not able ...
- [BZOJ1192][HNOI2006]鬼谷子的钱袋 数学
题目链接:http://www.lydsy.com/JudgeOnline/problem.php?id=1192 大水题,把m分成二的幂次方和. #include<cstdio> #in ...
- 《基于Node.js实现简易聊天室系列之项目前期工作》
前期工作主要包括:项目的创建,web服务器的创建和数据库的连接. 项目创建 网上关于Node.js项目的创建的教程有很多,这里不必赘述.Demo所使用的Node.js的框架是express,版本为4. ...
- CAS介绍
1.概述 单点登录(Single Sign On),简称为 SSO,是目前比较流行的企业业务整合的解决方案之一.SSO的定义是在多个应用系统中,用户只需要登录一次就可以访问所有相互信任的应用系统. 耶 ...
- iOS---UICollectionView自定义流布局实现瀑布流效果
自定义布局,实现瀑布流效果 自定义流水布局,继承UICollectionViewLayout 实现一下方法 // 每次布局之前的准备 - (void)prepareLayout; // 返回所有的尺寸 ...
- C#斐波那契数列递归算法
public static int Foo(int i) { if (i < 3) { return 1; ...
- iTOP-4412开发板-实战教程-ssh服务器移植到arm开发板
本文转自迅为开发板:http://www.topeetboard.com 在前面实战教程中,移植了“串口文件传输工具”,整个移植过程是比较简单的,而且我 们没有做任何协议方面的了解,只是“配置”+“编 ...
- HTML5小時鐘
<!DOCTYPE HTML PUBLIC"-//W3C//DTD HTML 4.01 Transitional//EN" "http://www.w3.org/T ...