
【Selenium + Python】之 Excel、CSV、XML文件读取数据并运用数据百度查询
目录
一、从Excel读取数据进行百度搜索
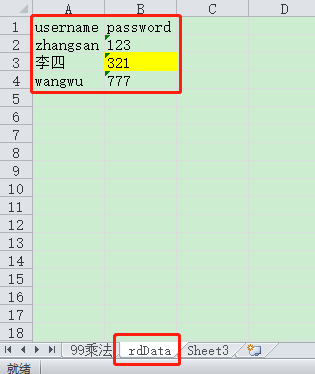
封装读取方法:
import xlrd

from selenium import webdriver

from selenium.webdriver.common.by import By

class rdExcel():

    def __init__(self,excel_dir,sheet_name):

        self.r = []

        self.rd = xlrd.open_workbook(excel_dir)

        self.sh = self.rd.sheet_by_name(sheet_name)

        #首行设置为key

        self.key = self.sh.row_values(0)

        #获取总行数

        self.rownum = self.sh.nrows

        #获取总列数

        self.colnum = self.sh.ncols

    def function(self):

        if self.rownum<=1:

            print("没有获取到数值")

        else:

            r = []

            j=1

            #要执行的行数

            for i in range(self.rownum - 1):

                s = {}

                values = self.sh.row_values(j)

                for x in range(self.colnum):

                    s[self.key[x]] = values[x]

                r.append(s)

                j+=1

            # print(r)

            return r

if __name__ == '__main__':

    a = input("excel_dir:")

    b = input("sheet_name:")

    data = rdExcel(a,b)

    print(data.function())
基本操作:指定单元格读取数据
rd = xlrd.open_workbook("C:\\Users\\ZHANGCH\\Desktop\\test99.xlsx")

sh = rd.sheet_by_name("rdData")

value = sh.row_values(1)[0]

driver = webdriver.Chrome()

driver.maximize_window()

driver.get("http://www.baidu.com")

driver.find_element(By.CSS_SELECTOR,"#kw").send_keys(value)

driver.find_element(By.CSS_SELECTOR,"#su").click()
============================================================================
写法进行修改规整,完整获取指定数据进行百度查询:
写法①:
import xlrd

import os

from selenium import webdriver

from selenium.webdriver.common.by import By

from time import sleep

base = os.path.dirname(os.path.dirname(__file__))

base_dir = base.replace('/','\\')

file_dir = base_dir + os.sep + "test" + os.sep + "test99.xlsx"

print(file_dir)

class test():

    def __init__(self,file_dir,sheet_name):

        self.rd = xlrd.open_workbook(file_dir)

        self.sh = self.rd.sheet_by_name(sheet_name)

        self.rows = self.sh.nrows

        self.cols = self.sh.ncols

    def ExcelRd(self):

        r = []

        for i in range(1,self.rows):

            values = self.sh.row_values(i,0,self.cols)

            r.append(values)

        return r

if __name__ == '__main__':

    #指定sheet页为:rdData

    file_dir = input("路径为:")

    sheet_name = input("sheet页为:")

    data = test(file_dir,sheet_name).ExcelRd()

    driver = webdriver.Chrome()

    driver.maximize_window()

    driver.implicitly_wait(10)

    driver.get("https://www.baidu.com")

    for footballStar in data:

        driver.find_element(By.CSS_SELECTOR,"#kw").clear()

        driver.find_element(By.CSS_SELECTOR,"#kw").send_keys(footballStar[1])

        driver.find_element(By.CSS_SELECTOR,"#su").click()

        sleep(5)

    driver.quit()
写法②:添加截图方法
function.py:
import os

def screenshot(driver,img_name):

    base = os.path.dirname(os.path.dirname(__file__))

    base_dir = base.replace("/","\\")

    img_dir = base_dir + os.sep + "20180515作业" + os.sep + "image" + os.sep + img_name + ".png"

    driver.get_screenshot_as_file(img_dir)
Excel读取数据.py:
import xlrd

import os

from selenium import webdriver

from selenium.webdriver.common.by import By

from time import sleep

from function import screenshot

class test(object):

    def __init__(self):

        self.base = os.path.dirname(os.path.dirname(__file__))

        self.base_dir = self.base.replace('/', '\\')

    def ExcelRd(self):

        file_dir = self.base_dir + os.sep + "20180515作业" + os.sep + "test_xlsx.xlsx"

        rd = xlrd.open_workbook(file_dir)

        sh = rd.sheet_by_name("rdData")

        rows = sh.nrows

        cols = sh.ncols

        r = []

        for i in range(1,rows):

            values = sh.row_values(i,0,cols)

            r.append(values)

        return r

if __name__ == '__main__':

    data = test().ExcelRd()

    driver = webdriver.Chrome()

    driver.maximize_window()

    driver.implicitly_wait(10)

    driver.get("https://www.baidu.com")

    for footballStar in data:

        fbStar = footballStar[1]

        driver.find_element(By.CSS_SELECTOR,"#kw").clear()

        driver.find_element(By.CSS_SELECTOR,"#kw").send_keys(fbStar)

        driver.find_element(By.CSS_SELECTOR,"#su").click()

        sleep(3)

        fbStar_xlsx = str("xlsx_" + fbStar)

        screenshot(driver,fbStar_xlsx)

        sleep(7)

    driver.quit()
二、从CSV读取数据进行百度搜索
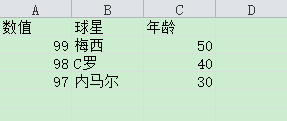
CSV读取数据.py:
import csv

import os

from selenium import webdriver

from selenium.webdriver.common.by import By

from time import sleep

from function import screenshot

class test(object):

    def __init__(self):

        base = os.path.dirname(os.path.dirname(__file__))

        self.base_dir = base.replace("/","\\")

    def CSVRd(self):

        base_dir = self.base_dir + os.sep + "20180515作业" + os.sep + "test_csv.csv"

        opFile = open(base_dir,'r')

        rd = csv.reader(opFile)

        r = []

        next(rd,None)

        for i in rd:

            r.append(i)

        return r

if __name__ == '__main__':

    data = test().CSVRd()

    driver = webdriver.Chrome()

    driver.maximize_window()

    driver.get("https://www.baidu.com")

    driver.implicitly_wait(10)

    for fbStar in data:

        fbStar = fbStar[1]

        driver.find_element(By.CSS_SELECTOR,"#kw").clear()

        driver.find_element(By.CSS_SELECTOR,"#kw").send_keys(fbStar)

        driver.find_element(By.CSS_SELECTOR,"#su").click()

        sleep(3)

        csv_fbStar = str("csv_" + fbStar)

        screenshot(driver,csv_fbStar)

        sleep(7)

    driver.quit()
三、从XML读取数据进行登录操作
test_xml文件:
<?xml version="1.0" encoding="utf-8"?>

<info>

    <title>博客园登录</title>

    <url_dir>https://passport.cnblogs.com/user/signin</url_dir>

    <login username="owen_name" password="owen_pwd">登录</login>

</info>
CSV读取数据.py:
import xml.dom.minidom as minidom

# import xml.etree.ElementTree as ele

import os

from selenium import webdriver

from selenium.webdriver.common.by import By

from time import sleep

from function import screenshot

base = os.path.dirname(os.path.dirname(__file__))

base_dir = base.replace("/","\\")

file_dir = base_dir + os.sep + "20180515作业" + os.sep + "test_xml.xml"

#打开xml文档

dom = minidom.parse(file_dir)

#得到文档元素

root = dom.documentElement

#由于下面getElementsByTagName点不出来方法,手写的

tag1 = root.getElementsByTagName("login")

tag2 = root.getElementsByTagName("url_dir")

tag3 = root.getElementsByTagName("title")

#获得标签属性值

username = tag1[0].getAttribute("username")

password = tag1[0].getAttribute("password")

#获得标签之间的数据

url = tag2[0].firstChild.data

title = tag3[0].firstChild.data

driver = webdriver.Chrome()

driver.maximize_window()

driver.get(url)

driver.find_element(By.CSS_SELECTOR,"#input1").clear()

driver.find_element(By.CSS_SELECTOR,"#input1").send_keys(username)

sleep(3)

driver.find_element(By.CSS_SELECTOR,"#input2").clear()

driver.find_element(By.CSS_SELECTOR,"#input2").send_keys(password)

sleep(3)

title = str("xml_" + title)

screenshot(driver,title)

driver.quit()
四、附:学习资料
《Python不归路_xml.etree.ElementTree模块》感谢作者:深海一尾鱼
《python读取xml文件》感谢作者:虫师
【Selenium + Python】之 Excel、CSV、XML文件读取数据并运用数据百度查询的更多相关文章
- python解析VOC的xml文件并转成自己需要的txt格式
在进行神经网络训练的时候,自己标注的数据集往往会有数据量不够大以及代表性不强等问题,因此我们会采用开源数据集作为训练,开源数据集往往具有特定的格式,如果我们想将开源数据集为我们所用的话,就需要对其格式 ...
- php xml 文件读取 XMLReader
php xml 文件读取 <?php /** $xmlString = '<xml> <persons count="10"> <person ...
- javascript读取xml文件读取节点数据的例子
分享下用javascript读取xml文件读取节点数据方法. 读取的节点数据,还有一种情况是读取节点属性数据. <head> <title></title> < ...
- xml文件读取到数据库
xml文件读取到数据库 第一步,导包 c3p0,dom4j,jaxen,MySQL-connector 第二步 xml文件,config文件 第三步 javabean 第四步 c3p0的工具类 ...
- C#程序中:如何修改xml文件中的节点(数据)
要想在web等程序中实现动态的数据内容给新(如网页中的Flash),不会更新xml文件中的节点(数据)是远远不够的,今天在这里说一个简单的xml文件的更新,方法比较基础,很适合初学者看的,保证一看就懂 ...
- Excel和XML文件导入
using System;using System.Collections;using System.Collections.Generic;using System.Configuration;us ...
- XML文件读取工具类
/// <summary> /// Author: jiangxiaoqiang /// </summary> public class XmlReader { //===== ...
- Excel关联xml文件
1.新建没传值的xml文件,变量名称自己定义好 2.打开excel,如果之前没有设置过,点击选项 如果当前Excel菜单栏中没有开发工具项,在自定义功能区先勾选上开发选项 3.点右下角的xml映射 弹 ...
- Xml 文件读取
.NET 读取Xml文件,用到XmlDocument类. 1.要获取文档的根: DocumentElement. 2.Attributes :获取 XmlAttributeCollection 包含此 ...
随机推荐
- Unity3D的主要类图
原文:http://blog.teotigraphix.com/2011/05/17/unity3d-uml-gameobject-cheat-sheet/ 1. GameObject_Structu ...
- devexpress XtraReport报表 ---主从报表
private void GetWqpWorkPrinter(List<ReelListMagt> list, string WorkDate, User user) { ReelList ...
- GCD部分使用方法
1,用gcd延迟运行任务 假设我们须要某个方法在一段时间后运行.那么我们经常会调用这个方案 - (void)viewDidLoad{ [super viewDidLoad]; [self perfor ...
- 【Zookeeper】分布式服务框架 Zookeeper -- 管理分布式环境中的数据
Zookeeper 分布式服务框架是 Apache Hadoop 的一个子项目,它主要是用来解决分布式应用中经常遇到的一些数据管理问题,如:统一命名服务.状态同步服务.集群管理.分布式应用配置项的管理 ...
- 精通Hibernate——域对象之间的关系
在域模型中.类之间存在四种关系 1.关联(Association) 类之间的引用关系,能够有一对一.一对多和多对多,比如customer与order之间就是一对多 public class Order ...
- 线程阻塞工具类:LockSupport(读书笔记)
他可以在线程任意位置让线程阻塞, LockSupport的静态方法park()可以阻塞当前线程,类似的还有parkNanos() ParkUntil()等,他们实现了一个限时等待 public cl ...
- Android控件常见属性
1.宽/高android:layout_width android:layout_height// 取值match_parent //匹配父控件wrap_content //自适应,根据内容 如果指定 ...
- js 导入json配置文件
import AA from './menu.json' console.log(AA) 匹配好路径
- 谁动了我的cpu——oprofile使用札记(转)
引言 cpu无端占用高?应用程序响应慢?苦于没有分析的工具? oprofile利用cpu硬件层面提供的性能计数器(performance counter),通过计数采样,帮助我们从进程.函数.代码层面 ...
- BF的真正意义
http://www.jianglb.com/2010/11/25/whatisbf.html一个小男孩对小女孩说:“我是你的BF.”女孩扬起童真的脸,问:“什么是BF?”男孩嘻嘻笑道:“是BestF ...