
scrapy爬取图片并自定义图片名字
1 前言
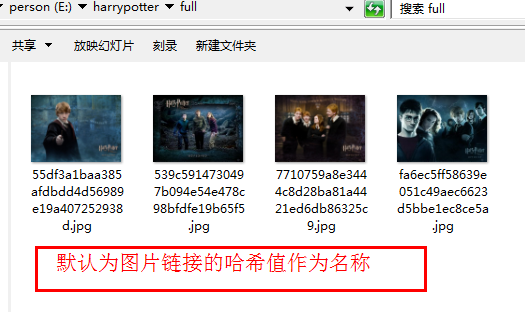
Scrapy使用ImagesPipeline类中函数get_media_requests下载到图片后,默认的图片命名为图片下载链接的哈希值,例如:它的下载链接是http://img.ivsky.com/img/bizhi/pre/201101/10/harry_potter5-017.jpg,哈希值为7710759a8e3444c8d28ba81a4421ed,那么最终的图片下载到指定路径后名称为7710759a8e3444c8d28ba81a4421ed.JPG。想要自定义图片名称则需要借助ImagesPipeline类中item_completed()函数来重命名。

2 爬虫过程
爬虫过程就不赘述了,链接请参看:https://www.cnblogs.com/mrtop/p/10180072.html,本文章重点介绍如何自定义图片名称。爬虫运行后获得的图片如下图:
3 自定义图片名称具体方法
3.1 自定义图片名称代码
import os

from  harry.settings import IMAGES_STORE as IMGS

from scrapy.pipelines.images import ImagesPipeline

from scrapy import Request

class HarryPipeline(object):

    def process_item(self, item, spider):

        return item

class HarryDownLoadPipeline(ImagesPipeline):

    def get_media_requests(self, item, info):

        for imgurl in item['img_url']:

            yield Request(imgurl)

    def item_completed(self, results, item, info):

        print ('******the results is********:',results)

        os.rename(IMGS + '/' + results[0][1]['path'], IMGS + '/' + item['img_name'])

    def __del__(self):

            #完成后删除full目录

            os.removedirs(IMGS + '/' + 'full')
注:对于def __del__(self)函数可要可不要,因为重命名过程是携带路径重命名,所以默认生成的full文件夹就为空,只是顺手删除空文件夹(如果里面有文件存在是删除不了的)
3.2 自定义图片名称代码详细解析
3.2.1 get_media_requests函数
get_media_requests方法的原型为:
def item_completed(self, results, item, info):

        if isinstance(item, dict) or self.images_result_field in item.fields:

            item[self.images_result_field] = [x for ok, x in results if ok]

        return item
可以看到get_media_requests有三个参数,
第一个是self,这个不必多说;
第二个是 item,这个就是 spiders传递过来的 item
第三个是 info,看名字就知道这是用来保存信息的,至于是什么信息,info其实是一个用来保存保存图片的名字和下载链接的列表
3.2.2 Item_completed函数
item_completed方法的原型如下:
def item_completed(self, results, item, info):

        if isinstance(item, dict) or self.images_result_field in item.fields:

            item[self.images_result_field] = [x for ok, x in results if ok]

        return item
注意到 item_completed里有个 results参数,results参数保存了图片下载的相关信息,将他print看看具体信息:
[(True, {'url': 'http://img.ivsky.com/img/bizhi/pre/201101/10/harry_potter5-015.jpg', 'path': 'full/539c5914730497b094e5c98bfdfe19b65f5.jpg', 'checksum': '37d23ffb0ab983ac2da9a9d'})]
真实结构为一个list [(DownLoad_success_or_failure),dict],字典中含有三个键:1、'url':图片路径 2、'path':图片下载后的保存路径 3、'checksum':校验码
从中我们可以看到只要我们修改字典中图片保存路径(路径详细到图片名称)的值,那么我们就能自定义图片名称。
关键代码为:
os.rename(IMGS + '/' + results[0][1]['path'], IMGS + '/' + item['img_name'])
解释:rename函数,results[0][1]['path']意思就是:在result这个list中找到图片的名称,其中我们也可以看到这个图片的位置是绝对路径,所以需要携带路径IMGS修改。
4 更新pipelines.py后运行结果

如有疑问,欢迎留言讨论交流,转载请注明出处。
scrapy爬取图片并自定义图片名字的更多相关文章
- python网络爬虫之使用scrapy爬取图片
在前面的章节中都介绍了scrapy如何爬取网页数据,今天介绍下如何爬取图片. 下载图片需要用到ImagesPipeline这个类,首先介绍下工作流程: 1 首先需要在一个爬虫中,获取到图片的url并存 ...
- 使用Scrapy爬取图片入库,并保存在本地
使用Scrapy爬取图片入库,并保存在本地 上 篇博客已经简单的介绍了爬取数据流程,现在让我们继续学习scrapy 目标: 爬取爱卡汽车标题,价格以及图片存入数据库,并存图到本地 好了不多说,让我们实 ...
- scrapy 爬取图片
scrapy 爬取图片 1.scrapy 有下载图片的自带接口,不用我们在去实现 setting.py设置 # 保存log信息的文件名 LOG_LEVEL = "INFO" # L ...
- 用scrapy爬取搜狗Lofter图片
用scrapy爬取搜狗Lofter图片 # -*- coding: utf-8 -*- import json import scrapy from scrapy.http import Reques ...
- 使用scrapy框架爬取图片网全站图片(二十多万张),并打包成exe可执行文件
目标网站:https://www.mn52.com/ 本文代码已上传至git和百度网盘,链接分享在文末 网站概览 目标,使用scrapy框架抓取全部图片并分类保存到本地. 1.创建scrapy项目 s ...
- python实现scrapy爬取图片到本地时的sha1摘要算法文件名
2017-03-29 Scrapy爬图片到本地应该会给图片自动生成sha1摘要算法文件名,我第一次用scrapy也不清楚太多,就在程序里自己写了一段实现这一功能的代码.需import hashlib ...
- scrapy框架爬取图片并将图片保存到本地
如果基于scrapy进行图片数据的爬取 在爬虫文件中只需要解析提取出图片地址,然后将地址提交给管道 配置文件中:IMAGES_STORE = './imgsLib' 在管道文件中进行管道类的制定: f ...
- Scrapy 爬取某网站图片
1. 创建一个 Scrapy 项目,在命令行或者 Pycharm 的 Terminal 中输入: scrapy startproject imagepix 自动生成了下列文件: 2. 在 imagep ...
- 【Python】- scrapy 爬取图片保存到本地、且返回保存路径
https://blog.csdn.net/xueba8/article/details/81843534
随机推荐
- 复式记账中"借"与"贷"的理解
财务常识中,复式记账法应用极广,公司采用的是它的借贷记账法.因此,深刻的理解"借"与"贷"的含义极其重要. 一切从历史说起. 起源: Credit 英文含义 ...
- 一句话说明==和equals的区别
public class equals { public static void main(String[] args) { int x=10; int y=10; String str1=new S ...
- 使用nsis开发自定义安装包使用心得,以及遇到坑
因为新公司需要开发pc应用的自定义安装包,开始时候计划使用nsis开发,论坛上面有很多不错的例子,而且完成度很强, 随便拿来修改使用,但是后续的开发过程中遇到的问题就逐个出现. 首先说一下nsis的优 ...
- 在ubuntu中docker的简单使用(一)
>>docker version 当运行docker version 命令出现Cannot connect to Docker daemon. Is the docker daemon r ...
- ES6初识-解构赋值
数组解构赋值 [a,b]=[1,2]; . 方法返回 function f(){ return [1,2] } let a,b; [a,b]=f();//a=1,b=2 function f1() ...
- MappingException:class com.zsn.crm.Model.user not found whie looking for property user id
之前好好地运行 什么东西都没动过 再次运行突然报异常*****MappingException:class com.zsn.crm.Model.user not found whie looking ...
- Apache+Tomcat+jk windows环境下的集群部署
记一次在Windows服务器上搭建apatch+tomcat+jk的集群搭建过程,其中也遇到了很多问题,总结一下. 一.准备工作 1.apache-tomcat-7.0.88 2.Apche http ...
- 记一次samba排错 Failed to start Samba SMB Daemon.
记录一次服务出错排错的过程,很多新手出了点错不百度直接巴拉巴拉的问,一般老手根据经验可以给出一点建议,但是由于个体环境的差异并不适用,反而埋怨起来.这种真的无F**K可说,所以要培养自己的排错能 ...
- Spring入门注解版
参照博文Spring入门一,以理解注解的含义. 项目结构: 实现类:SpringHelloWorld package com.yibai.spring.helloworld.impl; import ...
- struts2之输入验证
输入校验主要分为两种: 基于客户端的校验: 客户端校验主要作用是防止正常浏览者的误输入,仅能对输入进行初步过滤:对于一些用户恶意行为,客户端校验则无能为力. 基于服务端的校验: 服务器接收客户端提交的 ...