
抓取代理IP
写脚本从指定网站抓取数据的时候,免不了会被网站屏蔽IP。所以呢,就需要有一些IP代理。随便在网上找了一个提供免费IP的网站西刺做IP抓取。本次实践抓取的是其提供的国内匿名代理。可以打开网站查看一下源码,我们需要的内容在一个table区域内,通过BS4能很容易提取需要的信息。
Step 1:HTML页面获取
观察可以发现有我们需要的信息的页面url有下面的规律:www.xicidaili.com/nn/+页码。可是你如果直接通过get方法访问的话你会发现会出现500错误。原因其实出在这个规律下的url虽然都是get方法获得数据,但都有cookie认证。那么问题来了——怎么获得需要的cookie呢?
我们可以想一下,我们第一次通过浏览器访问该网站的主页是能打开的,其网站的各个子模块都可以打开。一定在某个时间段内我们的浏览器获得了该网站设置的cookie。清楚浏览器cookie,重新打开该网站首页,通过开发者工具可以发现我们打开首页的时候没有上传cookie,而是网站会下发cookie。接着打开我们上面找到的规律url页面,比对一下,发现我们上传的cookie就是在首页下发的cookie。这样就有办法了——编写脚本的时候,先访问一下首页获得cookie,再将获得的cookie添加到后续的请求中。
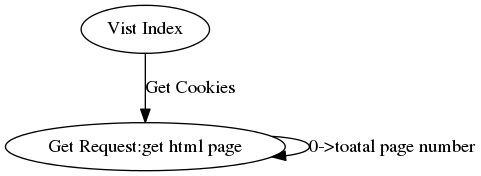
具体的代码如下:
import time

import json

import requests

from bs4 import BeautifulSoup

_headers={

			"Accept":"text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8",

			"Accept-Encoding":"gzip, deflate, sdch",

			"Accept-Language":"zh-CN,zh;q=0.8",

			"Cache-Control":"max-age=0",

			"Host":"www.xicidaili.com",

			"Referer":"http://www.xicidaili.com/nn/",

			"Upgrade-Insecure-Requests":"1",

			"User-Agent":"Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/46.0.2490.80 Safari/537.36"

			}

_cookies = None

def spider(total_page):

    url = "http://www.xicidaili.com/nn/"

    for i in range(1,total_page):

	if i % 100 == 0:

               #100个页面更新一次Cookie

		_cookies = requests.get("http://www.xicidaili.com/",headers=_headers).cookies

	r = requests.get(url+str(i),headers = _headers,cookies = _cookies)

	html_doc = r.text

	#print html_doc

	status_code = r.status_code

	print i,status_code

	r.close()

	with open("%s.html"%i,"w") as f:  #保存html,也可以直接信息提取

		f.write(html_doc.encode("utf-8"))

	time.sleep(1)

        _headers["Referer"]=url+str(i-1)

if __name__ == "__main__":

    _cookies = requests.get("http://www.xicidaili.com/",headers=_headers).cookies

    spider(200)
Step2 : 信息提取
分析html结构,使用BS4进行信息提取。具体代码如下:
from bs4 import BeautifulSoup

#import re

def parese(html_doc):

    ip_info = []

    soup = BeautifulSoup(html_doc,"lxml")

    for tag in soup.find_all(name = "table"):#,class_="odd"):#),attrs={"data-foo": "value"}):

	for tr in tag.find_all("tr",class_=True)#class_=True <=> re.compile("odd|")

		try:

			 tmp = tr.find_all("td",class_=None):

			 ip = tmp[0].string

			 port = tmp[1].string

		except:

			pass

		ip_info.append(zip(ip,port))

    return ip_info
抓取代理IP的更多相关文章
- python爬虫成长之路(二):抓取代理IP并多线程验证
上回说到,突破反爬虫限制的方法之一就是多用几个代理IP,但前提是我们得拥有有效的代理IP,下面我们来介绍抓取代理IP并多线程快速验证其有效性的过程. 一.抓取代理IP 提供免费代理IP的网站还挺多的, ...
- Python 爬虫抓取代理IP,并检测联通性
帮朋友抓了一些代理IP,并根据测试联的通性,放在了不通的文件夹下.特将源码分享 注意: 1,环境Python3.5 2,安装BeautifulSoup4 requests 代码如下: 1 2 3 4 ...
- python爬虫爬取代理IP
# #author:wuhao # #--*------------*-- #-****#爬取代理IP并保存到Excel----#爬取当日的代理IP并保存到Excel,目标网站xicidaili.co ...
- 爬虫爬取代理IP池及代理IP的验证
最近项目内容需要引入代理IP去爬取内容. 为了项目持续运行,需要不断构造.维护.验证代理IP. 为了绕过服务端对IP 和 频率的限制,为了阻止服务端获取真正的主机IP. 一.服务器如何获取客户端IP ...
- 自动爬取代理IP例子
import time import json import datetime import threading import requests from lxml import etree from ...
- 使用Python爬取代理ip
本文主要代码用于有代理网站http://www.kuaidaili.com/free/intr中的代理ip爬取,爬虫使用过程中需要输入含有代理ip的网页链接. 测试ip是否可以用 import tel ...
- python代理池的构建3——爬取代理ip
上篇博客地址:python代理池的构建2--代理ip是否可用的处理和检查 一.基础爬虫模块(Base_spider.py) #-*-coding:utf-8-*- ''' 目标: 实现可以指定不同UR ...
- 爬取代理IP
现在爬虫好难做啊,有些网站直接封IP,本人小白一个,还没钱,只能找免费的代理IP,于是去爬了西刺免费代理,结果技术值太低,程序还没调试好, IP又被封了... IP又被封了... IP又被封了... ...
- 爬取代理IP,并判断是否可用。
# -*- coding:utf-8 -*- from gevent import monkey monkey.patch_all() import urllib2 from gevent.pool ...
随机推荐
- chrome的自动缓存真是讨厌。
最近老是遇到这样一个问题,为什么我的代码改了,页面却一点变化都没有,难道代码错了,打开chrome的调试窗口一看,md,页面根本就没有刷新,逗你爹玩儿呢. 不过幸好,这该死的缓存是可以关闭的. F12 ...
- InnoSetup 如何获取安装程序的路径?
两个常量可以使用: {srcexe} 安装程序执行文件的路径. {src} 安装程序所在路径. path := ExpandConstant('{srcexe}');
- Nightmare基于phantomjs的自动化测试套件
今天将介绍一款自动化测试套件名叫nightmare,他是一个基于phantomjs的测试框架,一个基于phantomjs之上为测试应用封装的一套high level API.其API以goto, re ...
- [.net 面向对象程序设计进阶] (4) 正则表达式 (三) 表达式助手
[.net 面向对象程序设计进阶] (2) 正则表达式(三) 表达式助手 上面两节对正则表达式的使用及.NET下使用正则表达式作了详细说明,本节主要搜集整理了常用的正则表达式提供参考. 此外为了使用方 ...
- Android移动APP开发笔记——最新版Cordova 5.3.1(PhoneGap)搭建开发环境
引言 简单介绍一下Cordova的来历,Cordova的前身叫PhoneGap,自被Adobe收购后交由Apache管理,并将其核心功能开源改名为Cordova.它能让你使用HTML5轻松调用本地AP ...
- 微信授权步骤与详解 -- c#篇
微信授权步骤与详解 -- c#篇 注:这里不涉及界面操作,只介绍代码操作. 1.基本原理如下: 从图上所知,第一步用户访问我们的网页,第二步我们后台跳转到微信授权页面,第三步用户点击授权,第四步微信重 ...
- Atitit 发帖机系列(7) 词法分析的方法attilax大总结)
Atitit 发帖机系列(7) 词法分析的方法attilax大总结) 1.1. 词法分析貌似俩大方法,一个直接根据状态图转换,一个根据dfa1 1.2. switchcase或者ifelse 最原始方 ...
- Atitit main函数的ast分析 数组参数调用的ast astview解析
Atitit main函数的ast分析 数组参数调用的ast astview解析 1.1. Xxcls.main(new String[]{"","bb"}) ...
- Atitit 为什么网络会有延时 电路交换与分组交换的区别
Atitit 为什么网络会有延时 电路交换与分组交换的区别 按道理,网络是电子设备联网,应该达到光速才对.. 本质上因为互联网基于分组交换而不是电路交换. 分组交换相当于队列方式,别人发你的数据包先存 ...
- 无服务端纯前台导出数据到Excel-JSExcelXML.js 使用指南
JSExcelXML 使用指南 先来个效果预览 a.前端显示 b.导出excel效果 表头部分 表尾部分 1.功能描述 JsExcelXml 采用js生成excel中可显示的xml格式文本,将输出文本 ...