
Hive Hooks介绍
Hive作为SQL on Hadoop最稳定、应用最广泛的查询引擎被大家所熟知。但是由于基于MapReduce,查询执行速度太慢而逐步引入其他的近实时查询引擎如Presto等。值得关注的是Hive目前支持MapReduce、Tez和Spark三种执行引擎,同时Hive3也会支持联邦数据查询的功能。所以Hive还是有很大进步的空间的。
当然,诸如SparkSQL和Presto有着他们非常合适的应用场景,我们的底层也是会有多种查询引擎存在,以应对不同业务场景的数据查询服务。但是由于查询引擎过多也会导致用户使用体验不好,需要用户掌握多种查询引擎,而且要明确知道各个引擎的适用场景。而且多种SQL引擎各自提供服务会对数据仓库建设过程中的血缘管理、权限管理、资源利用都带来较大的困难。
之前对于底层平台的统一SQL服务有考虑过在上层提供一层接口封装,进行SQL校验、血缘管理、引擎推荐、查询分发等等,但是各个引擎之间的语法差异较大,想要实现兼容的SQL层有点不太现实。最近看了快手分享的《SQL on Hadoop 在快手大数据平台的实践与优化》,觉得有那么点意思。大家有兴趣的话可以看一看。
其实快手的实现核心逻辑是一样的,有一个统一的SQL入口,提供SQL校验,SQL存储、引擎推荐、查询分发进而实现血缘管理等。优秀的是它基于Hive完成了上述工作,将Hive作为统一的入口而不是重新包装一层。既利用了HiveServer2的架构,又做到了对于用户的感知最小。而实现这些功能的基础就是Hive Hooks,也就是本篇的重点。
Hook是一种在处理过程中拦截事件,消息或函数调用的机制。 Hive hooks是绑定到了Hive内部的工作机制,无需重新编译Hive。所以Hive Hook提供了使用hive扩展和集成外部功能的能力。 我们可以通过Hive Hooks在查询处理的各个步骤中运行/注入一些代码,帮助我们实现想要实现的功能。
根据钩子的类型,它可以在查询处理期间的不同点调用:
Pre-semantic-analyzer hooks:在Hive在查询字符串上运行语义分析器之前调用。
Post-semantic-analyzer hooks:在Hive在查询字符串上运行语义分析器之后调用。
Pre-driver-run hooks:在driver执行查询之前调用。
Post-driver-run hooks:在driver执行查询之后调用。
Pre-execution hooks:在执行引擎执行查询之前调用。请注意,这个目的是此时已经为Hive准备了一个优化的查询计划。
Post-execution hooks:在查询执行完成之后以及将结果返回给用户之前调用。
Failure-execution hooks:当查询执行失败时调用。
由以上的Hive Hooks我们都可以得出Hive SQL执行的生命周期了,而Hive Hooks则完整的贯穿了Hive查询的整个生命周期。
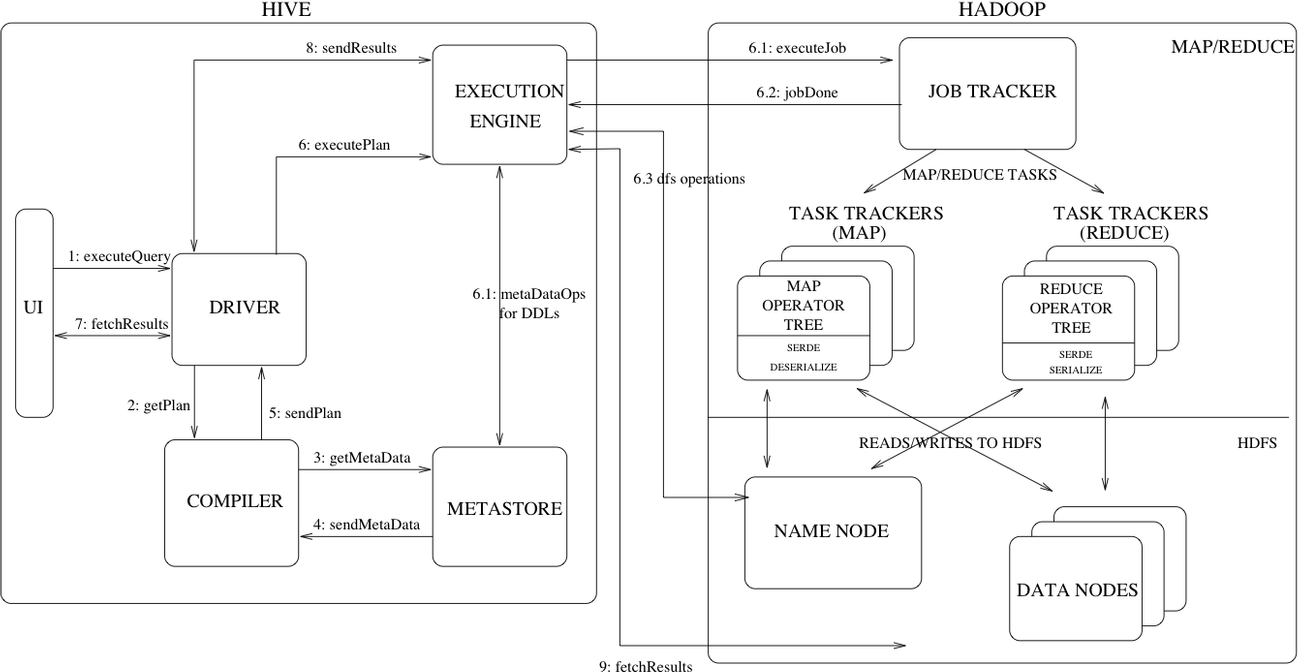
对于Hive Hooks有了初步理解之后,后面我们会通过示例介绍如何实现一个Hive Hook,并且尝试一下如何基于Hive实现统一的SQL查询服务。
Hive Hooks介绍的更多相关文章
- Hive 接口介绍(Web UI/JDBC)
Hive 接口介绍(Web UI/JDBC) 实验简介 本次实验学习 Hive 的两种接口:Web UI 以及 JDBC. 一.实验环境说明 1. 环境登录 无需密码自动登录,系统用户名shiyanl ...
- Hive QL 介绍
小结 本次课程学习了 Hive QL 基本语法和操作. 一.实验环境说明 1. 环境登录 无需密码自动登录,系统用户名shiyanlou,密码shiyanlou 2. 环境介绍 本实验环境采用带桌面的 ...
- Hive权限介绍
一.开启权限 眼下hive支持简单的权限管理,默认情况下是不开启.这样全部的用户都具有同样的权限.同一时候也是超级管理员.也就对hive中的全部表都有查看和修改的权利,这样是不符合一般数据仓库的安全原 ...
- Hive体系结构介绍
http://www.aboutyun.com/thread-6217-1-1.html 1.Hive架构与基本组成 下面是Hive的架构图. 图1.1 Hive体系结构 Hive ...
- Hive学习之一 《Hive的介绍和安装》
一.什么是Hive Hive是建立在 Hadoop 上的数据仓库基础构架.它提供了一系列的工具,可以用来进行数据提取转化加载(ETL),这是一种可以存储.查询和分析存储在 Hadoop 中的大规模数据 ...
- Hive 体系结构介绍
下面是Hive的架构图. 图1.1 Hive体系结构 Hive的体系结构可以分为以下几部分: (1)用户接口主要有三个:CLI,Client 和 WUI.其中最常用的是CLI,Cli启动的时候,会同时 ...
- Hive入门笔记---1.Hive简单介绍
1. Hive是什么 Hive是基于Hadoop的数据仓库解决方案.由于Hadoop本身在数据存储和计算方面有很好的可扩展性和高容错性,因此使用Hive构建的数据仓库也秉承了这些特性.这是来自官方的解 ...
- Hive基本介绍
4.1 基本介绍: Hive是基于Hadoop的一个数据仓库工具,可以将结构化的数据文件映射为一张数据库表,并提供完整的sql查询功能,可以将sql语句转换为MapReduce任务进行运行.其优点是学 ...
- Hive函数介绍
一些函数不太会,查了些资料,分享一下 Hive已定义函数介绍: 1.字符串长度函数:length 语法: length(string A)返回值: int举例:[sql] view plain cop ...
随机推荐
- sharding调试setAutoCommit
emmm应该是有manager的 因为指定了@Primary 不然容器启动的时候创建sessionFactory就因为多个DataSource异常了,后面会滚的时候manager为null也会有运行时 ...
- 简单RTSCamera实现
using System.Collections; using System.Collections.Generic; using UnityEngine; public class TopCamer ...
- 学习abp vnext框架到精简到我的Vop框架
学习目标 框架特点 基于.NET 5平台开发 模块化系统 极少依赖 极易扩展 ....... 框架目的 学习.NET 5平台 学习abp vnext 上图大部分功能已经实现,多数是参考(copy)ab ...
- Spring Cloud 学习 (八) Spring Boot Admin
Spring Boot Admin 用于管理和监控一个或者多个 Spring Boot 程序 新建 spring-boot-admin-server pom <parent> <ar ...
- Spring Cloud 学习 (五) Zuul
Zuul 作为路由网关组件,在微服务架构中有着非常重要的作用,主要体现在以下 6 个方面: Zuul, Ribbon 以及 Eureka 相结合,可以实现智能路由和负载均衡的功能,Zuul 能够将请求 ...
- 20190713_windows 2008 R2在启动网站时报错_另一个程序正在使用此文件,进程无法访问
80端口已经被占用了; 换个端口就好了, 如果你是云服务器, 记得控制台也要开放对应的端口
- MySQL慢查询日志(SLOW LOG)
慢查询日志可以帮助DBA或开发人员定位可能存在问题的SQL语句,从而进行优化. 如何开启 默认情况下,MySQL是不开启慢查询日志的.可以通过以下命令查看是否开启: mysql> SHOW VA ...
- Python的富比较方法__le__、__ge__之间的关联关系分析
Python的富比较方法包括__le__.__ge__分别表示:小于等于.大于等于,对应的操作运算符为:"<=".">=".那么是否象普通数字运算一 ...
- PyQt(Python+Qt)学习随笔:QHeaderView.ResizeMode取值及含义
老猿Python博文目录 专栏:使用PyQt开发图形界面Python应用 老猿Python博客地址 关于ResizeMode的使用请参考<PyQt(Python+Qt)学习随笔:QTableWi ...
- PyQt(Python+Qt)学习随笔:QTableWidgetItem项的复选状态checkState访问方法
老猿Python博文目录 专栏:使用PyQt开发图形界面Python应用 老猿Python博客地址 QTableWidget表格部件中的QTableWidgetItem项可以单独设置复选状态,如图所有 ...