
80行Python代码搞定全国区划代码
微信搜索:码农StayUp
主页地址:https://gozhuyinglong.github.io
源码分享:https://github.com/gozhuyinglong/blog-demos
1. 前言
在网站建设中一般会用到全国行政区域划分,以便于做区域数据分析。
下面我们用 Python 来爬取行政区域数据,数据来源为比较权威的国家统计局。爬取的页面为2020年统计用区划代码和城乡划分代码。
这里有个疑问,为啥统计局只提供了网页版呢?提供文件版岂不是更方便大众。欢迎了解的小伙伴给我留言。
2. 网站分析
在爬取数据之前要做的便是网站分析,通过分析来判断使用何种方式来爬取。
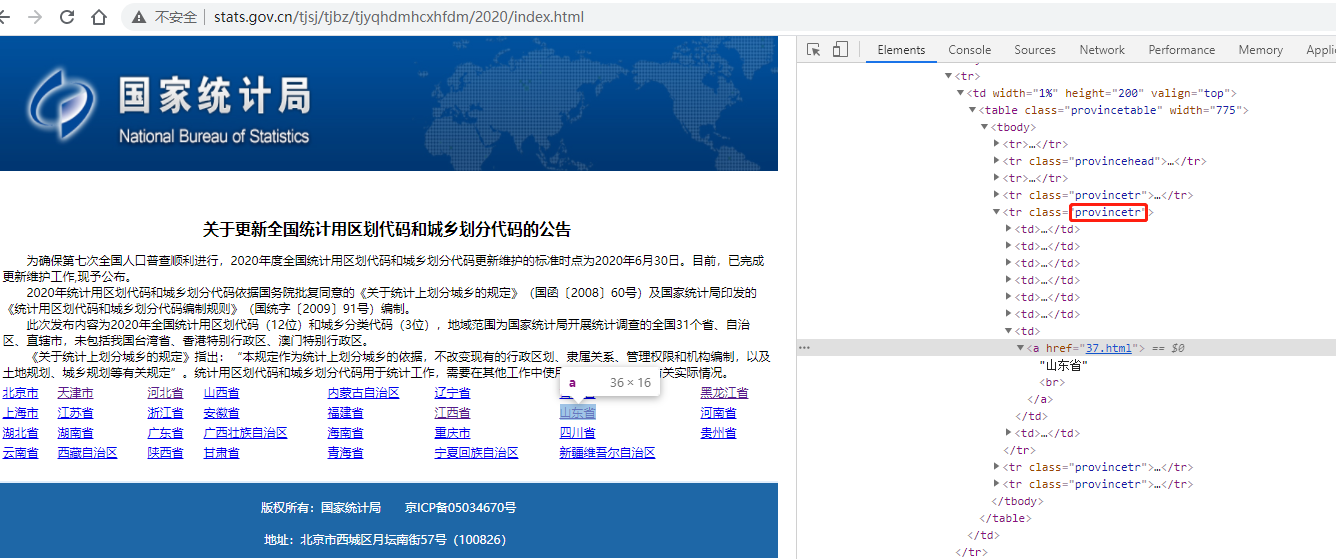
2.1 省份页面
一个静态页面,其二级页面使用的是相对地址,通过 class=provincetr 的tr元素来定位
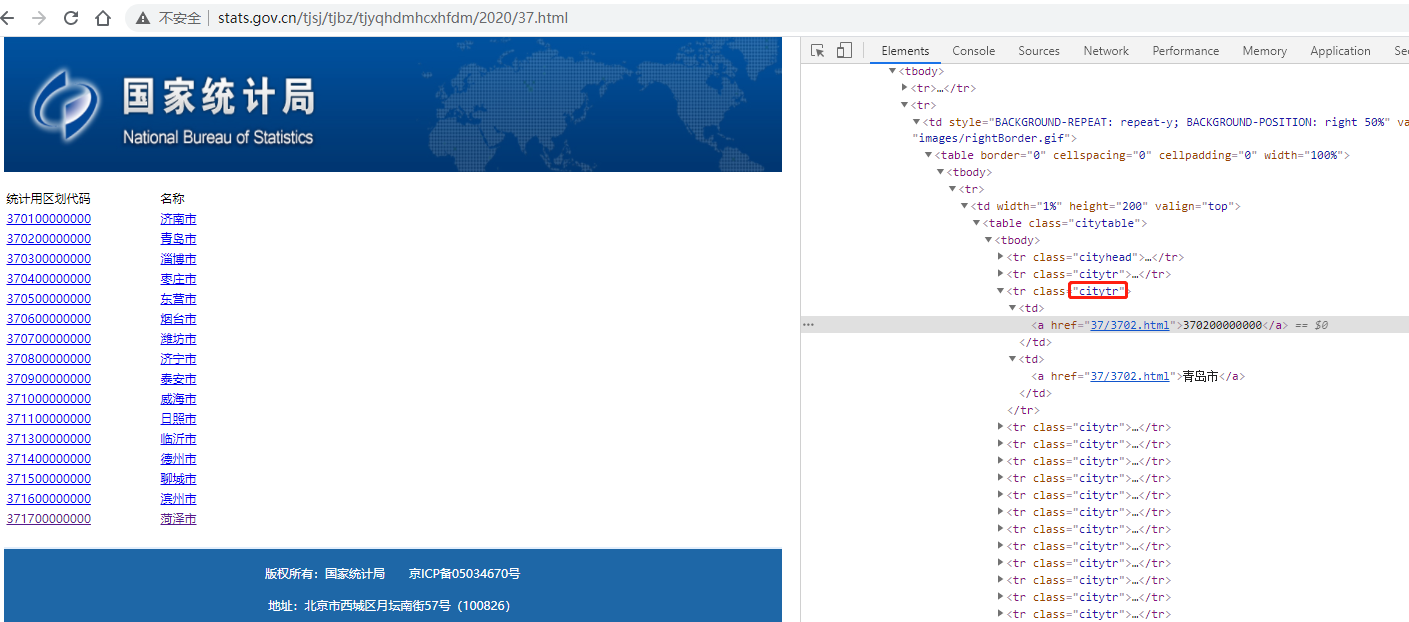
2.2 城市页面
一个静态页面,其二级页面使用的是相对地址,通过 class=citytr 的tr元素来定位
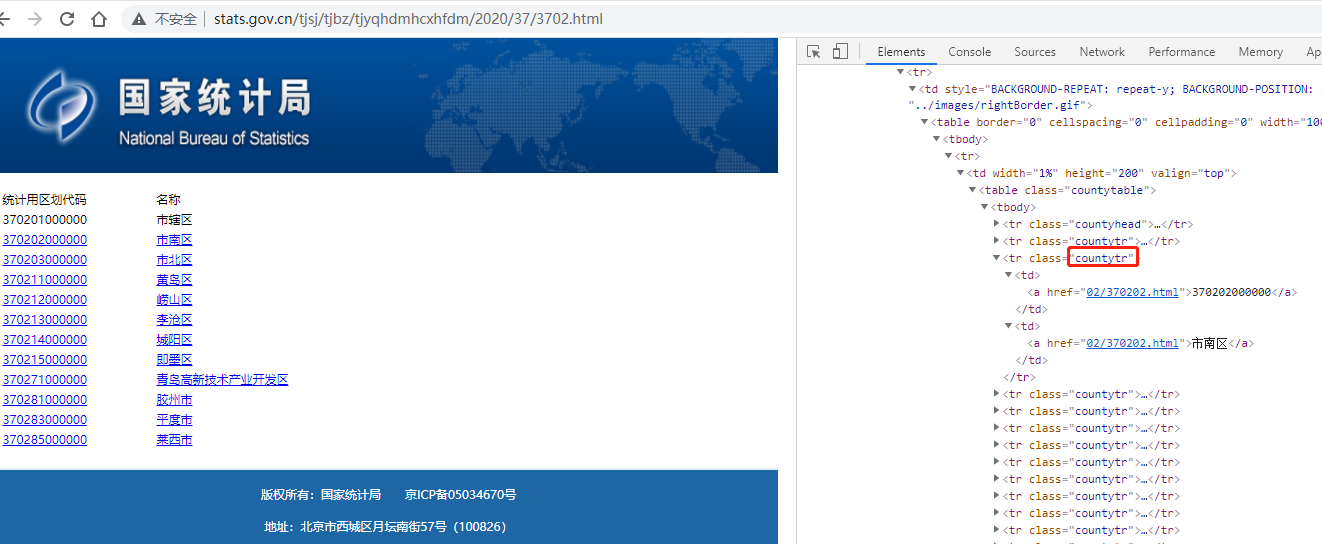
2.3 区县页面
一个静态页面,其二级页面使用的是相对地址,通过 class=countytr 的tr元素来定位
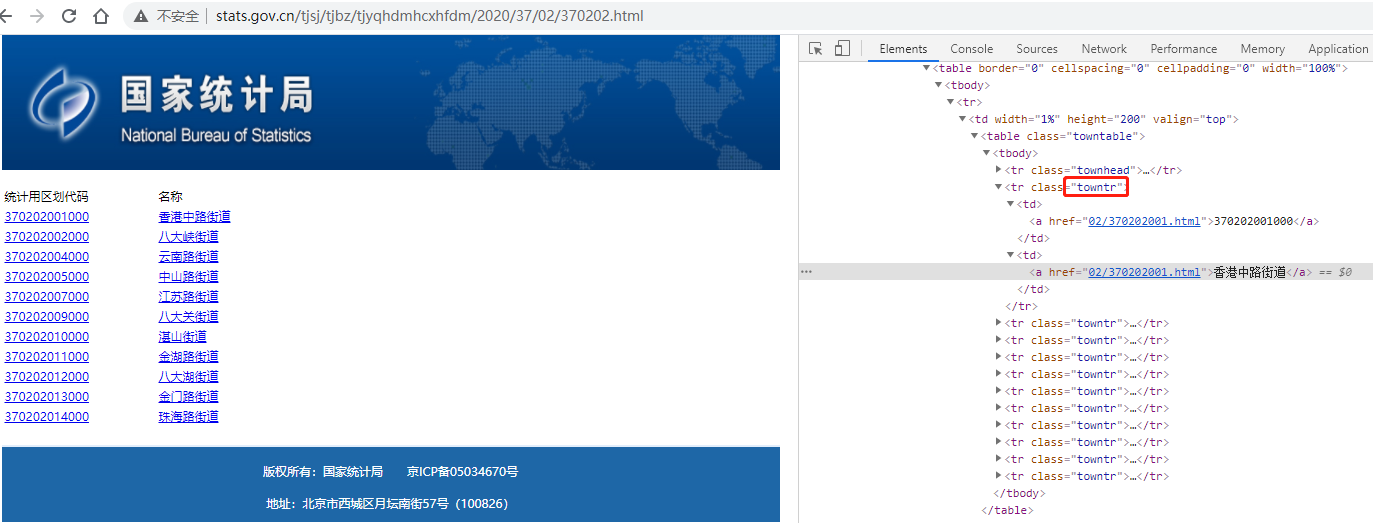
2.4 城镇页面
一个静态页面,其二级页面使用的是相对地址,通过 class=towntr 的tr元素来定位
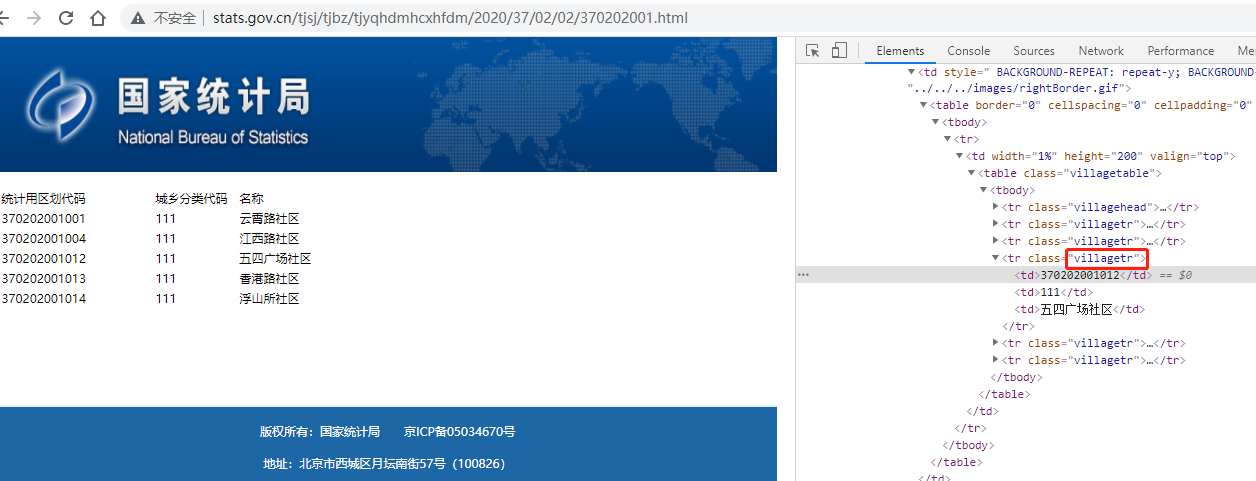
2.5 村庄页面
一个静态页面,没有二级页面,通过 class=villagetr 的tr元素来定位
3. 安装所需库
通过上面的分析,使用爬取静态网页的方式即可。下面是一些必要的库,需要提前安装好:Requests、BeautifulSoup、lxml。
3.1 Requests
Requests 是一个 Python 的 HTTP 客户端库,用于访问 URL 网络资源。
安装Requests库:
pip install requests
3.2 BeautifulSoup
Beautifu lSoup 是一个可以从 HTML 或 XML 文件中提取数据的 Python 库。它能够通过指定的转换器实现页面文档的导航、查找、修改等。
安装 BeautifulSoup 库:
pip install beautifulsoup4
3.3 lxml
lxml 是一种使用 Python 编写的库,可以迅速、灵活地处理 XML 和 HTML。
它支持 XML Path Language (XPath) 和 Extensible Stylesheet Language Transformation (XSLT),并且实现了常见的 ElementTree API。
安装lxml库:
pip install lxml
4. 代码实现
爬虫分以下几步:
- 使用Requests库来获取网页。
- 使用BeautifulSoup和lxml库解析网页。
- 使用Python的File来存储数据。
输出文件为:当前py文件所在目录,文件名称:area-number-2020.txt
输出结果为:级别、区划代码、名称,中间使用制表符分隔,便于存到Exce和数据库中。
下面看详细代码:
# -*-coding:utf-8-*-

import requests

from bs4 import BeautifulSoup

# 根据地址获取页面内容,并返回BeautifulSoup

def get_html(url):

    # 若页面打开失败,则无限重试,没有后退可言

    while True:

        try:

            # 超时时间为1秒

            response = requests.get(url, timeout=1)

            response.encoding = "GBK"

            if response.status_code == 200:

                return BeautifulSoup(response.text, "lxml")

            else:

                continue

        except Exception:

            continue

# 获取地址前缀(用于相对地址)

def get_prefix(url):

    return url[0:url.rindex("/") + 1]

# 递归抓取下一页面

def spider_next(url, lev):

    if lev == 2:

        spider_class = "city"

    elif lev == 3:

        spider_class = "county"

    elif lev == 4:

        spider_class = "town"

    else:

        spider_class = "village"

    for item in get_html(url).select("tr." + spider_class + "tr"):

        item_td = item.select("td")

        item_td_code = item_td[0].select_one("a")

        item_td_name = item_td[1].select_one("a")

        if item_td_code is None:

            item_href = None

            item_code = item_td[0].text

            item_name = item_td[1].text

            if lev == 5:

                item_name = item_td[2].text

        else:

            item_href = item_td_code.get("href")

            item_code = item_td_code.text

            item_name = item_td_name.text

        # 输出:级别、区划代码、名称

        content2 = str(lev) + "\t" + item_code + "\t" + item_name

        print(content2)

        f.write(content2 + "\n")

        if item_href is not None:

            spider_next(get_prefix(url) + item_href, lev + 1)

# 入口

if __name__ == '__main__':

    # 抓取省份页面

    province_url = "http://www.stats.gov.cn/tjsj/tjbz/tjyqhdmhcxhfdm/2020/index.html"

    province_list = get_html(province_url).select('tr.provincetr a')

    # 数据写入到当前文件夹下 area-number-2020.txt 中

    f = open("area-number-2020.txt", "w", encoding="utf-8")

    try:

        for province in province_list:

            href = province.get("href")

            province_code = href[0: 2] + "0000000000"

            province_name = province.text

            # 输出:级别、区划代码、名称

            content = "1\t" + province_code + "\t" + province_name

            print(content)

            f.write(content + "\n")

            spider_next(get_prefix(province_url) + href, 2)

    finally:

        f.close()
5. 资源下载
如果你只是需要行政区域数据,那么已经为你准备好了,从下面连接中下载即可。
链接:https://pan.baidu.com/s/18MDdkczwJVuRZwsH0pFYwQ
提取码:t2eg
6. 爬虫遵循的规则
引自:https://www.cnblogs.com/kongyijilafumi/p/13969361.html
- 遵守 Robots 协议,谨慎爬取
- 限制你的爬虫行为,禁止近乎 DDOS 的请求频率,一旦造成服务器瘫痪,约等于网络攻击
- 对于明显反爬,或者正常情况不能到达的页面不能强行突破,否则是 Hacker 行为
- 如果爬取到别人的隐私,立即删除,降低进局子的概率。另外要控制自己的欲望
80行Python代码搞定全国区划代码的更多相关文章
- 10行代码搞定移动web端自定义tap事件
发发牢骚 移动web端里摸爬滚打这么久踩了不少坑,有一定移动web端经验的同学一定被click困扰过.我也不列外.一路走来被虐的不行,fastclick.touchend.iscroll什么的都用过, ...
- 30行代码搞定WCF并发性能测试
[以下只是个人观点,欢迎交流] 30行代码搞定WCF并发性能 轻量级测试. 1. 调用并发测试接口 static void Main() { List< ...
- 180行ruby代码搞定游戏2048
最今在玩2048这款小游戏,游戏逻辑简单,很适合我这样的对于游戏新入行的人来实现逻辑.于是选择了最拿手的ruby语言来实现这款小游戏的主要逻辑.还是挺简单的,加起来4小时左右搞定. 上代码: requ ...
- 5行js代码搞定导航吸顶效果
一.HTML布局 首先写HTML布局 <body> <div id="wrap"></div> </body> 二.CSS样式 给点 ...
- 3kb jQuery代码搞定各种树形选择。
自制Jquery树形选择插件. 对付各种树形选择(省市,分类..)90行Jquery代码搞定,少说废话直接上插件代码.稍后介绍使用说明.是之前写的一个插件的精简版. 1.Jquery插件代码 /* * ...
- Asp.Net Core 轻松学-一行代码搞定文件上传 JSONHelper
Asp.Net Core 轻松学-一行代码搞定文件上传 前言 在 Web 应用程序开发过程中,总是无法避免涉及到文件上传,这次我们来聊一聊怎么去实现一个简单方便可复用文件上传功能:通过创建 ...
- 一行代码搞定 FTP 服务
环境搭建: python windows/linux pip install pyftpdlib (安装失败请到这里下载:https://pypi.python.org/pypi/pyftpdlib/ ...
- 开源作品ThinkJDBC—一行代码搞定数据库操作
1 简介 ThinkJD,又名ThinkJDBC,一个简洁而强大的开源JDBC操作库.你可以使用Java像ThinkPHP框架的M方法一样,一行代码搞定数据库操作.ThinkJD会自动管理数据库连接, ...
- jquery侧边折叠导航栏制作,两行代码搞定
jquery侧边折叠导航栏制作,两行代码搞定 //CSS*{margin: 0;padding: 0} ul{list-style: none} .menu li ul{display: none} ...
随机推荐
- cfsetispeed、cfsetospeed和cfsetspeed探究
在我https://www.cnblogs.com/Suzkfly/p/11055532.html这篇博客中有一个疑问,就是在串口设置波特率的域中,没有将输入输出波特率分开,那为什么会有几个不同的设置 ...
- Java并发组件三之Semaphore
使用场景:常用于使用有限的资源,限制线程并发的最大数量.默认情况下,信号量是非公平性的(先等待先执行为公平.类似于买东西的时候大家排队付款,先来的先付款是公平的.但是这时候有人插队,那就是非公平的)设 ...
- Edition-Based Redefinition
Oracle在11g引入了Edition-Based Redefinition(EBR),主要是为了解决在更新数据库对象,比如PL/SQL程序,视图等,如果该对象被锁住了,会导致更新必须等待,如果要使 ...
- 宝塔Linux命令
安装宝塔 Centos安装脚本 5.7:yum install -y wget && wget -O install.sh http://download.bt.cn/install/ ...
- 题解 P3833 【[SHOI2012]魔法树】
题目 直通车 很显然这是个树刨的板子,树上链查询和子树查询 注意: 1.这个点的树根为 0 而不是 1 所以注意读图时点标号 +1 就解决了 2.注意数据范围\(2^{32}\) 然后板子就能过了 n ...
- Docker运行Mysql,Redis,SpringBoot项目
Docker运行Mysql,Redis,SpringBoot项目 1.docker运行mysql 1.1拉取镜像 1.2启动容器 1.3进入容器 1.4开启mysql 1.5设置远程连接 1.6查看版 ...
- Django(中间件)
中间件的概念 中间件顾名思义,是介于request与response处理之间的一道处理过程,相对比较轻量级,并且在全局上改变django的输入与输出.因为改变的是全局,所以需要谨慎实用,用不好会影响到 ...
- docker(mysql-redmine)
一.安装docker 首先查看自己的版本,我的是centos 版本为 [root@localhost redmine]# uname -r 3.10.0-862.el7.x86_64 移除旧版本 yu ...
- CSS(简介or选择器)
我们为什么需要CSS? 使用css的目的就是让网页具有美观一致的页面,另外一个最重要的原因是内容与格式分离 在没有CSS之前,我们想要修改HTML元素的样式需要为每个HTML元素单独定义样式属性,当H ...
- OpenStack (neutron 网络服务)
neutron介绍 提供 OpenStack 虚拟网络服务,也是 OpenStack 重要的核心模块之一,该模块最开始是 Nova 的一部分,叫 nova-network,后来从 Nova 中分离出来 ...