
Information Retrieval
【Information Retrieval】
1、信息检索/获取(Information Retrieval,简称IR) 是从大规模非结构化数据(通常是文本)的集合(通常保存在计算机上)中找出满足用户信息需求的资料(通常是文档)的过程。
2、布尔检索模型
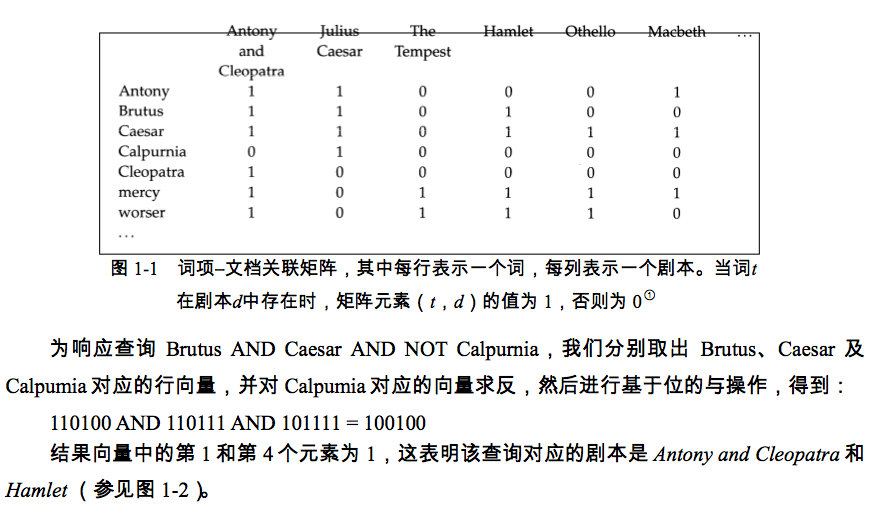
3、文档(document)是信息检索系统的检索对象,它们可以是一条条单独的记录或者是一本书的各章。
4、所有文档组成的文档集(collection),有时也称为语料库(corpus)。
5、检索系统的效果(effectiveness):
1)正确率:返回的结果中真正和信息需求相关的文档所占的百分比。
2)召回率:所有和信息需求真正相关的文档中被检索系统返回的百分比。
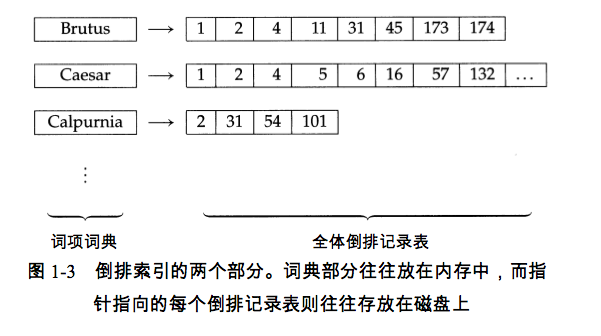
6、倒排索引(inverted index),是一个从词项(term,词项的集合也叫 dictionary / vocabulary / lexicon)到倒排记录表(posting list / inverted list)的一张表,所有词的倒排记录表构成全休倒排记录表(postings)。
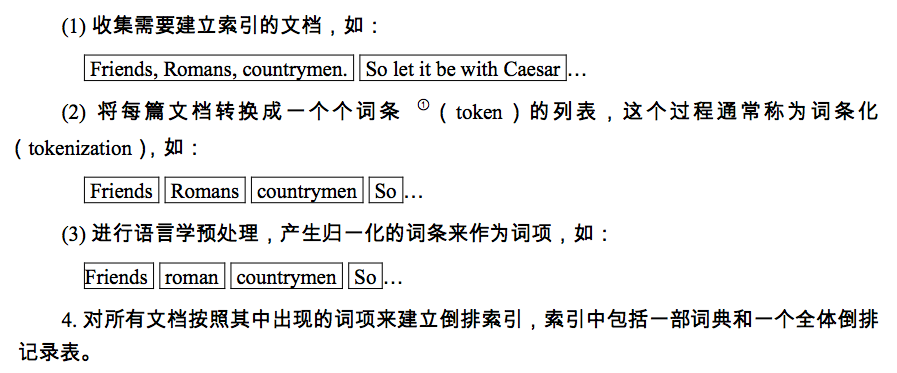
7、建立索引主要步骤:
8、建立倒排索引
给定一个文档集,我们假定每篇文档都有一个唯一的标识符即编号(docID)。在索引构建 过程中,我们可以给每篇新出现的文档赋一个连续的整数编号。在上述的前 3 步处理结束后, 对每篇文档建立索引时的输入就是一个归一化的词条表,也可以看成二元组(词项,文档 ID) 的一个列表(参见图 1-4)。建立索引最核心的步骤是将这个列表按照词项的字母顺序进行排序, 之后我们得到下图中部显示的结果,其中一个词项在同一文档中的多次出现会合并在一起 1, 最后整个结果分成词典和倒排记录表两部分。
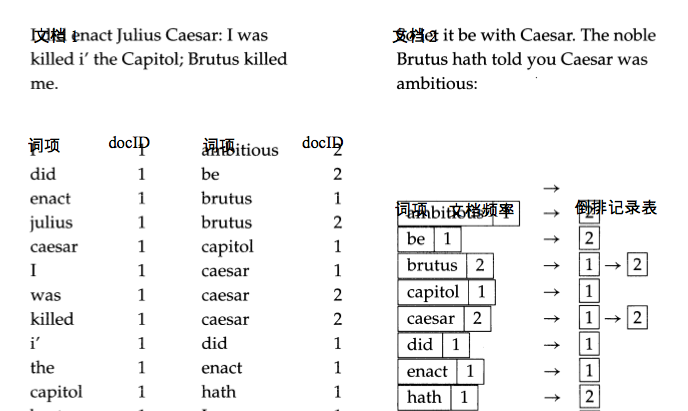
在最终得到的倒排索引中,词典和倒排记录表都有存储开销。前者往往放在内存中,而后 者由于规模大得多,通常放在磁盘上。
9、倒排记录表的存储方式:
1)单链表。
2)变长数组,定长数组链表。
11. 查询优化, 对于下述查询, 一个启发式的想法是, 按照词项的文档频率(也就是倒排记录表的长度)从小到大依次进行处理,如果我们先合并两个最短的倒排记录表,那么所有中间结果的大小都不会超过最短的倒排记录表
Brutus AND Caesar AND Calpurnia
Information Retrieval的更多相关文章
- Information retrieval信息检索
https://en.wikipedia.org/wiki/Information_retrieval 信息检索 (一种信息技术) 信息检索(Information Retrieval)是指信息按一定 ...
- Deep Learning for Information Retrieval
最近关注了一些Deep Learning在Information Retrieval领域的应用,得益于Deep Model在对文本的表达上展现的优势(比如RNN和CNN),我相信在IR的领域引入Dee ...
- Information Retrieval 倒排索引 学习笔记
一,问题描述 在Shakespeare文集(有很多文档Document)中,寻找哪个文档包含了单词“Brutus”和"Caesar",且不包含"Calpurnia&quo ...
- Information Retrieval II
[Information Retrieval II] 搜索引擎分类: 1.目录式搜索引擎. 2.全文搜索引擎. 3.元搜索引擎(Meta-Search Engine). 搜索引擎的4个阶段:下载(cr ...
- Music information retrieval
Music information retrieval - Wikipedia https://en.wikipedia.org/wiki/Music_information_retrieval Mu ...
- Information retrieval (IR class1)
1. 什么是IR? IR与数据库的区别? 答:数据库是检索结构化的数据,例如关系数据库:而信息检索是检索非结构化/半结构化的数据,例如:一系列的文本.信息检索是属于NLP(自然语言处理)里面最实用的一 ...
- IRGAN:A Minimax Game for Unifying Generative and Discriminative Information Retrieval Models
https://arxiv.org/pdf/1705.10513.pdf 论文阅读笔记: https://www.cnblogs.com/liaohuiqiang/p/9694277.html htt ...
- Information retrieval (IR class2)
1. 解析文档一般要分析哪些方面? - 首先分析文档的格式,是docx,html,xml,pdf... - 其次分析文档的语言,是英语,汉语,日语,德语... - 使用的什么字符集,ASCII编码, ...
- information retrieval (CMU 11642)
1. Heap's law. predict the number of new vocabulary. 参考:https://www.youtube.com/watch?v=JDp12gU-vEQ ...
随机推荐
- HTML5和XHTML的区别
既然被问到了HTML5和XHTML的区别,那我就在这里给大家分享一些我个人的理解,同时我也觉得从他们的来源上讲,他们藏着一个有趣的故事. 首先认识三个组织,IETF (Internet Enginee ...
- 20155230 2016-2017-2 《Java程序设计》第八周学习总结
20155230 2016-2017-2 <Java程序设计>第八周学习总结 教材学习内容总结 java.util.logging包提供了日志功能相关类与接口,使用日志的起点是logger ...
- 为什么要使用索引?-Innodb与Myisam引擎的区别与应用场景
Innodb与Myisam引擎的区别与应用场景 http://www.cnblogs.com/changna1314/p/6878900.html https://www.cnblogs.com/ho ...
- Linux内核静态映射表的建立过程
/* * 平台: s5pv210 * 内核版本号: 2.6.35.7 */ kernel/arch/arm/mach-s5pv210/mach-smdkc110.c 这个文件是由三星在 ...
- 固件_Linux内核
1.相关函数 .相关函数 int request_firmware_nowait( struct module *module, bool uevent, const char *name, stru ...
- hadoop之 YARN配置参数剖析—RM与NM相关参数
参数均需要在yarn-site.xml中配置: 1. ResourceManager相关配置参数 (1) yarn.resourcemanager.address 参数解释:ResourceManag ...
- php在循环内外实例化类占用内存比较
关于php类的实例化和内存的关系,可以这么说:只要有一个new 关键字就是创建一个对象,创建一个对象就是在内存中分配了一个空间. 代码1: 在循环外实例化类:class ABC{ public $nu ...
- open_input_file函数调用结构图(转)
open_input_file函数调用结构图(有些重复的函数调用就略掉了,大致是按流程往下的). 函数大致说明: AVFormatContext *avformat_alloc_context(voi ...
- 基于ffmpeg静态库的应用开发
最近几天在试着做基本ffmpeg静态库的开发,只有main中包含了avdevice_register_all 或avfilter_register_all,编译就通不过,undefined refre ...
- 完全卸载vs2013、vs2015的方法
Visual Studio安装过程会安装好多组件,如果想要卸载的话会出现一些因难,在控制面板不容易卸载干净,在Linux下的命令都有--help参数来显示命令的用法,今天突发奇想,在控制台下输入vs2 ...