
6.1 Spark SQL
一、从shark到Spark SQL
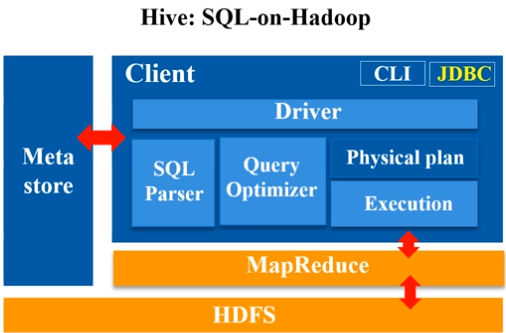
Hive能够把SQL程序转换成map-reduce程序
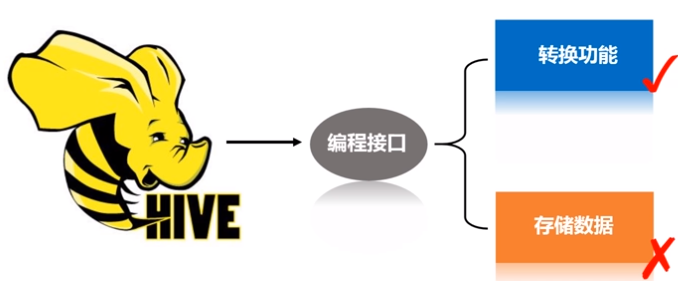
可以把Hadoop中的Hive看作是一个接口,主要起到了转换的功能,并没有实际存储数据。

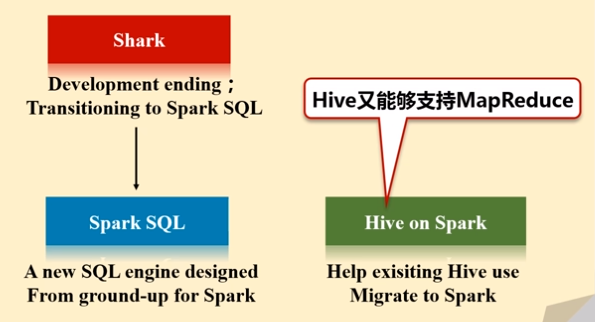
Shark即Hive on Spark,为了实现与Hive兼容,Shark在HiveQL方面重用了Hive中HiveQL的解析、逻辑执行计划翻译、执行计划优化等逻辑,可以近似认为仅将物理执行计划从MapReduce作业替换成了Spark作业,通过Hive的HiveQL解析,把HiveQL翻译成Spark上的RDD操作(shark相当于是hive的引进版,它把hive里的各种模块,基本上一五一十地照搬过来,就做了一个最底层的修改,hive是从最底层转成MapReduce程序,而到了shark,它的其他模块都没变,就把最底层翻译成spark应用程序。)
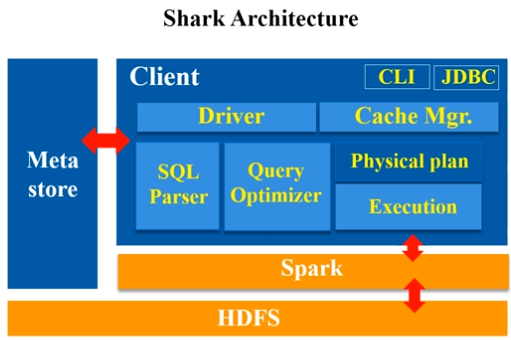 、
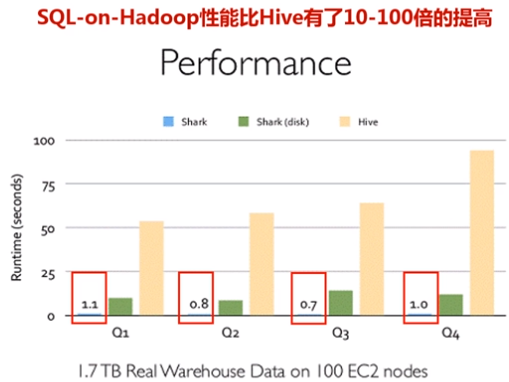
Shark的出现,使得SQL-on-Hadoop的性能比Hive有了10-100倍的提高
因为shark是基于hive修改的,会带来两个问题:
1)执行计划优化完全依赖于Hive,不方便添加新的优化策略;
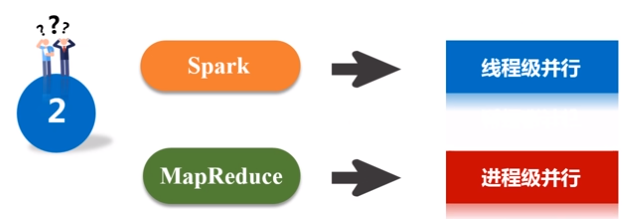
2)spark是线程级并行,MapReduce是进程级并行,因此,Spark在兼容Hive的实现上存在线程安全问题,导致Shark不得不使用另外一套独立维护的打了补丁的Hive源码分支
2014年6月1日Shark项目和SparkSQL项目的主持人Reynold Xin宣布:停止对Shark的开发,团队将所有资源放SparkSQL项目上,至此,Shark的发展画上了句话,但也因此发展出两个直线:SparkSQL和Hive on Spark
- Spark SQL作为Spark生态的一员继续发展,而不再受限于Hive,只是兼容Hive
- Hive on Spark是一个Hive的发展计划,该计划将Spark作为Hive的底层引擎之一,也就是说,Hive将不再受限于一个引擎,可以采用Map-Reduce、Tez、Spark等引擎
二、Spark SQL设计
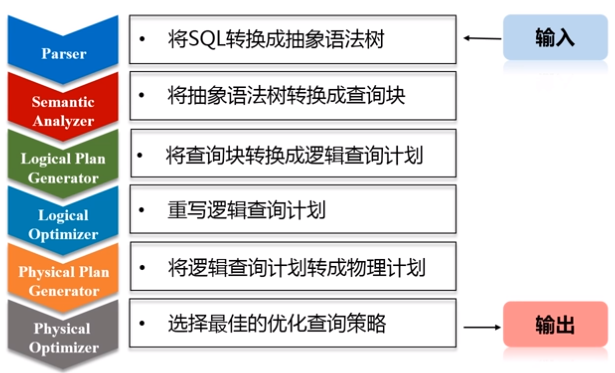
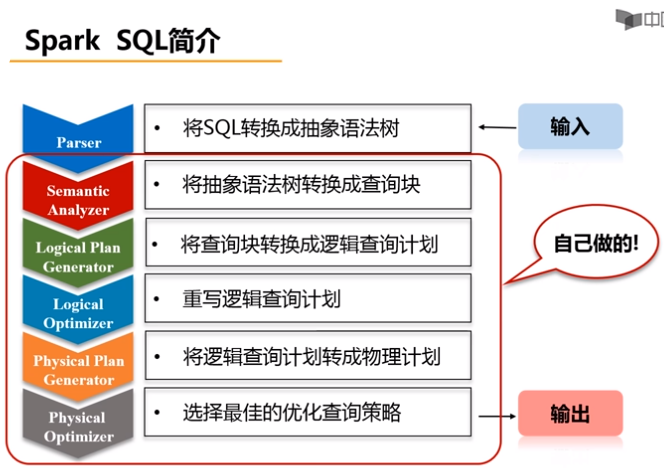
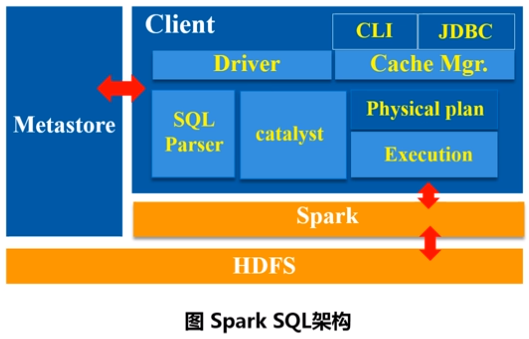
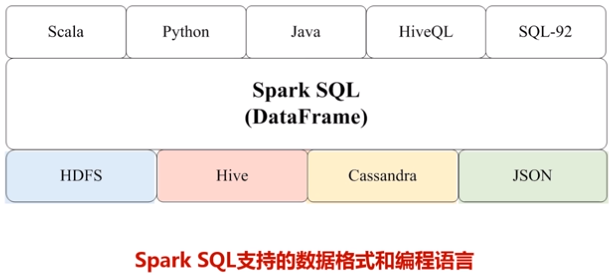
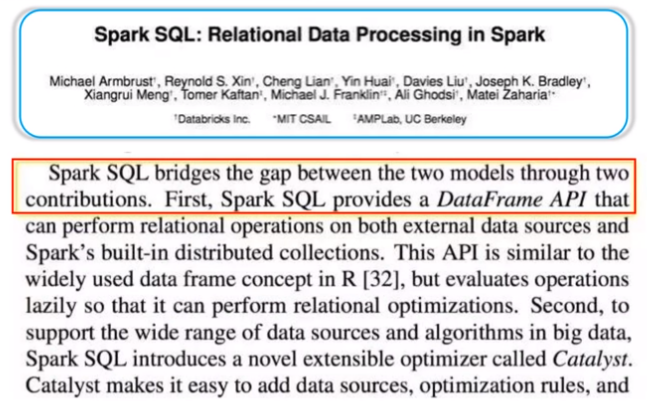
Spark SQL在Hive兼容层面仅依赖HiveQL解析、Hive元数据,也就是说,从HQL被解析成抽象语法树(AST)起,就全部由Spark SQL接管了。Spark SQL执行计划生成和优化都由Catalyst(函数式关系查询优化框架)负责。(Spark SQL除了沿用Parser(把SQL转换成抽象语法树)这一个模块外,其他模块全部自己定义。)

三、为什么推出Spark SQL
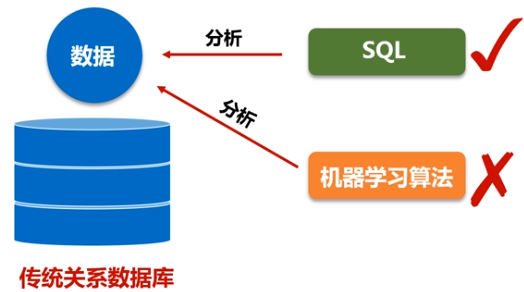
(1)关系型数据库中只存储了一部分的结构化数据,但是实际上现在要处理的相关数据类型不仅仅包括关系数据库,现在大数据时代90%的数据都是非结构化数据和半结构化数据,对于这种数据,不能用SQL语句分析。而spark SQL同时支持非结构化、半结构化、结构化数据分析。


(2)关系型数据库没有办法处理类似机器学习和图像处理的图结构数据
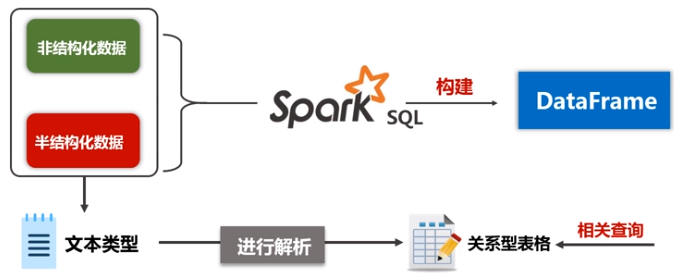
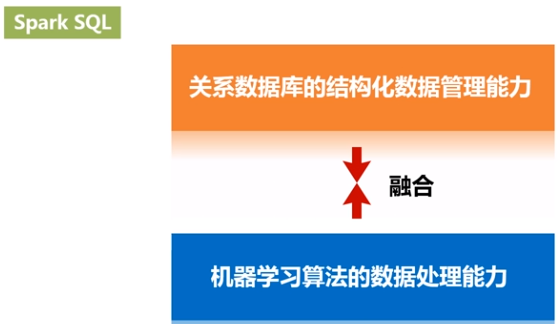
Spark SQL可以有效地把关系数据查询和复杂分析算法融合。
参考文献:
6.1 Spark SQL的更多相关文章
- Spark SQL 之 Data Sources
#Spark SQL 之 Data Sources 转载请注明出处:http://www.cnblogs.com/BYRans/ 数据源(Data Source) Spark SQL的DataFram ...
- Spark SQL 之 DataFrame
Spark SQL 之 DataFrame 转载请注明出处:http://www.cnblogs.com/BYRans/ 概述(Overview) Spark SQL是Spark的一个组件,用于结构化 ...
- 【原】Learning Spark (Python版) 学习笔记(三)----工作原理、调优与Spark SQL
周末的任务是更新Learning Spark系列第三篇,以为自己写不完了,但为了改正拖延症,还是得完成给自己定的任务啊 = =.这三章主要讲Spark的运行过程(本地+集群),性能调优以及Spark ...
- Spark 官方文档(5)——Spark SQL,DataFrames和Datasets 指南
Spark版本:1.6.2 概览 Spark SQL用于处理结构化数据,与Spark RDD API不同,它提供更多关于数据结构信息和计算任务运行信息的接口,Spark SQL内部使用这些额外的信息完 ...
- Spark SQL Example
Spark SQL Example This example demonstrates how to use sqlContext.sql to create and load a table ...
- 通过Spark SQL关联查询两个HDFS上的文件操作
order_created.txt 订单编号 订单创建时间 -- :: -- :: -- :: -- :: -- :: order_picked.txt 订单编号 订单提取时间 -- :: ...
- Spark SQL 之 Migration Guide
Spark SQL 之 Migration Guide 支持的Hive功能 转载请注明出处:http://www.cnblogs.com/BYRans/ Migration Guide 与Hive的兼 ...
- Spark SQL 官方文档-中文翻译
Spark SQL 官方文档-中文翻译 Spark版本:Spark 1.5.2 转载请注明出处:http://www.cnblogs.com/BYRans/ 1 概述(Overview) 2 Data ...
- Spark SQL 之 Performance Tuning & Distributed SQL Engine
Spark SQL 之 Performance Tuning & Distributed SQL Engine 转载请注明出处:http://www.cnblogs.com/BYRans/ 缓 ...
- 基于Spark1.3.0的Spark sql三个核心部分
基于Spark1.3.0的Spark sql三个核心部分: 1.可以架子啊各种结构化数据源(JSON,Hive,and Parquet) 2.可以让你通过SQL,saprk内部程序或者外部攻击,通过标 ...
随机推荐
- 微信小程序中换行,空格(多个空格)写法
在小程序中HTML的网页实体无法正常使用,小程序中的写法为: 一.空格,换行 <text>你好!\t七月流火啊!\n我在下一行</text> \t 空格( 多个只会显示一个空格 ...
- promise 和 setTimeout 在任务队列的执行顺序
setTimeout(() => { console.log() }); const a = new Promise((resolve,reject)=>{ console.log(); ...
- prerender-spa-plugin预渲染踩坑
为什么要使用预渲染? 为了应付SEO(国内特别是百度)考虑在网站(vue技术栈系列)做一些优化.大概有几种方案可以考虑: 服务端做优化: 第一,ssr,vue官方文档给出的服务器渲染方案,这是一套完整 ...
- python3中的数字类型
今天在学校机房刷python题时发现自己对python中的数字类型不理解,回寝室后百度一下. 现在做一个总结. python中的数字类型有: 整数,布尔值,复数,科学计数法,浮点数 1,整数,大小没有 ...
- 在新的电脑上的Git本地库 与远程库关联前的一些设置
由于你的本地Git仓库和GitHub仓库之间的传输是通过SSH加密的,所以,需要一点设置: 第1步:创建SSH Key.在用户主目录下(user/...),看看有没有.ssh目录,如果有,再看看这个目 ...
- 使用zabbix监控oracle的后台日志
本文将介绍如何使用zabbix监控oracle的后台日志,当oracle后台日志出现“ORA-”或“Error”时,第一时间将该信息报警出来 zabbix agent端 以下所有操作均用root执行 ...
- 红黑树之 原理和算法详细介绍(阿里面试-treemap使用了红黑树) 红黑树的时间复杂度是O(lgn) 高度<=2log(n+1)1、X节点左旋-将X右边的子节点变成 父节点 2、X节点右旋-将X左边的子节点变成父节点
红黑树插入删除 具体参考:红黑树原理以及插入.删除算法 附图例说明 (阿里的高德一直追着问) 或者插入的情况参考:红黑树原理以及插入.删除算法 附图例说明 红黑树与AVL树 红黑树 的时间复杂度 ...
- 2018-8-10-win10-uwp-关联文件
原文:2018-8-10-win10-uwp-关联文件 title author date CreateTime categories win10 uwp 关联文件 lindexi 2018-08-1 ...
- VS 自动创建带增删查改的MVC网站
VS 自动创建带增删查改的MVC网站 MVC.Net教程 废话放在前头,说一下这个文章的缘起某天某妹纸找我,说这个MVC的创建不太会,要记一下controllers.models.还有页面引用的东 ...
- python 对Unicode解码
打印: print('我喜欢你'.encode('unicode_escape')) 得到Unicode编码: b'\\u6211\\u559c\\u6b22\\u4f60 将上面的编码赋值给str后 ...