
03爬虫-requests模块基础(1)
requests模块基础
什么是requests模块 requests模块是python中原生基于网络模拟浏览器发送请求模块。功能强大,用法简洁高效。
为什么要是用requests模块
- 用以前的urllib模块需要手动处理url编码
- 手动处理post参数
- 处理cookie和代理操作繁琐
..............
requests模块
- 自动处理url编码
- 自动处理post参数
- 简化cookie和代理操作
...............
如何使用requests模块
- 安装:
- pip install requests
- 使用流程
- 指定url
- 基于requests模块发起请求
- 获取响应对象中的数据值
- 持久化存储
- 安装:
- 1、基于requests模块的get请求 需求:爬取搜狗指定词条搜索后的页面数据
 import requests

 #指定url

 base_url = "https://www.sogou.com/web"

 #搜索词条的关键字

 query = {

     "query":"python"

 }

 #模仿User-Agent(伪造电脑版本信息以及什么浏览器信息)

 headers = {

     "User-Agent":"Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.100 Safari/537.36"

 }

 #requests.get(url, params=None, **kwargs),第一个是url地址,第二个关键字参数。

 response = requests.get(url=base_url,params=query,headers=headers)

 #因为发送的是get方式 所以返回的是一个字符串,即text可得相关html标签页

 print(response.text)
2、基于requests模块ajax的get请求 需求:爬取豆瓣电影分类排行榜 https://movie.douban.com/中的电影详情数据
 import requests

 url = "https://movie.douban.com/j/chart/top_list"

 #根据需求取数据

 start = input("enter start:")

 limit = input("enter limt:")

 #请求头里面的请求关键字

 param = {

 "type": "",

 "interval_id": "100:90",

 "action": "",

 "start": start,

 "limit": limit,

 }

 #伪造机型和浏览器

 headers = {

     "User-Agent":"Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.100 Safari/537.36",

 }

 #开始get请求,因为是ajax的get方法所以请求应该是get

 response = requests.get(url=url,params=param,headers=headers)

 #返回的是一个json数据,因此要用json解析

 print(response.json())
3、基于requests模块ajax的post请求 需求:爬取肯德基餐厅查询http://www.kfc.com.cn/kfccda/index.aspx中指定地点的餐厅数据
 import requests

 url = "http://www.kfc.com.cn/kfccda/ashx/GetStoreList.ashx?op=keyword"

 #输入保存信息地点

 keyword = input("enter a word:")

 #请求头里面的请求关键字

 for i in range(1,9):

     data = {

         "cname":"",

     "pid": "",

     "keyword": keyword,

     "pageIndex": i,

     "pageSize": "",

     }

     #伪造机型和浏览器

     headers = {

         "User-Agent":"Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.100 Safari/537.36",

     }

     #因为是ajax的post方法所以post请求

     response = requests.post(url=url,data=data,headers=headers)

     #响应的是一个text数据,因此要用text解析

     fileName = str(i)+".txt"

     with open(fileName,"w",encoding="utf8") as f:

         f.write(response.text)
显示文件有:
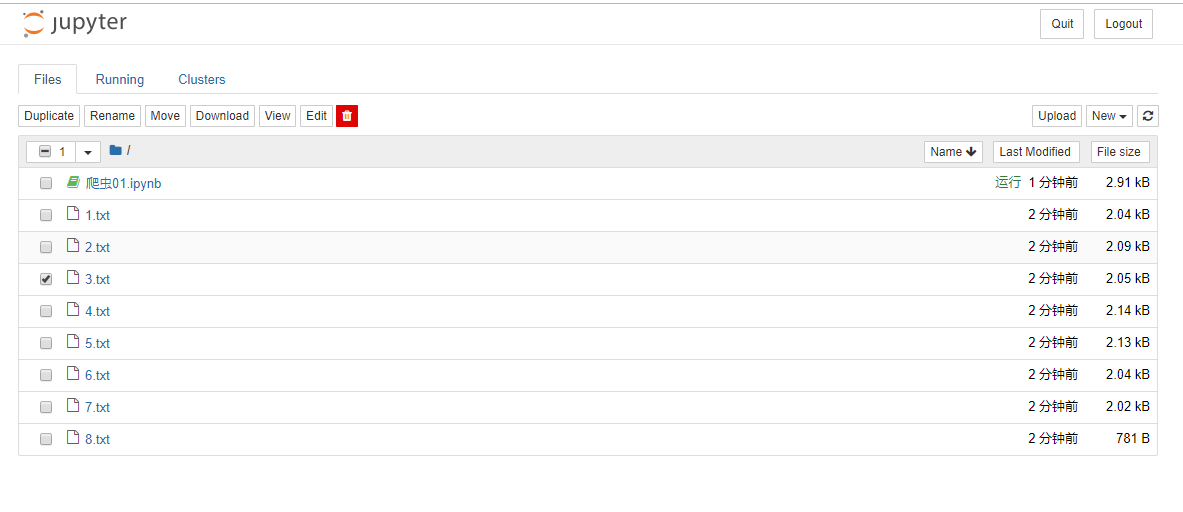
4、综合练习 需求:爬取国家药品监督管理总局中基于中华人民共和国化妆品生产许可证相关数据http://125.35.6.84:81/xk/
 import requests

 url = "http://125.35.6.84:81/xk/itownet/portalAction.do?method=getXkzsList"

 ID_list = []

 # 伪造机型和浏览器

 headers = {

     "User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.100 Safari/537.36",

 }

 for i in range(1,16):

     data = {

     "on": "true",

     "page": i,

     "pageSize": "",

     "productName": "",

     "conditionType": "",

     "applyname": "",

     "applysn": "",

     }

     #因为是ajax的post方法所以post请求

     response = requests.post(url=url,data=data,headers=headers).json()

     ID_list.append(response["list"][0]["ID"])

 base_url = "http://125.35.6.84:81/xk/itownet/portalAction.do?method=getXkzsById"

 for i in ID_list:

     data = {

         "id": i,

     }

     # 响应的是一个json数据,因此要用json解析

     response = requests.post(url=base_url,data=data,headers=headers)

     print(response.json())
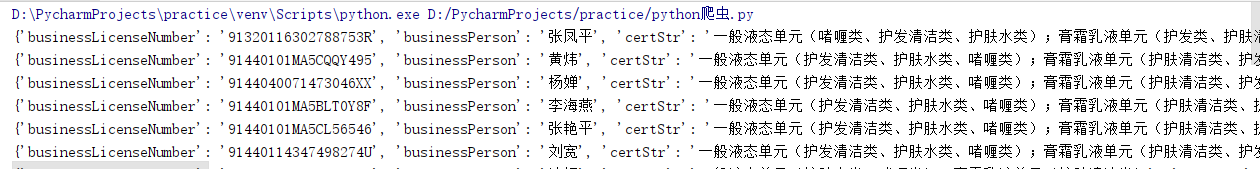
Jupyter notebook应该是库出问题了,找了很久都没弄到原因,还一直以为自己代码出现问题了。换到pycharm成功运行
03爬虫-requests模块基础(1)的更多相关文章
- 05爬虫-requests模块基础(2)
今日重点: 1.代理服务器的设置 2.模拟登陆过验证码(静态验证码) 3.cookie与session 4.线程池 1.代理服务器的设置 有时候使用同一个IP去爬取同一个网站,久了之后会被该网站服务器 ...
- 爬虫之requests模块基础
一.request模块介绍 1. 什么是request模块 - python中原生的基于网络请求的模块,模拟浏览器发起请求. 2. 为什么使用request模块 - urllib需要手动处理url编码 ...
- 03 requests模块基础
1. requests 模块简介 什么是requests 模块 requests模块是python中原生的基于网络请求的模块,功能强大,用法简洁高效.在爬虫领域中占据着半壁江山的地位.requests ...
- 爬虫requests模块 1
让我们从一些简单的示例开始吧. 发送请求¶ 使用 Requests 发送网络请求非常简单. 一开始要导入 Requests 模块: >>> import requests 然后,尝试 ...
- 爬虫 requests模块的其他用法 抽屉网线程池回调爬取+保存实例,gihub登陆实例
requests模块的其他用法 #通常我们在发送请求时都需要带上请求头,请求头是将自身伪装成浏览器的关键,常见的有用的请求头如下 Host Referer #大型网站通常都会根据该参数判断请求的来源 ...
- 爬虫——requests模块
一 爬虫简介 #1.什么是互联网? 互联网是由网络设备(网线,路由器,交换机,防火墙等等)和一台台计算机连接而成,像一张网一样. #2.互联网建立的目的? 互联网的核心价值在于数据的共享/传递:数据是 ...
- 2 爬虫 requests模块
requests模块 Requests是用python语言基于urllib编写的,采用的是Apache2 Licensed开源协议的HTTP库,Requests它会比urllib更加方便,reques ...
- 爬虫--requests模块高级(代理和cookie操作)
代理和cookie操作 一.基于requests模块的cookie操作 引言:有些时候,我们在使用爬虫程序去爬取一些用户相关信息的数据(爬取张三“人人网”个人主页数据)时,如果使用之前requests ...
- 爬虫--requests模块学习
requests模块 - 基于如下5点展开requests模块的学习 什么是requests模块 requests模块是python中原生的基于网络请求的模块,其主要作用是用来模拟浏览器发起请求.功能 ...
随机推荐
- Hive 系列(七)—— Hive 常用 DML 操作
一.加载文件数据到表 1.1 语法 LOAD DATA [LOCAL] INPATH 'filepath' [OVERWRITE] INTO TABLE tablename [PARTITION (p ...
- 纯 CSS 实现绘制各种三角形(各种角度)
一.前言 三角形实现原理:宽度width为0:height为0:(1)有一条横竖边(上下左右)的设置为border-方向:长度 solid red,这个画的就是底部的直线.其他边使用border-方向 ...
- [AI] 论文笔记 - CVPR2018 Super SloMo: High Quality Estimation of Multiple Intermediate Frames for Video Interpolation
写在前面 原始视频(30fps) 补帧后的视频(240fps) 本文是博主在做实验的过程中使用到的方法,刚好也做为了本科毕设的翻译文章,现在把它搬运到博客上来,因为觉得这篇文章的思路真的不错. 这篇文 ...
- idea使用springboot的webservice基于cxf
SpringBoot整合CXF实例: 服务端构建 <dependency> <groupId>org.apache.cxf</groupId> <artifa ...
- HBase 系列(十一)—— Spring/Spring Boot + Mybatis + Phoenix 整合
一.前言 使用 Spring+Mybatis 操作 Phoenix 和操作其他的关系型数据库(如 Mysql,Oracle)在配置上是基本相同的,下面会分别给出 Spring/Spring Boot ...
- 80后,天才程序员, Facebook 第一任 CTO,看看开挂的人生到底有多变态?
鸡仔说:今天介绍一位天才程序员--亚当·德安格洛(Adam D'Angelo),他被<财富>杂志誉为"科技界最聪明的人之一",大学去了被誉为"天才" ...
- windows下 ionic 打包app --以安卓版本为例
环境安装 1.nodejs 安装版本5.7,尽量不要安装太新的版本,因为可能会出现兼容性问题,一开始本人安装的是6.+的版本,后来出现问题的,马上换回5.7的,问题就不会出现了. 安装教程网上教程很多 ...
- python学习——函数参数
一.为什么要使用函数 函数能提高应用的模块性,和代码的重复利用率. 二.函数的参数 位置参数:从左至右进行匹配 一般情况,也就是我们迄今为止最常用的方法,是通过位置进行匹配把参数值传递给函数头部的参数 ...
- unity编辑器扩展_02(分别在Hierarchy,Project中创建一个选项)
在Hierarchy面板创建选项的代码: [MenuItem("GameObject/Test",false,1)] static void Test1() { ...
- Nginx反向服务器搭建
Nginx环境搭建 下载解压Nginx源码包 可以通过已有的压缩包 这里也可以通过yum的在线下载 wget http://nginx.org/download/nginx-1.13.7.tar.gz ...